さくらのレンタルサーバでホスティングしていたサイトの大部分を自宅サーバーに移行した

今日は遂に運営サイトの大半をさくらのレンタルサーバーから自宅サーバーへ移行することに成功した。

自宅サーバーでの個人サイト運営は中学時代からの夢だったので、悲願が叶ったようでちょっと嬉しい。

移行したサイトなど

次のサイトやサービスを移行した。

  • lycolia.info - lycolia.info
    • エントランスページ、LPみたいなもん
  • Lycolog - blog.lycolia.info
    • このブログ。このブログは2019年より前のログがないが、実はこのサイトは元からブログとして発祥している。当時はブログという概念はなく、日記サイトだった
  • Webツール置き場 - tool.lycolia.info
    • 適当に作った便利ツールを置いている
  • ECO-Wiki (lycolia) - eco.lycolia.info
    • 最近一言BBSへの書き込みがないのが気がかりなWiki。実はアクセスは落ちてない
  • アクセス解析 Matomo
  • TinyTinyRSS

やったこと

さくらのレンタルサーバから自宅サーバーへファイルを移設し、権限を設定

# サイト単位にtarballに固める
tar -cf hoge.tar hoge
# Windows上のRLoginを使って、NASとしてマウントしている自宅サーバーに転送
cp hoge.tar <ホスティングファイル置き場>
tar -xf hoge.tar hoge
# Apacheから見えるように
chown -R www-data:www-data <ホスティングファイル置き場>/hoge
# www-dataに属するユーザーがいじれるように
chmod -R g+rxw <ホスティングファイル置き場>/hoge

cgi-binフォルダを使っているスクリプトの対策

詳細はトラブルシューティングの該当項目参照

ヘッダーモジュールの有効化

使ってるやつがいたので有効化。

sudo a2enmod headers

さくらのレンタルサーバのMySQLからDBをダンプし、自宅サーバーのMariaDBに取り込み

sudo mysql -u <ユーザー名>
CREATE DATABASE <DB名>;
exit
# 照合順序をMariaDB方式に変換
sed -i 's/utf8mb4_0900_ai_ci/utf8mb4_general_ci/g' ~/hoge.sql
sudo mysql <DB名> < ~/hoge.sql

nginxとApache2の設定を追加

この設定の前提として/etc/nginx/nginx.confにupstreamの設定を足す必要がある。

nginx -> Apache2の構成にしているので、これの設定。基本的にレンサバでホスティングしていたものはApacheの上にのせておくと色々と楽だ。.htaccessは神だし、静的ファイルやCGIのホスティングをする場合、Apacheは取り回しがとても良い。

  1. /etc/nginx/conf.d/にサイトごとのリバプロの設定を置く。一例としてはこんな感じ

    server {
        listen 443 ssl;
        listen [::]:443 ssl;
        server_name  eco.lycolia.info;
    
        client_max_body_size 100M;
    
        ssl_certificate     /etc/letsencrypt/live/lycolia.info/fullchain.pem;
        ssl_certificate_key /etc/letsencrypt/live/lycolia.info/privkey.pem;
    
        location / {
            proxy_pass http://apache/;
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-Proto $scheme;
        }
    }
    
  2. /etc/apache2/sites-enabled/にもサイトごとの設定を書く。一例としてはこんな感じ

    <VirtualHost *:8080>
            ServerName eco.lycolia.info
    
            ServerAdmin webmaster@localhost
            DocumentRoot /var/www/path/to
    
            # Available loglevels: trace8, ..., trace1, debug, info, notice, warn,
            # error, crit, alert, emerg.
            # It is also possible to configure the loglevel for particular
            # modules, e.g.
            #LogLevel info ssl:warn
    
            ErrorLog ${APACHE_LOG_DIR}/eco-error.log
            CustomLog ${APACHE_LOG_DIR}/eco-access.log combined
    </VirtualHost>
    

このリバプロの設定の意味合いについては過去に書いたnginxからApache2のバーチャルホストにいい感じにリバプロする方法、nginxからApache2へセキュアにリバプロしたときに真のクライアントIPを取得できるようにするを参照。

perlとphpのパスにエイリアスを作る

これをしてないと実行時エラーになる。

sudo ln -s /usr/bin/perl /usr/local/bin/perl
sudo ln -s /usr/bin/php /usr/local/bin/php

SSIの有効化

今時SSIを使ってる人なんてまずいないと思うが、令和最新版ということで…。

やり方

  1. SSIモジュールを有効化する
    sudo a2enmod include
    
  2. /etc/apache2/apache2.confを開き、全域でSSIを有効化。ついでにDirectoryIndexにも入れとく。SSIの設定はDirectoryディレクティブの中でないと効かない
    <Directory /var/www/>
            AllowOverride All
            DirectoryIndex index.php index.cgi index.shtml index.html index.txt
            # Optionsに+Includesの部分を追加する
            Options +ExecCGI -MultiViews +SymLinksIfOwnerMatch +Includes
            AddHandler cgi-script .cgi
            Require all granted
    </Directory>
    

.shtmlの場合にSSIを許可するように管理しているのは恐らく/etc/apache2/mods-enabled/mime.confだと思われる。ここでMIME-TYPEも付与していると思われる。

バーチャルホストやんいやパス単位にしたい場合は適当なDirectoryディレクティブにOptions +Includesを書けば機能する。

余談だがSSIはエントランスページの更新日時を出すのに使っていて、過去に記事のネタにしたこともある。

アプリケーションのDBの向き先を変更

移設したMatomoとTTRSSは共にMySQLを使っていたためMySQLの接続情報を書き換えた。

DBの接続先はlocalhostでなく、127.0.0.1でないと上手くいかなかった。::1も通らなかったため、恐らくIPv6でListenしていないのだと思う。

Matomoの設定

  1. 無限リダイレクト抑制のためconfig/config.ini.phpのeneralセクションにassume_secure_protocol = 1を追加する。詳細はトラブルシューティングの該当項目参照
  2. gd2以上を入れろと言われるので使っているPHPのバージョンにあったものを入れる
    sudo apt install php8.3-gd
    
  3. MySQLのmax_allowed_packetが少なすぎると言われるので/etc/mysql/my.cnfを開きmysqldセクションに設定を足す
    [mysqld]
    + max_allowed_packet=64MB
    

CRONの移行

ttrssとmatomoのCRONを移行。

0 * * * * /usr/local/bin/php /path/to/ttrss/update.php --feeds --quiet 1> /dev/null
0 * * * * /usr/local/bin/php /path/to/analytics/console core:archive --url=https://analytics.lycolia.info/ 1> /dev/null

ドメインの切り替え

  1. Value-DomainのDNS管理画面を開き、移設したドメインを全て自宅サーバーに向けた
  2. 移設前はAレコードとMXレコードのIPが同一だが、今回からAレコードとMXレコードのIPが変わるので分離した。これで合っているのか怪しいが一応メールが届くことは確認している
    +mx mx.lycolia.info. 10
    +a mx 133.167.8.98
    +aaaa mx 2403:3a00:101:13:133:167:8:98
    - mx lycolia.info. 10
    -a 133.167.8.98
    -aaaa 2403:3a00:101:13:133:167:8:98
    +aaaa @ 2400:4153:8f01:c800:c14b:3f7a:2b54:353a
    +a @ 133.167.8.98
    
  3. 今回移設したドメインを対象にvalue-domain-dns-utilのvd-ddns-v4.plでDDNSを行う設定を追加

トラブルシューティング

cgi-binを含むパスが/usr/lib/にマップされた

例えば/var/www/html/hoge/cgi-bin/mgcount/mgcount.cgiを実行すると/usr/lib/cgi-bin/mgcountを叩こうとしてコケる問題と出会った。

実際に出たログの一例としては以下のような状態だった(IPはマスクしているが他はそのまま)

[Wed Jun 03 21:02:12.751027 2026] [cgid:error] [pid 865047] [client xxxx:xxxx:xxxx:xxxx:xx:xxxx:x:x:x] AH01264: script not found or unable to stat: /usr/lib/cgi-bin/mgcount, referer: https://lycolia.info/index.shtml

これはどうも規定ではcgi-binが入ったパスを/usr/lib/cgi-bin/にバインドする振る舞いがあるらしく、sites-enabled/の設定に次の記述をすることで正しいパスを呼び出すことができるようになった。

<VirtualHost *:8080>
        ServerName hoge.lycolia.info

        ServerAdmin webmaster@localhost
        DocumentRoot /var/www/html/hoge

        # Available loglevels: trace8, ..., trace1, debug, info, notice, warn,
        # error, crit, alert, emerg.
        # It is also possible to configure the loglevel for particular
        # modules, e.g.
        #LogLevel info ssl:warn

        ErrorLog ${APACHE_LOG_DIR}/hoge-error.log
        CustomLog ${APACHE_LOG_DIR}/hoge-access.log combined

        # ScriptAliasで既存のバインドを上書きする
        ScriptAlias /cgi-bin/ /var/www/html/hoge/cgi-bin/
</VirtualHost>

ダンプ取り込み時にERROR 1273 (HY000) at line 30: Unknown collation: 'utf8mb4_0900_ai_ciが出る

MySQLとMariaDBで照合順序の名前が違うらしいのでダンプファイルをMariaDB流で置換する。

sed -i 's/utf8mb4_0900_ai_ci/utf8mb4_general_ci/g' ~/hoge.sql

MySQLを叩くCGI実行時にException while creating PDO object:SQLSTATE[HY000] [2002] Connection refusedが出る

DBに繋がっていないのが原因。ポート番号やIDPWなどに間違いがなく、ローカルDBに繋ぐ場合、DBの接続先をlocalhostでなく、127.0.0.1にすれば直る。

CGI実行時にEnd of script output before headers: hoge.cgi,が出る

これはHeaderを吐く前にエラーが標準出力されているので出るエラーと思われる。昔PHPやってた人にはお馴染みのやつ。

Shebangに書かれているパスにPerlがないのが原因なのでShebangのパスを見てそこにシンボリックリンクを張っておく。

sudo ln -s /usr/bin/perl /usr/local/bin/perl

.htaccess: Invalid command 'Header', perhaps misspelled or defined by a module not included in the server configuration

ヘッダーモジュールを有効化する。

sudo a2enmod headers

nginx -> Apache2のリバプロ環境でMatomoが無限リダイレクトしたり、エラーログを吐きまくる

一般的に内部リバプロはhttpで送るが、これが原因。

Matomoはhttpリクエストをhttpsにリダイレクトするが、リバプロがhttpでリクエストしてくるため無限ループになって発生する。MatomoのGitHubリポジトリのIssueに山ほどある問題。

解消法としては以下の様にconfig/config.ini.phpのGeneralセクションでassume_secure_protocol = 1を設定すればよい。

 [General]
+assume_secure_protocol = 1

504エラーが出たり、やたらめったら凄く重い

アクセスが集中してるときにMatomoがDBエラーを吐いてるとAMD Ryzen 5 8500Gでメモリ32GBのNVMe SSDを積んだマシンですら504が出る程度には重かった。

エラーを潰したら平和になった。

ビジットの外観のミニグラフが出ない
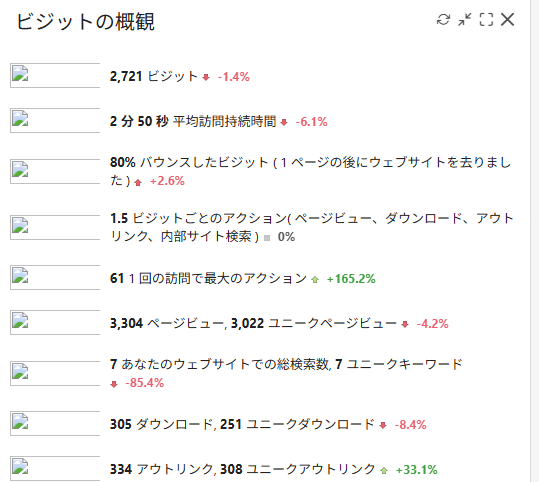
GD2以降が必要なのでPHPのバージョンにあったものを入れる。

sudo apt install php8.3-gd

あとがき

2017年から自宅サーバーをマイペースに運用しており、初期はSSHDを立てただけの簡易NASやシンクラ環境として使っていたが、去年からMastodonの運用をはじめ、中学のころの夢だった鯖缶になることができた。そして更に今回、死活監視用に確保しているサイト(未構築)を除き、全てのサイトを自鯖に移行できたので、まさに中学生のころに夢見た、Webサイトを運用する鯖缶になることができ、感激もひとしおだ。
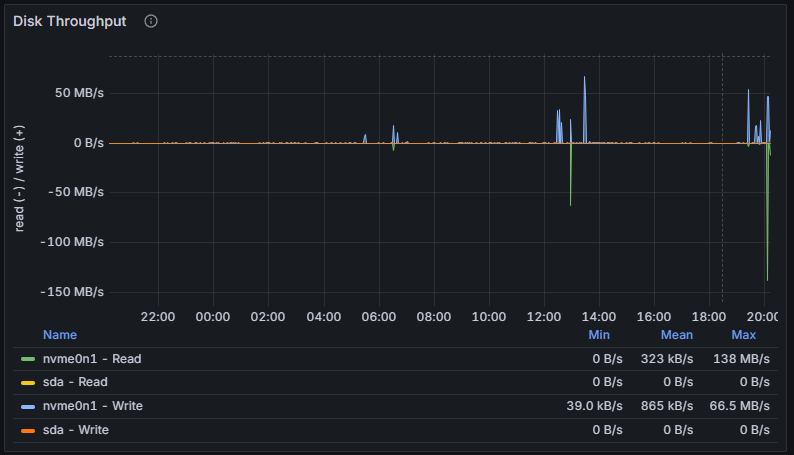
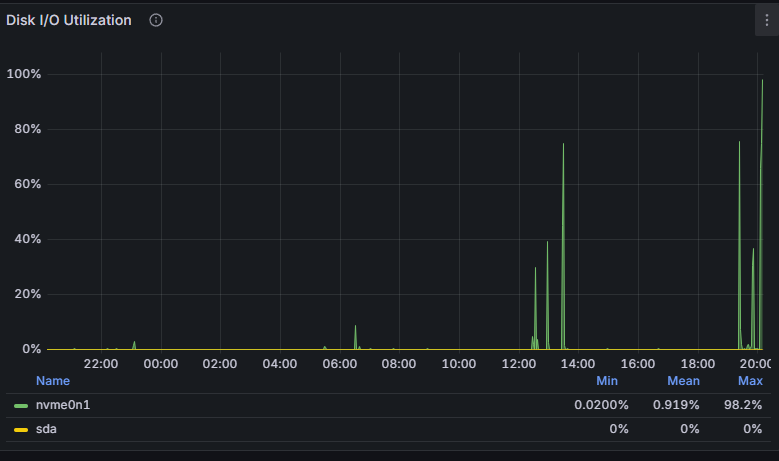
移設作業中は通信トラフィックやディスクI/Oが一気に跳ね上がったりだとか、CPUやメモリも結構頑張っていて、運用しているMastodonがやたら重くなったのが印象的だった。

何せこのブログだけでファイル数15,197の容量13GBもあるのだから無理もない。

あと移設作業中にadiaryのOGPが出なくてなんでだ?と思ったら、HTTPSの判定処理に漏れがあり、HTTPでURLが出ていたので、リバプロのヘッダもみるように改修した。実装上、リバプロしていない場合に子のヘッダが送られてきてもHTTPSになってしまうが、困るのはそんな不正な要求を送った本人なので、特に問題ないだろう。

さて、ここまで来たら次は以前も話に出した、Anubisを導入してWAFを掛けたり、現在日々増強中の監視体制の強化を続けていくなどして、自作サーバーライフを楽しんでいきたいところだ。

振り返ってみたら2025/08/21から今日までの間になんと三回も言及しており、これで四回目らしい。草。

特に意味はないが、過去にあったAnubisへの言及を以下にまとめてみた。

なんと言うか一年くらい塩漬けにしていたプロジェクトが最近はじわじわ進んでいる気がしていて、非常に清々しい。

そういえばadiaryをサーバーモードで動かすと早いという話があるので、そっちも試してみたいところだ。これは最近記事の増加に伴い中々重くなってきているのを感じているからだ。

やりたい事がたくさん湧いてくるのは充実していてとても良い。
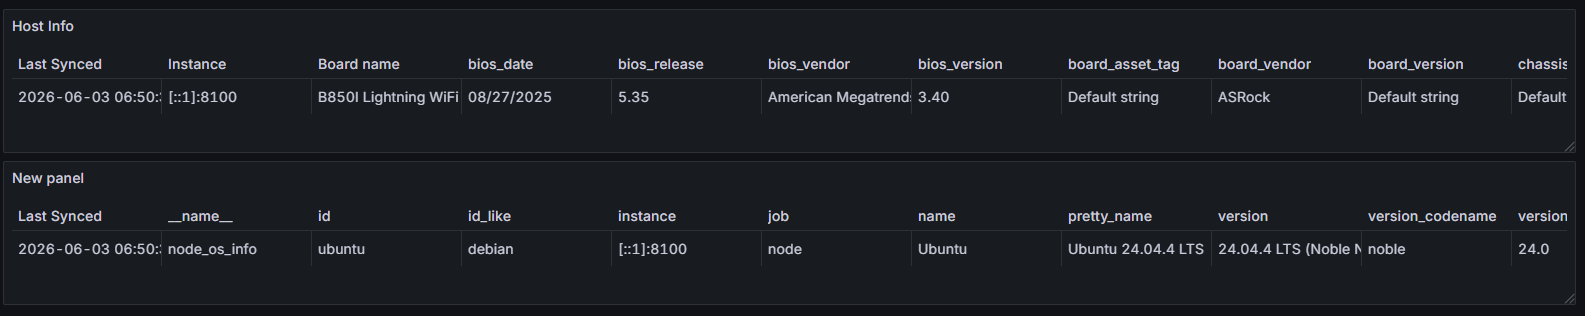
Grafanaのダッシュボードに端末情報を出す方法

監視対象のスペックを確認するのに便利かも…?

確認環境

Env Ver
Ubuntu 24.04.3 LTS
Prometheus 3.5.0
Grafana v12.1.1
Node exporter 1.9.1

やり方

  1. Dashboardを開く
  2. 右上のボタンからEditモードに入る
  3. Add->Visualization
  4. 次の要領で設定する

    項目 状態
    Visualization Table
    Table view ON
    Queries Codeを選択しnode_os_info或いはnode_dmi_info
    Add field override ボタンを押して一個追加する

    Override 1

    項目 状態
    Fields with name Time
    Standard options > Display name Last Synced
  5. Refreshボタンを押すと完成するのでSave dashboardしたら出てくる

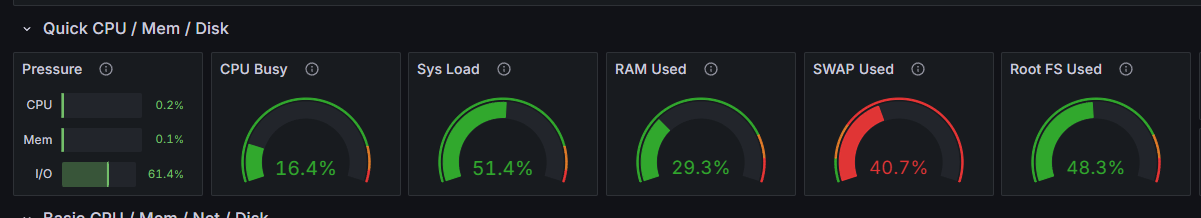
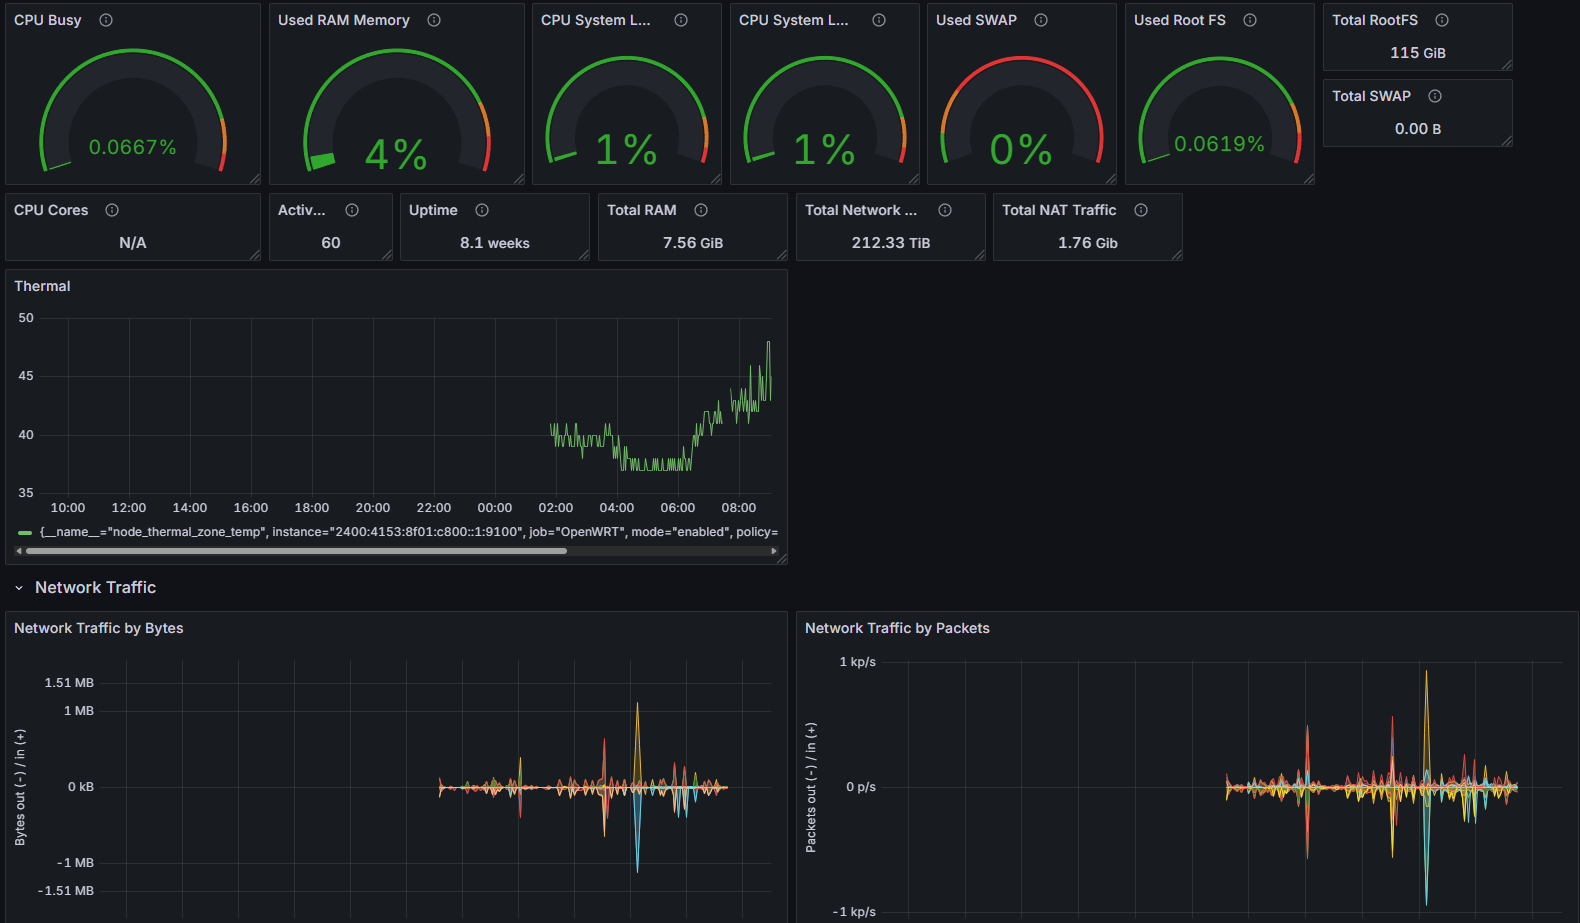
OpenWrtのメトリクスとログをGrafanaで雑に見れるようにした

OpenWrtのメトリクスやログをUbuntu側のGrafanaで見れるようにするまで。

メトリクスの取得にはPrometheus、ログはLokiを使っている。

確認環境

監視する側

Env Ver
Ubuntu 24.04.3 LTS
Prometheus 3.5.0
Grafana v12.1.1
Loki 3.5.9

監視される側

Env Ver
OpenWrt 24.10.0
Prometheus 3.5.0
prometheus-node-exporter-lua 2025.07.15-r1
prometheus-node-exporter-lua-nat_traffic 2025.07.15-r1
prometheus-node-exporter-lua-netstat 2025.07.15-r1
prometheus-node-exporter-lua-openwrt 2025.07.15-r1
prometheus-node-exporter-lua-thermal 2025.07.15-r1
perl 5.40.0-r2
perlbase-json-pp 5.40.0-r2
perlbase-http-tiny 5.40.0-r2
perl-time-moment 0.44.5.40-r1

Prometheusでメトリクスを取得してGrafanaで見れるようにする

ほぼOpenWRT | Grafana Labsに書いてある通り。

  1. 必要なパッケージをインストールする
    opkg update
    opkg install \
       prometheus-node-exporter-lua \
       prometheus-node-exporter-lua-nat_traffic \
       prometheus-node-exporter-lua-netstat \
       prometheus-node-exporter-lua-openwrt \
       prometheus-node-exporter-lua-thermal
    
  2. /etc/config/prometheus-node-exporter-luaを以下のように編集する
    config prometheus-node-exporter-lua 'main'
    +         option listen_interface 'lan'
    -         option listen_interface 'loopback'
            option listen_port '9100'
            #option cert '/etc/uhttpd.crt'
            #option key '/etc/uhttpd.key'
    
  3. prometheus-collectors/filesystem.luaとprometheus-collectors/meminfo.luaを拾ってきて/usr/lib/lua/prometheus-collectorsに配置する
  4. サービスを再起動
    /etc/init.d/prometheus-node-exporter-lua restart
    
  5. /etc/prometheus/prometheus.yaml
    - job_name: "OpenWRT"
      static_configs:
        - targets: ['xxxx:xxxx:xxxx:xxxx::1:9100']
    
  6. Prometheus再起動
    sudo systemctl restart prometheus.service
    
  7. 取れるメトリクスの一覧
    curl 'http://[xxxx:xxxx:xxxx:xxxx::1]:9100/metrics'
    
  8. Grafanaのダッシュボードを作成しID: 18153を取り込む
  9. WiFi関係使ってないので全消し
  10. Used SWAPのQueriesを以下のように書き換えて0除算でエラーが出ないようにする
    (
     (
       (node_memory_SwapTotal_bytes{instance=~"$node:$port",job=~"$job"} - node_memory_SwapFree_bytes{instance=~"$node:$port",job=~"$job"})
       /
       (node_memory_SwapTotal_bytes{instance=~"$node:$port",job=~"$job"} > 0)
     ) * 100
    )
    or
    (node_memory_SwapTotal_bytes{instance=~"$node:$port",job=~"$job"} * 0)
    

細かい部分の整理はまた追々として、いい感じに見れるようになった気がする。

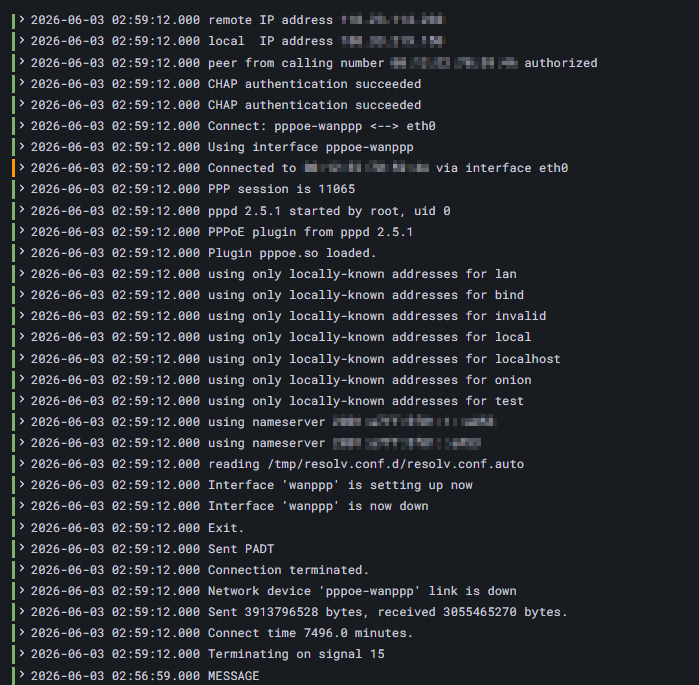
ログをLokiに送る

Loki exporter for OpenWRTが動かないので自作した。

  1. OpenWrtのログをLokiに送るやつを拾ってくる
  2. インストール方法にある通りにファイルを配置、設定ファイルをいじる
  3. Lokiにログが飛んでればOK
    • ログが飛んでいない場合は/tmp/openwrt-loki.errの中身を見てエラーがないか見る

一旦こんな感じで見れるようになった。

既知の問題

複数行のエラーログがLoki上で別のログになる

親子関係を作ってないせい。Claude Opus 4.8には難しいようだったので、そのうち作る。

おまけ:Lokiにログを投げる方法

POST /loki/api/v1/pushを叩けばよい。ペイロードは以下の書式。

LokiのAPIペイロード

{
  "streams": [
    {
      "stream": {
        "label": "value"
      },
      "values": [
          [ "<unix epoch in nanoseconds>", "<log line>", { "hoge": "aaaa", "fuga": "1234" } ],
          [ "<unix epoch in nanoseconds>", "<log line>", { "hoge": "bbbb", "fuga": "2345" } ]
      ]
    }
  ]
}

ペイロードの意味合い

nginxのログはペイロードしか入ってなかったりするがどうやって実現してるのか不明。もしかするとvalues[1]にJSONを突っ込んでるのかもしれない。

項目 意味合い
streams よくわかってない
stream この配下に検索用のラベルをぶら下げる。jobとかlevel、hostとかを入れとくとよいと思われる
values ログの本体を入れる
values[0] ナノ秒まで入ったEPOCH
values[1] ログ本文の文字列
values[2] オプションペイロード。KEY=VALUE

おまけ:Loki exporter for OpenWRTのエラーログ

あのシェルスクリプトを読む気が起きなかったので、なぜこうなっているかはわからない。

BOOT=0 /bin/ash /usr/bin/loki_exporter
openwrt-loki-exporter/v1.0.6-0-gd20fb55-20260322-23413663016 started with BOOT=0
/usr/bin/loki_exporter: line 257: malformed ?: operator

あとがき

去年の8月にはやろうとしていたものの、そのままズルズルと長らく放置していたOpenWrtの監視周りだが、このままではいけないということで、一旦は雑に整備した。

大変雑なのでログ周りは機能するかも怪しいし、私以外が使えるようにも作ってない。最低限動くとかそんなレベル。LLMが書いたコードもろくにレビューしていないので、動いている原理さえ不明だ。

幸い全部で300行そこらなのでおいおい読んで理解していきたいとは思う。

基本原理はlogread -fした結果をいい感じに取り込んでLokiにたたきつけているだけのはずだが、この「いい感じ」が難しく、重くなっていると考えている。例えばログの取得漏れや、重複取得などを考慮しないといけないので、なんかそこら辺をいい感じにやってもらうようにLLMに指示したら一気に重くなった。ベースのコードは私が書いていたのだが、全くの別物になってしまった。

しかし去年の8月にしかかって放置している部分はできていないので、またそこは追々やっていきたいところだ。具体的には今回の対応はサーバー側でメトリクスを見る対応なのでネットワークが死ぬと終わってしまう。そこでルーター側でも簡易に見れるのを作ろうという計画がある。

しかしルーター側はスペックがしょぼいので大したことはできないし、ストレージがeMMCなので頻繁な書き込みもできないから、普段はメモリストレージ(/tmp)に置いておき、定期的に永続化のためにeMMCに吐き出すというのをやろうとしている。

そしてeMMCに端に吐き出すのもパフォーマンスと寿命の影響があるのでファイルシステムレベルでの対策をしてやろうみたいなことを考えていたが、尻切れとんぼのままなので、何とかしていきたいところだ。

超かぐや姫!を観てきた2

超かぐや姫!を観てきたに続き、去る5/2に超かぐや姫!をまた観てきたので、その感想を残す。

鑑賞から一ヶ月以上経っていることもあり、当時感じたことの多くが記憶から抜け落ちてしまったが、残っている記憶の限りで書き出しておく。

この記事のIDが0671、最新は0695なので、下書きを起こしてからおよそ一ヶ月放置していたらしい…。

四回目の鑑賞で思ったこと

ヤチヨのモチーフはセーラームーン?

ヤチヨのモチーフはセーラームーン?月見ヤチヨと月野うさぎはどことなく名前が似てるし、髪型もオマージュに見えなくもない。

( ◠ ᗜ ◠ )みたいな表情もあの世代のアニメによくあった表現手法な気がするので、どことなく親近感を感じた。

物語は最初からタイムリープに組み込まれている?

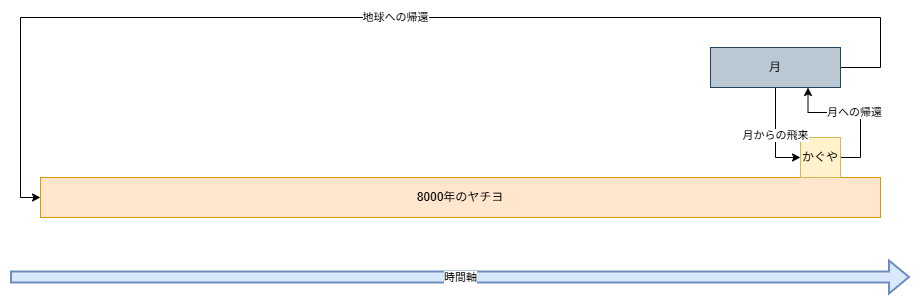
序盤のどこかでヤチヨが8000歳という情報が出てきたと思うが、これは8000年掛けて月から地球に戻ってきたヤチヨに一致する。

つまり初めて月に飛来する赤子のヤチヨと、歌声を聴いて戻ってきたヤチヨが交差する時間軸がここにあるのではないか?と思った。

ツクヨミとクガネの類似性

FF14にはクガネという和風のマップがあるが、雰囲気的には似ているような気がした。いや、3Dの和風マップなんてどれも似たり寄ったりだろと言われたらそんな気もするが、桟橋のような場所や海と、連なる高層建築とか、そういう雰囲気が似ているなと思った。

もう届いちゃったから

いろはが「ヤチヨのデビュー曲ってもう歌わないの?」と言い、ヤチヨが「もう届いちゃったから」と返すシーンがあるが、これはいろはとヤチヨが出会えたことにより、もう届いたという意味ではないかと思った。

ライブやダンスなど、アクションパートがすべて2D表現

昨今アクションパートのキャラクター描写は3Dで描かれがちだが、本作では2Dが基本だ。これは工数がかかりコスト増につながるため、そういった表現を取れるというのは凄いことだと感じた。

いろはがかぐやを遊びに誘うシーン

今までかぐやに対してそっけない態度だったツンデレいろはが遂にデレてかぐやを遊びに誘うシーンのエモさは筆舌に尽くしがたいものがあった。あのシーンには思わずグッときた…。

特に脱力的な「あそぼ~~~~」というセリフが最高にエモかった…。

母との和解

蛇蝎のごとく嫌っていた母と意を決して話し合うシーンで、これまでの思いを告げ、認められるシーンは、これはすごくいいと思った。

毒親を嫌うのは同情を得やすいと思うが、その先で和解まで描くのは美しいと思った。似たシーンはガルクラにもあったので、一つの潮流かもしれない。

フシ、ふじゅ~

恐らくこれらはかぐややヤチヨが不死であることを暗喩しているのではないだろうか?

異例の鑑賞地

まず現状本作は神戸市内で上映があったのに、市内で一度も鑑賞しなかった作品になっており、これは歴代の鑑賞歴の中では異例だ。

理由は割と単純で、まず初回鑑賞時では神戸の映画館はすべて埋まっていて姫路で観るしかなかったことが一つ、本作は2時間半と尺が長いのと観る時間を取りづらいこと、そして大箱向きの作品であり、市内にある狭い箱で観る気が余り起きなかったことがある。

ぶっちゃけ神戸市内で音とスクリーンがいいのはシネ・リーブル神戸とキノシネマ神戸国際くらいで、OSシネマズ二館は微妙だと思ってる。そして上映があるのはOSシネマズだけだったので、必然的に観なくなるというわけだ。

姫路で三度も見ているのは一回観たらもう一回観たくなり、そうしたら終電を逸してしまい、仕方なく姫路に泊まったら、ついでに翌朝もう一回観たくなったためである。

アースシネマズは箱がデカく、今回上映のあった箱はウシオプレミアムシアターと雷舞で、何となく気分が上がるのもいい。

その次は高知で観ているが、これはこれまでにあった特典全配布があったのと、特別上映があるということ、前々から高知に興味があったことの三点がうまく合致し、高知鑑賞が決定した。

高知県立県民文化ホールには広いオレンジホールと狭いグリーンホールがあり、上映があったのは狭いグリーンホールだったが十分な広さがあり、音響も非常によかった。恐らくだが民間はROIに依存した設備にせざるを得ないところ、公営なので何かしら一定品質の要求があり、それを満たせる高品質な設備を整えられ、日々のメンテナンスも無駄にしっかりしてるからとか、そんなことが背景にあったりするところによるのではないかと思った。

高知の旅行記もまた後日書いていきたいと思う。

その他、鑑賞以外のこと

公式サイトのスペシャルコンテンツの充実が凄い。凄すぎる。

二次創作ガイドラインについて

まず目についたのは二次創作ガイドラインだ。

本作はその作品特性からだろうか、次の様に非常に寛大なガイドラインを示してくれている。

★二次創作は是非楽しんでください。
★個人あるいは特定少数のグループで楽しむことを主たる目的としてください。
★作品ならびにファンを傷つける行為はご遠慮ください。
★ファンのみなさま同士で二次創作をもとに批判することはおやめください。
★本編設定と異なる場合は、誤解を生まないよう事前に注意書きをするなど留意してください。
★公序良俗に反する内容はお控えください。
★二次創作は創造性・オリジナル性が認められるものに限ります。また、公式の発表物・販売物と誤認されないようにしてください。

つまるところ、良識の範囲で二次創作が自由なのだ。

作中に「ツクヨミは皆が表現者」という言葉もあるように、『超かぐや姫!』としては今後も二次創作を楽しんでいただきたいと考えております。

という一文も見逃せない。

二次創作物の販売・頒布という項目もあり、こちらでも期間を定めたうえでの直接頒布の制限、その期間外での委託頒布の許可、在庫に限り委託も可能といった、とても柔軟で現実的な内容を書かれている。ここまで寛大な公式は中々ないのではないだろうか?

更に驚くのが一次創作物の使用だ。

一次創作物については、『超かぐや姫!』公式X(旧Twitter)、YouTube、TikTok、Instagramで公開した画像や映像の一部または全部について、営利目的でない目的で、WebブログやSNS等に掲載(外部プラットフォームの埋め込み等)していただいても問題ないとのことで、これは相当寛大な措置である。ネット文化では当然のように無許可利用が見られミーム化されているが、それを公式で認めてしまうというのは凄いことだと思う。超かぐや姫!ならではと言える。

このため、本記事中でも公式YouTubeで公開された画像を引用して使っている。

その他諸々についても細かく、しかし非常に寛大な規定があり、更にはこのガイドラインの発効以前のことについては基本的に許容する方向の旨まで書かれており、あまりにも寛大で、もはや何回この記事中で寛大と書いたかわからないほどだ。

更には次のようにコミュニティに対する助言まであり、非常に配慮が行き届いた内容になっているのは驚きである。

本ガイドラインの内容を他の方へ指摘する行為はお控えください。

総じて超かぐや姫!の制作はネット文化や、そこからリアルワールドのオタク・同人文化に深く精通し、それらを言語化したうえで、ファンダムに対し公開できるというところで、大変すごいと思う。

また国際的に公開されている関係からか、以下の一文があるのも驚きだ。たぶん他の作品にはここまで中々ないのではなかろうか?

本ガイドラインは日本語によって発表いたします。
本ガイドラインのその他言語への翻訳は参照のためのものに過ぎず、日本語版と翻訳との間に齟齬がある場合には日本語版を優先とします。

特別上映の多さ

発声可能上映は勿論のこと、SNSへのポスト可能上映といった珍しいものや、今回私が赴いた、未上映県での頒布物全部付き、物販ありの特別上映など、とても充実した上映があったほか、舞台あいさつについても人口に膾炙しきったタイミングで最後のファンサだ!”卒業記念舞台挨拶という、素敵なタイトルで実施されるというのがとてもいい。

更にセカンド上映も全国各地で行われていたり、本日6/2からはライブ音響上映も始まるということで、非常にこういった上映が多く面白いと感じる。

応援コンテンツの豊富さ

配信カウントダウンイラストでは主要スタッフからのカウントダウンイラストが多数あり、劇場特典 スタッフイラスト集 掲載イラストにも同スタッフによる多数のイラストが掲示されているうえ、ライナーノーツ【本編オリジナル曲】でもすべての曲のノートが書かれている。

更には超豪華応援イラスト&コメントでは岸本斉史先生や藤本タツキ先生をはじめとした名だたる人物からの応援イラストやメッセージが届いており、これも凄いことだ。

本作は作品自体もかなり厚いが、制作側の熱意も凄く、本当にすごいと感じる。

素材配布

「私は、わたしの事が好き。」素材ではBoothやピアプロといった第三者のオタククリエイティブプラットフォームを使った公式動画やロゴなどの素材配布があったり、壁紙ではLive2D画像を使ったスマホ壁紙の配布もあった。

お決まりのSNSアイコンとかは見られないが、配布コンテンツの内容が他にない独創性を持っていて、これはいいなと思った。

LLMに対する最近の思いとか過去の考えとかの整理

これまでいろいろ書いてきたが、それらの総括的なものを吐露していく。

金銭面での問題

LLMは金が掛かる。特にAnthropicをBANされて、Poeから叩いている私はなおのこと金が掛かる。

レートリミットがないので無限に使えるのを強みと言いたいが、そんなのはすっぱい葡萄の話でしかない。

またクラウドの登場からずっと言われていることだが、デジタル赤字の根源の一つにもなっている。

LLMを使えば使うほどAnthropicやOpenAI、Googleなどに富が流れ出ててしまうので、これは国としてみた場合に深刻だ。最近はデジタル小作人とかとも言われている。

とはいえ、正直これは仕方がない面もあり、ぶっちゃけITシステムはコモディティ化しやすく、局所的なところに集中せざるを得ないと思っている。例外的に中国だけは国内で回せているが、最前線とまでは言えないにせよ自前で実用水準を回せているが、これは中国の地政学的な問題が大きく影響していると考えている。

何故なら中国はその体制的に、アメリカのIT資産にアクセスできなかったり、仮にできてもある日突然禁じられるリスクがある。それなら中国の国家運営にフィットし、あわよくば普及させることで他国を操作しうる国産モデルの開発を好み、そのためなら予算を惜しまないだろう。だからこそ、一定のLLM開発が成立していると言える。

何故なら、もしアメリカを超えるモデルを作って普及させられれば、アメリカがやっているように「使わせない」ことで圧力をかけたり、制裁の脅しに使えるからだ。当然、そこから情報を抜き取って中国に有利な形で活用することもできるだろう。実際、中国が怪しい振る舞いをしているのは、Huaweiの問題や、宇通のバスに仕込まれていたバックドアからも明らかだ。

一方、日本にこれはできない。ドイツやイタリアをはじめとした欧州諸国だってそうだろう。アメリカ以外の国の大半には自国でフロンティアモデルレベルのLLMを作るだけの技術もリソースも恐らくない。何故なら現状フロンティアモデルは中国ですら到達できていないからだ。中国はフロンティアモデルを使ってLLMをトレーニングしていることが知られており、AnthropicもDetecting and preventing distillation attacksでそのことを公表している。要するに、中国でさえ自力でまともなモデルを作るだけのリソースを持っておらず、他人の成果物を横取りすることしか出来ない訳だ。

だが本質はそこではない。仮に世界各国が作り合ったとしても、同じようなものが万国に散らばっていても意味がない。すべての国が中米のように敵対しているわけでもない以上、いずれどこかに収束するのは自明であり、結局やる意味がないと言える。

開発時の認知負荷の重さ

AIを使った開発に取り組み始めてみた雑感で軽く触れ、Value-DomainのDNSを操作するユーティリティを更新したで実感したことだが、LLMを書いたコードをレビューするのは大変だ。

何せ一気に大量のコードを書いてくるし、もっともらしいコードを書いてくるので非常に疲れる。これが人間の書いたコードなら荒探しをしたい気持ちなどが湧いてきて徹底的に見たりするような気がするのだが、LLMは人間ではないのでそんな気も起きない。だって、間違いを指摘しても学んだり成長しないから、意味がない。

AIコーディングのレビュー負荷に関することは色んな企業のテックブログでも言われていると思うが、正直大量に書かせてしまうとレビューはほぼ無理だと思う。

先日読んだテストコードの意味がないという記事もまさにそれに近い話だろう。とはいえ、なかなか難しい話だとは思う。

個人的には実装からテストコードを書かせるのであっても、正常ケースと異常ケースを網羅的に書かせることができれば、以後の修正でテストが落ちれば、それは問題ないと感じる。但し初回作成時に実装コードを破壊して、意図したとおりにテストが落ちることの確認はしておいたほうが良いだろう。とはいえ、LLMに書かせているとそれすらおっくうになってくるのが個人的には困りものだ。

やるとしたらモジュラモノリスのような小さなモジュールを集めた構造にし、それを書かせれば多少はマシになると思う。でもそれって人間書いてもいいですよねってなるわけで、何ともな感じもある。

他にもLLMが書くと人間が正しく認知しないとか、人間が手で書いていればハマった部分や苦労した部分などで記憶に残り、バグが出たときに「あそこかも!」という当たりが付いたりするが、LLMに書かせていると、まず無理だろう。

当然LLMでも特定はできるだろうが、LLMは金が掛かるし、ソースを精査する時間も長い。チューニングで何とかなるといっても誰がチューニングするんだという話になってくる。

思考力の低下

よく昔はできたが今はできないということが語られると思う。例えば元開発者のマネージャーが、手を動かさなくなった結果、開発方法を忘れたとか、そんなことを話したりする。やっていなかったことができなることは自然なことだ。日々やり続けることによってのみ筋力が維持されるのと同じことである。

同様にLLMを使っていれば、LLMを使う力は養われるだろうが、LLMに文章を書かせていれば文章力が、LLMにコーディングさせていれば設計力や実装力が失われていくのは自明のことだろう。

果たしてこれはいいことなのかどうかというのはとても思う。たぶんLLMに漬かりすぎていると早期にボケるのではなかろうか?

登山中に電波が届かない環境や、会議のファシリテートなどで「LLMを使わないとわからない」なんてことは言いたくないものである。山の中は電波が届かないし、悠長にやっていてはバッテリーがなくなり、日が暮れる。ファシリテーターが一々LLMに聞いていては会議が進まない。

またLLMの技術を使ったブラウザ操作や、ECサイトでの買い物なども出てきており、この辺りでは意思決定の一部さえLLMに委ねており、人としてそれでいいのかとも思ってしまう。何も考えられなくなりそうだし、人としての意思とかは残るんだろうとか。

2024年12月20日には兵庫丼に次のことを書いていたが、まぁこんなのは今となってはもうどこでも起きていそうである。

「AIが提案したので実装しました。なんで動くのかは知りません」
「AIの提案なら大丈夫でしょう!レビュー通過です」
みたいなやり取りは全国でどのくらい起きてるのだろう

2024年12月17日にも兵庫丼に次のことを書いていた。

人類そのうちAIに質問して出てきた返事のとおりにしか行動できなくなるのではないかみたいな心配をしてしまいがち

LLMプロバイダに生殺与奪の権利を握られる

AnthropicなどのLLMプロバイダは規約違反した人物をBANすることで有名だ。実際に私もAnthropicをBANされている。

BANされると使えなくなるのでBANされないように忖度が始まるが、使わなければこんなことは気にしなくても済む。まぁ忖度したところで企業レベルでBANされてる話も聞くし、そもそも夜職に関わる開発など、BANされるような産業だとどうしようもなさそうだが…。

他にもおむつメーカーがパッケージを見せたところ児童ポルノ判定されたという話もみたことがあるので、何とも難しいことだと思う。LLMはなんにでも使えるわけではないのだ。

LLMは本当のことを言えない

これは何が本当のことか?という話になってくるのだが、LLMは本当のことを言えない。それに対して人間ならそれを言えるという話だ。

では何が本当のことか?だが、人間は生きている間ずっと、連続して何かを経験している。そして経験したことを、自分の言葉として言える。一方LLMは、膨大なテキストを流し込まれているだけだ。知識カットオフ以降のことやRAGで与えられた情報も語れるが、それらも結局は外から与えられたものにすぎない。つまりLLMが発することは、全て他人の又聞きでしかない。要するにLLMの言葉は「隣の田中さんがそう言っていた」と言う噂話を膨大に集めて確率的に確かにした話ということになる。

私は本当のこととは実体験に基づく、その人物だけが言えることだと考えている。「私はこれを見た」「私はこう感じた」、そういった実体験に基づく知識は人間にしかない。例えば昔事故を引き起こした振る舞いを知っていれば、それを止めることができる。いわゆる筋の悪さを語れるという話だ。しかし、LLMにはこの経験そのものが存在しない。だからLLMは、世界についての情報をいくら正確に語れても、「私が経験した」という意味での本当のことを、ただの一つも言えない。

もちろん、その経験が実際に役立つとは限らない。人間の側の知識が間違っていたり、古すぎたり、今回のケースとは違ったりして、役に立たないこともあるだろう。それ故にLLMのほうが正確な情報を出すことも少なくない。

しかし、LLMの情報がどれほど正確でも、LLMの言葉は誰のものでもない又聞きのままだ。そして人間の言葉には、たとえ間違っていても、その人が実際に経験したという、唯一無二の価値があると考える。

そう考えると人間はLLMの又聞きを聞いて頷いているだけではなく、独自の知見を求めるのがより大切なのかもしれない。他の誰も知りえない、そんな自分だけの体験を得ることができれば、何かになるのかもしれない。

LLMは日々成長しない

人間は基本日々成長したり劣化したりするけど、AIにはそれがない気がする。AIは学習したことをミックスして吐き出すことしかできないので思いつきや閃きと言ったイノベーションは起こせないと思う。

いやまぁ遺伝的アルゴリズムみたいなことすればできなくはないと思うけど、AIは人間に比べると個体数が少ないし多様性にも限度があると思うし、どうしてもどこかに収束していきそうだ。

ということを2023年12月12日に兵庫丼に書いていたので、こちらにも転記しておく。

LLMと話してると疲れる

壁打ちなどでLLMを使うことはよくあると思うし、だる絡みだっていくらでもできるが、割と虚無な話になって時間だけが経ち、無意味な会話になっていて可処分時間がつぶれて疲れただけというのは経験として割とよくあった。

回答に対しても一貫性がなく、生成するごとに違う回答をしてくるので疲れるみたいなところもある。

また基本的にスレッドを分けると過去の記憶は残らないので、以前の話はなかったものとして進むとかもあり、なんと言うか友人とかと思って接していると疲れる気がしている。

これはSNS疲れによく似たLLM疲れについてで幾らか書いているほか、個人的に思うLLMの活用方法についてにもある程度通じることを書いている。

LLMは理想を完全には作ってくれない

自分が作りたいものを100%形作ることにはLLMにはできない。人によっては気に食わず直すこともよくあるだろう。

これは単純な話で、部下にこれを作れと命じたところで微妙に違うものが出てくるのと同じことである。本当に解像度100%で自分が欲しいものを作りたい、こだわりや矜持を持ちたいなら、それは自分で作るしかなく、LLMに作らせる時点でそこに妥協が生まれるのだ。

あとがき

LLMそのものは便利だが、人間の手に余りすぎるし、金はかかるし、人の思考を奪ってくる割に、熟練の人間の思考より早く動くわけでもないので、常に使えるわけでもない。それに頼りすぎると人間性が失われそうでもある。そして何よりもそこに拘りは残らない。

Value-DomainのDNSを操作するユーティリティを更新した記事のあとがきにも次のように書いたが、きっとLLMに頼りすぎず、自分で何かを成し遂げていけたらいいのだとは思う。問題は今の時代にそれがどれほど実際に可能か、みたいな話ではあると思うのだが、このままではLLMの言いなりになって、LLMの単一思考によるコモディティ化と先細りしかないようにも思うし、デジタル赤字とかも問題だと思うので…。

ボケ防止のためにはAIに頼らず、自分の手を動かすのも大切なことだと思う。こういう話では、よくそろばん論を持ち出して、そろばんを使わなくなったが人類は劣化していない、電卓があるみたいなことを言う人がいるが、実際問題珠算ができる人は非常に速い速度で暗算ができ、頭の回転も速いとされているので、電卓があるから優位と言われれば、それは違うと思う。例えば電卓を取り出す時間で計算が終わっていたり、物事を予測しやすかったりするわけだ。

なんと言うかLLMを主とせず、あくまで補助的な役割で使っていければ、人の判断や軸が残るので、良いのではないだろうか?とかは少し思った。