2026/09/28(月)WoL対応のSFP+ 10GbE NICを買ってWoLを実現した

以前買ったMellanox ConnectX-4でWoLができなかった話の続き。

SFP+搭載NICを使い、WindowsマシンをWoLを使ってスマホから起こすのをやる話。

やりたいこと

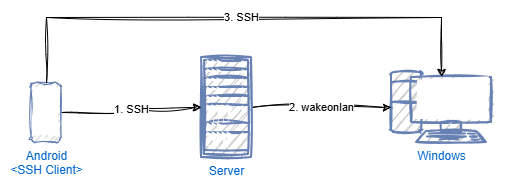
流れとしてはスマホからUbuntuサーバーにSSHで繋ぎ、UbuntuサーバーからWindowsデスクトップへマジックパケットを送付して起こす。Windowsが起きたらスマホからWindows側にSSH接続して扱う内容。

Cloudflare TunnelやTailscaleは使わずにSSH直結で扱い、スマホ→Ubuntu→Windowsのように踏み台を使うこともしない。

使ったもの

デバイス

Windows~L2スイッチ間で使っているもののみ。

種類 デバイス
マザボ ASRock Z890 Pro RS
NIC TXA403
DACケーブル 10Gtek CAB-10GSFP-P2M-30
スイッチ MikroTik CRS305-1G-4S+IN

ソフトウェア

Env ver
Windows Windows 11 Pro 25H2
Ubuntu Ubuntu 24.04.4 LTS
WoL wakeonlan version 0.41

ネットワーク構成

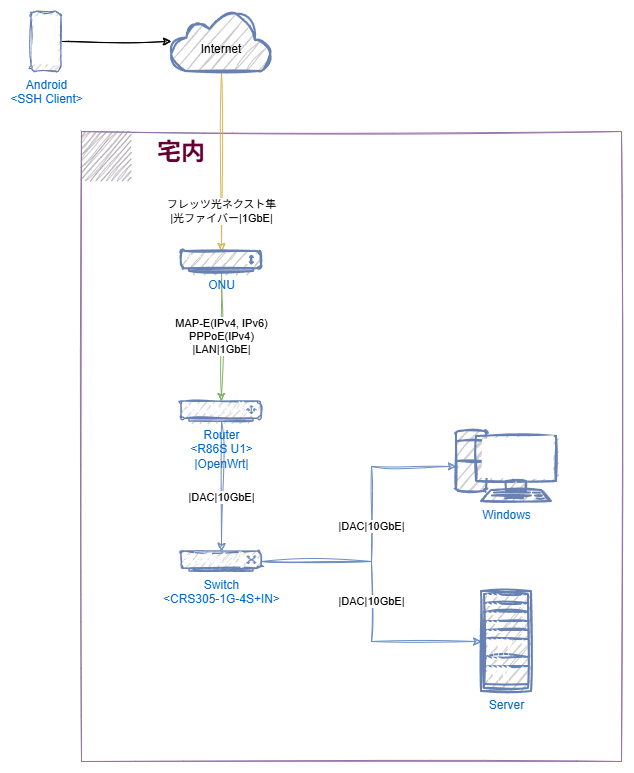
大まかにこんな感じ。図には書いてないがLAN内にはWiFi APもあり、そこからも叩ける。

やったこと

Windowsデスクトップ側

  1. BIOSでPCIe経由の起動を許可するように設定
  2. Realtek PCIe FE / GbE / 2.5GbE / 5G / 10G Family Controller Softwareから「DASH all-in-one Installer for Win10/Win11」をダウンロードし、インストール
    • ここはNICを挿す前にやっておくといいと思われる
  3. NICを挿す
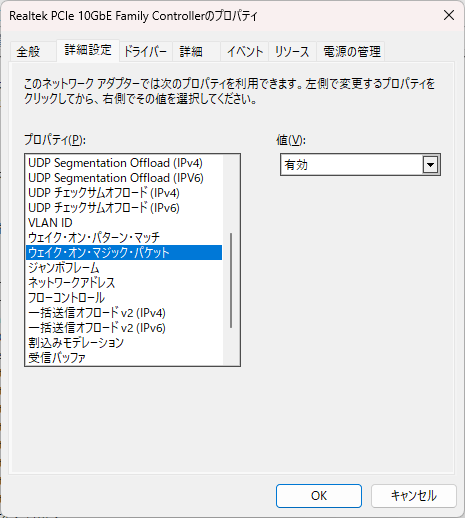
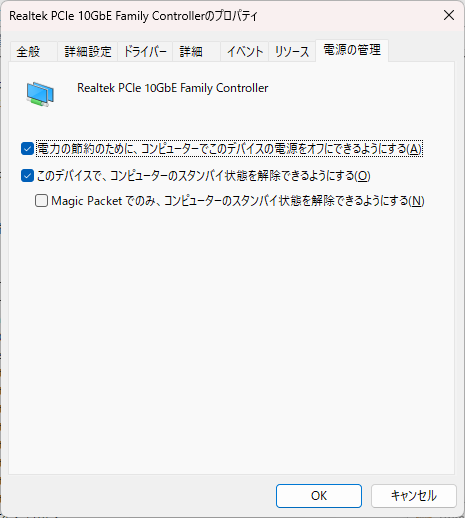
  4. デバイスマネージャーでWoLが有効になっていることを確認(デフォルトで有効だった)

Ubuntuサーバー側

wakeonlanと言ういかにもそのままなパッケージを入れるだけ。入れたらMACアドレスを指定して叩くとマジックパケットを投げることができる。長いのでエイリアスを貼っておくと楽。

sudo apt install wakeonlan
wakeonlan <MACアドレス>

Android側

適当なSSHクライアントでUbuntuに繋ぎ、wakeonlan <MACアドレス>を流し、Windowsを起動させる。

開封の儀とか紆余曲折の話

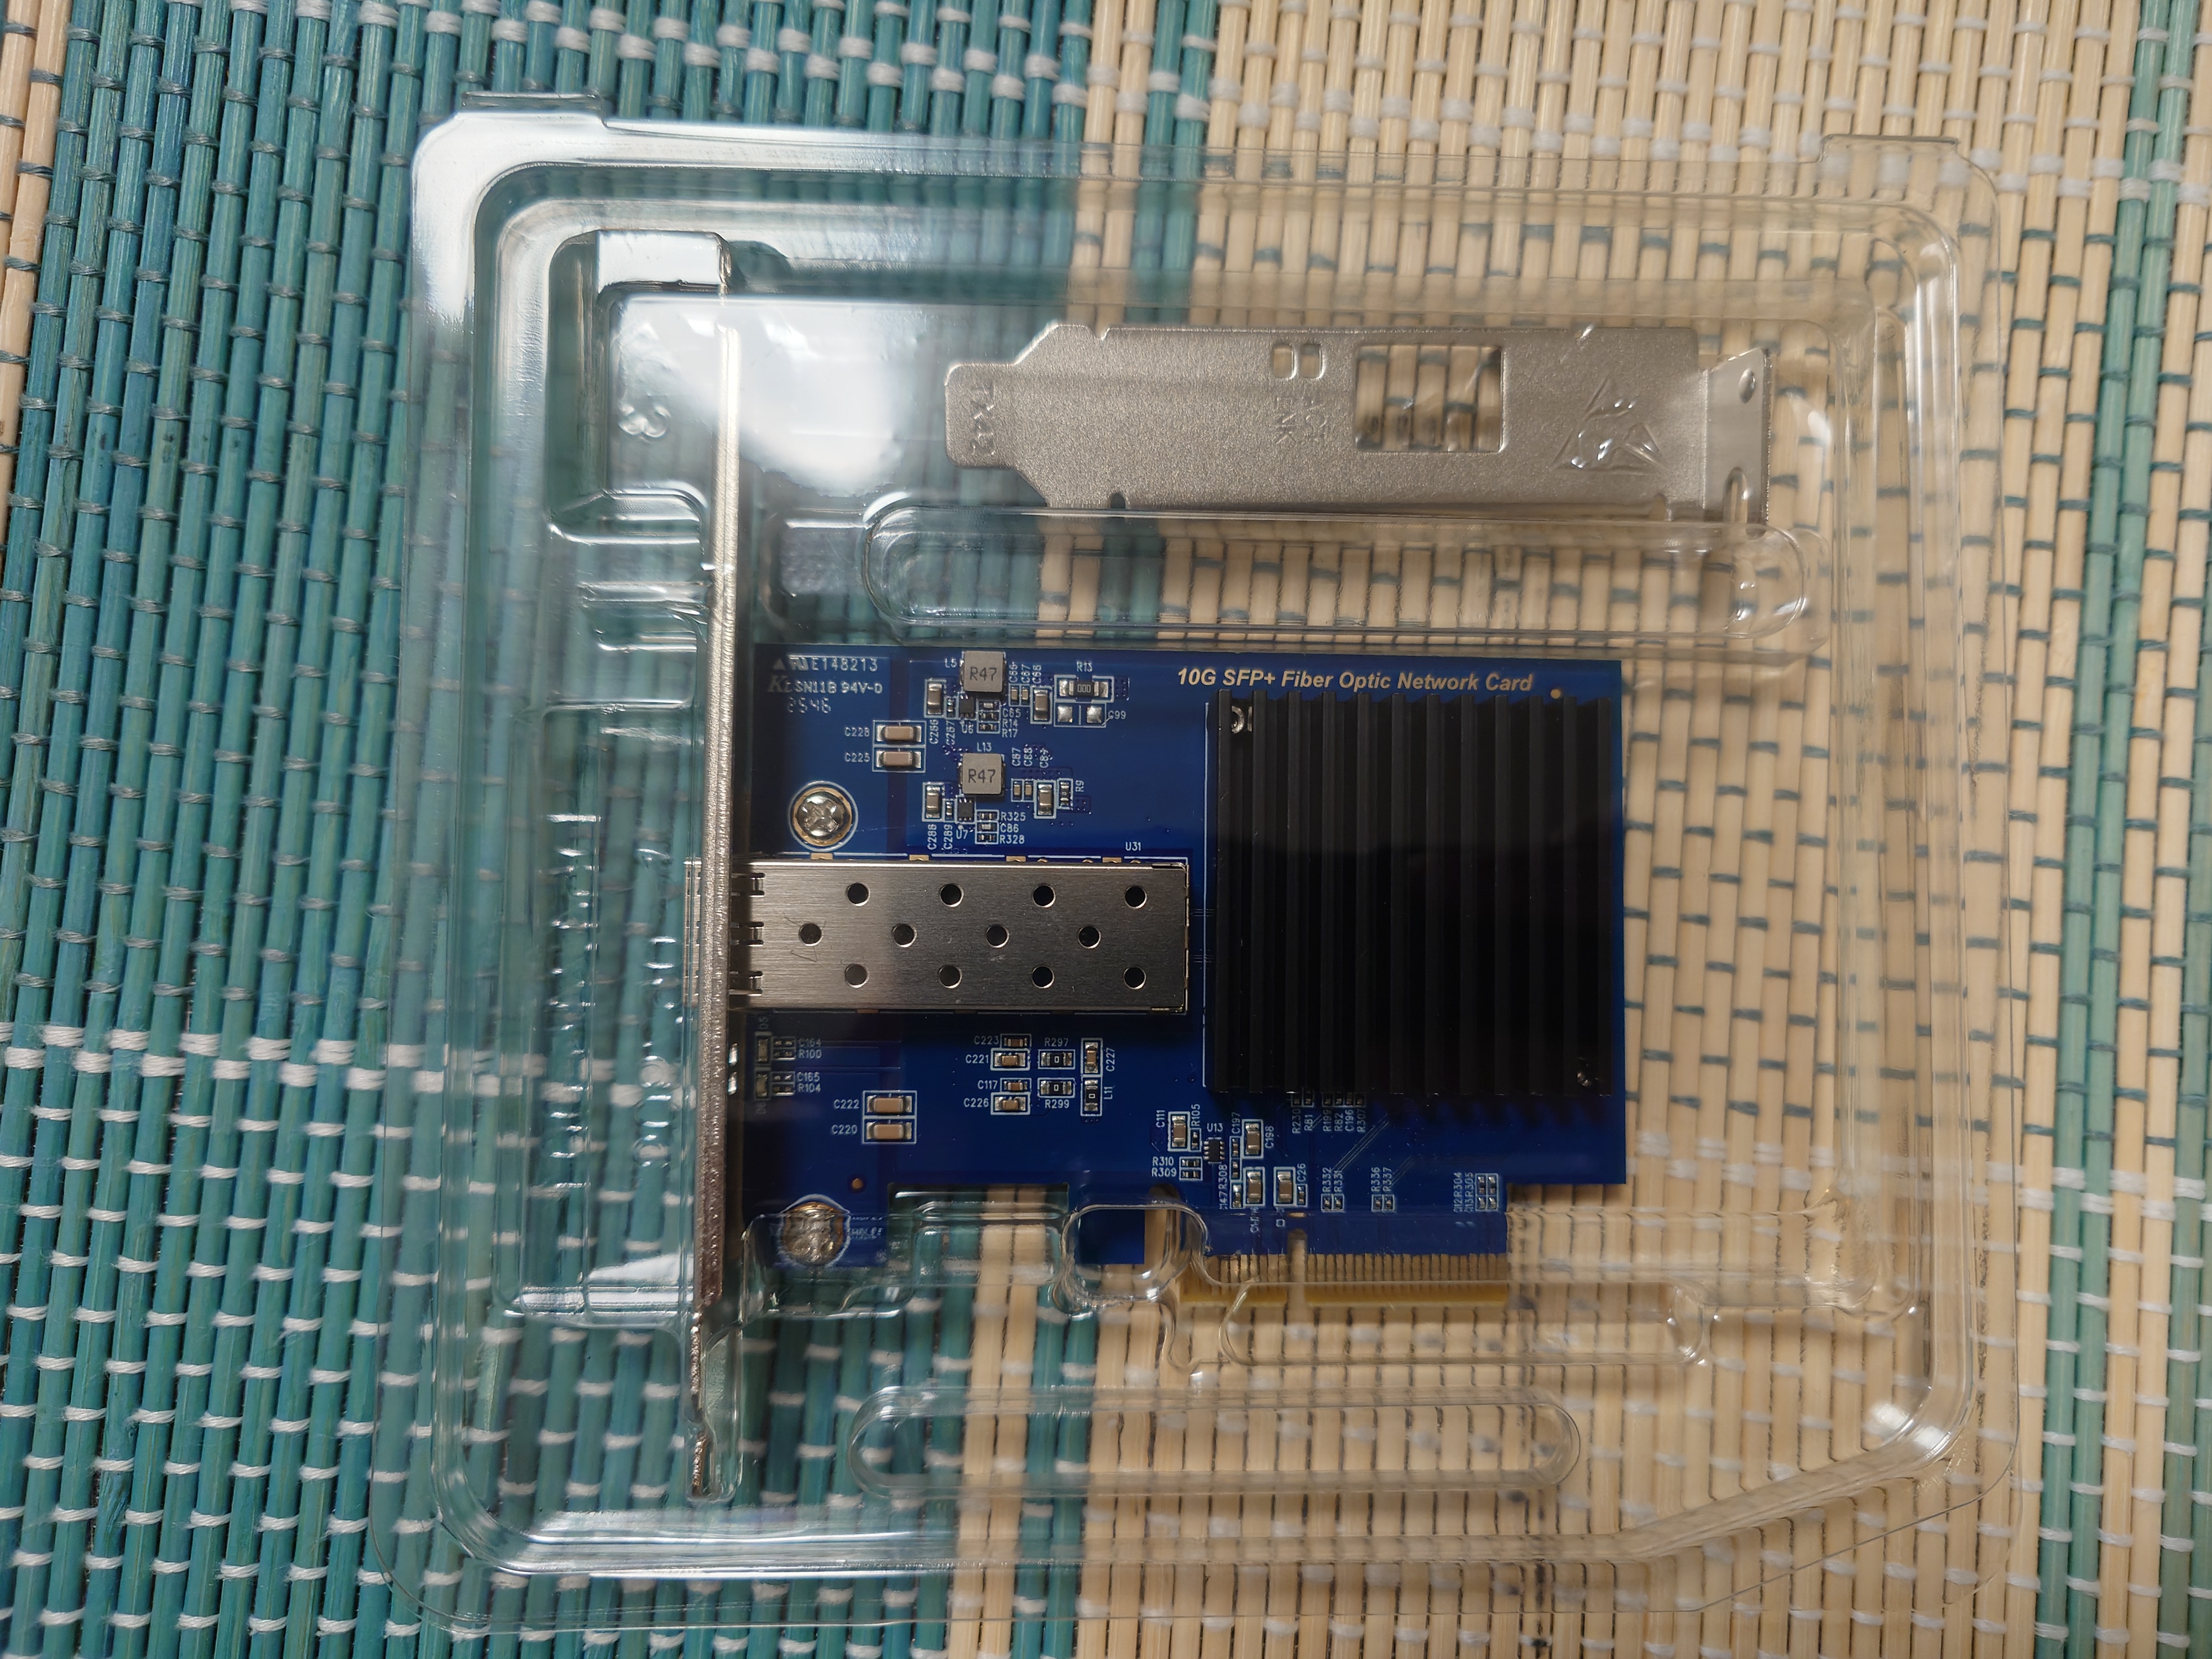
SKN-8127AF-X1ではダメだった話

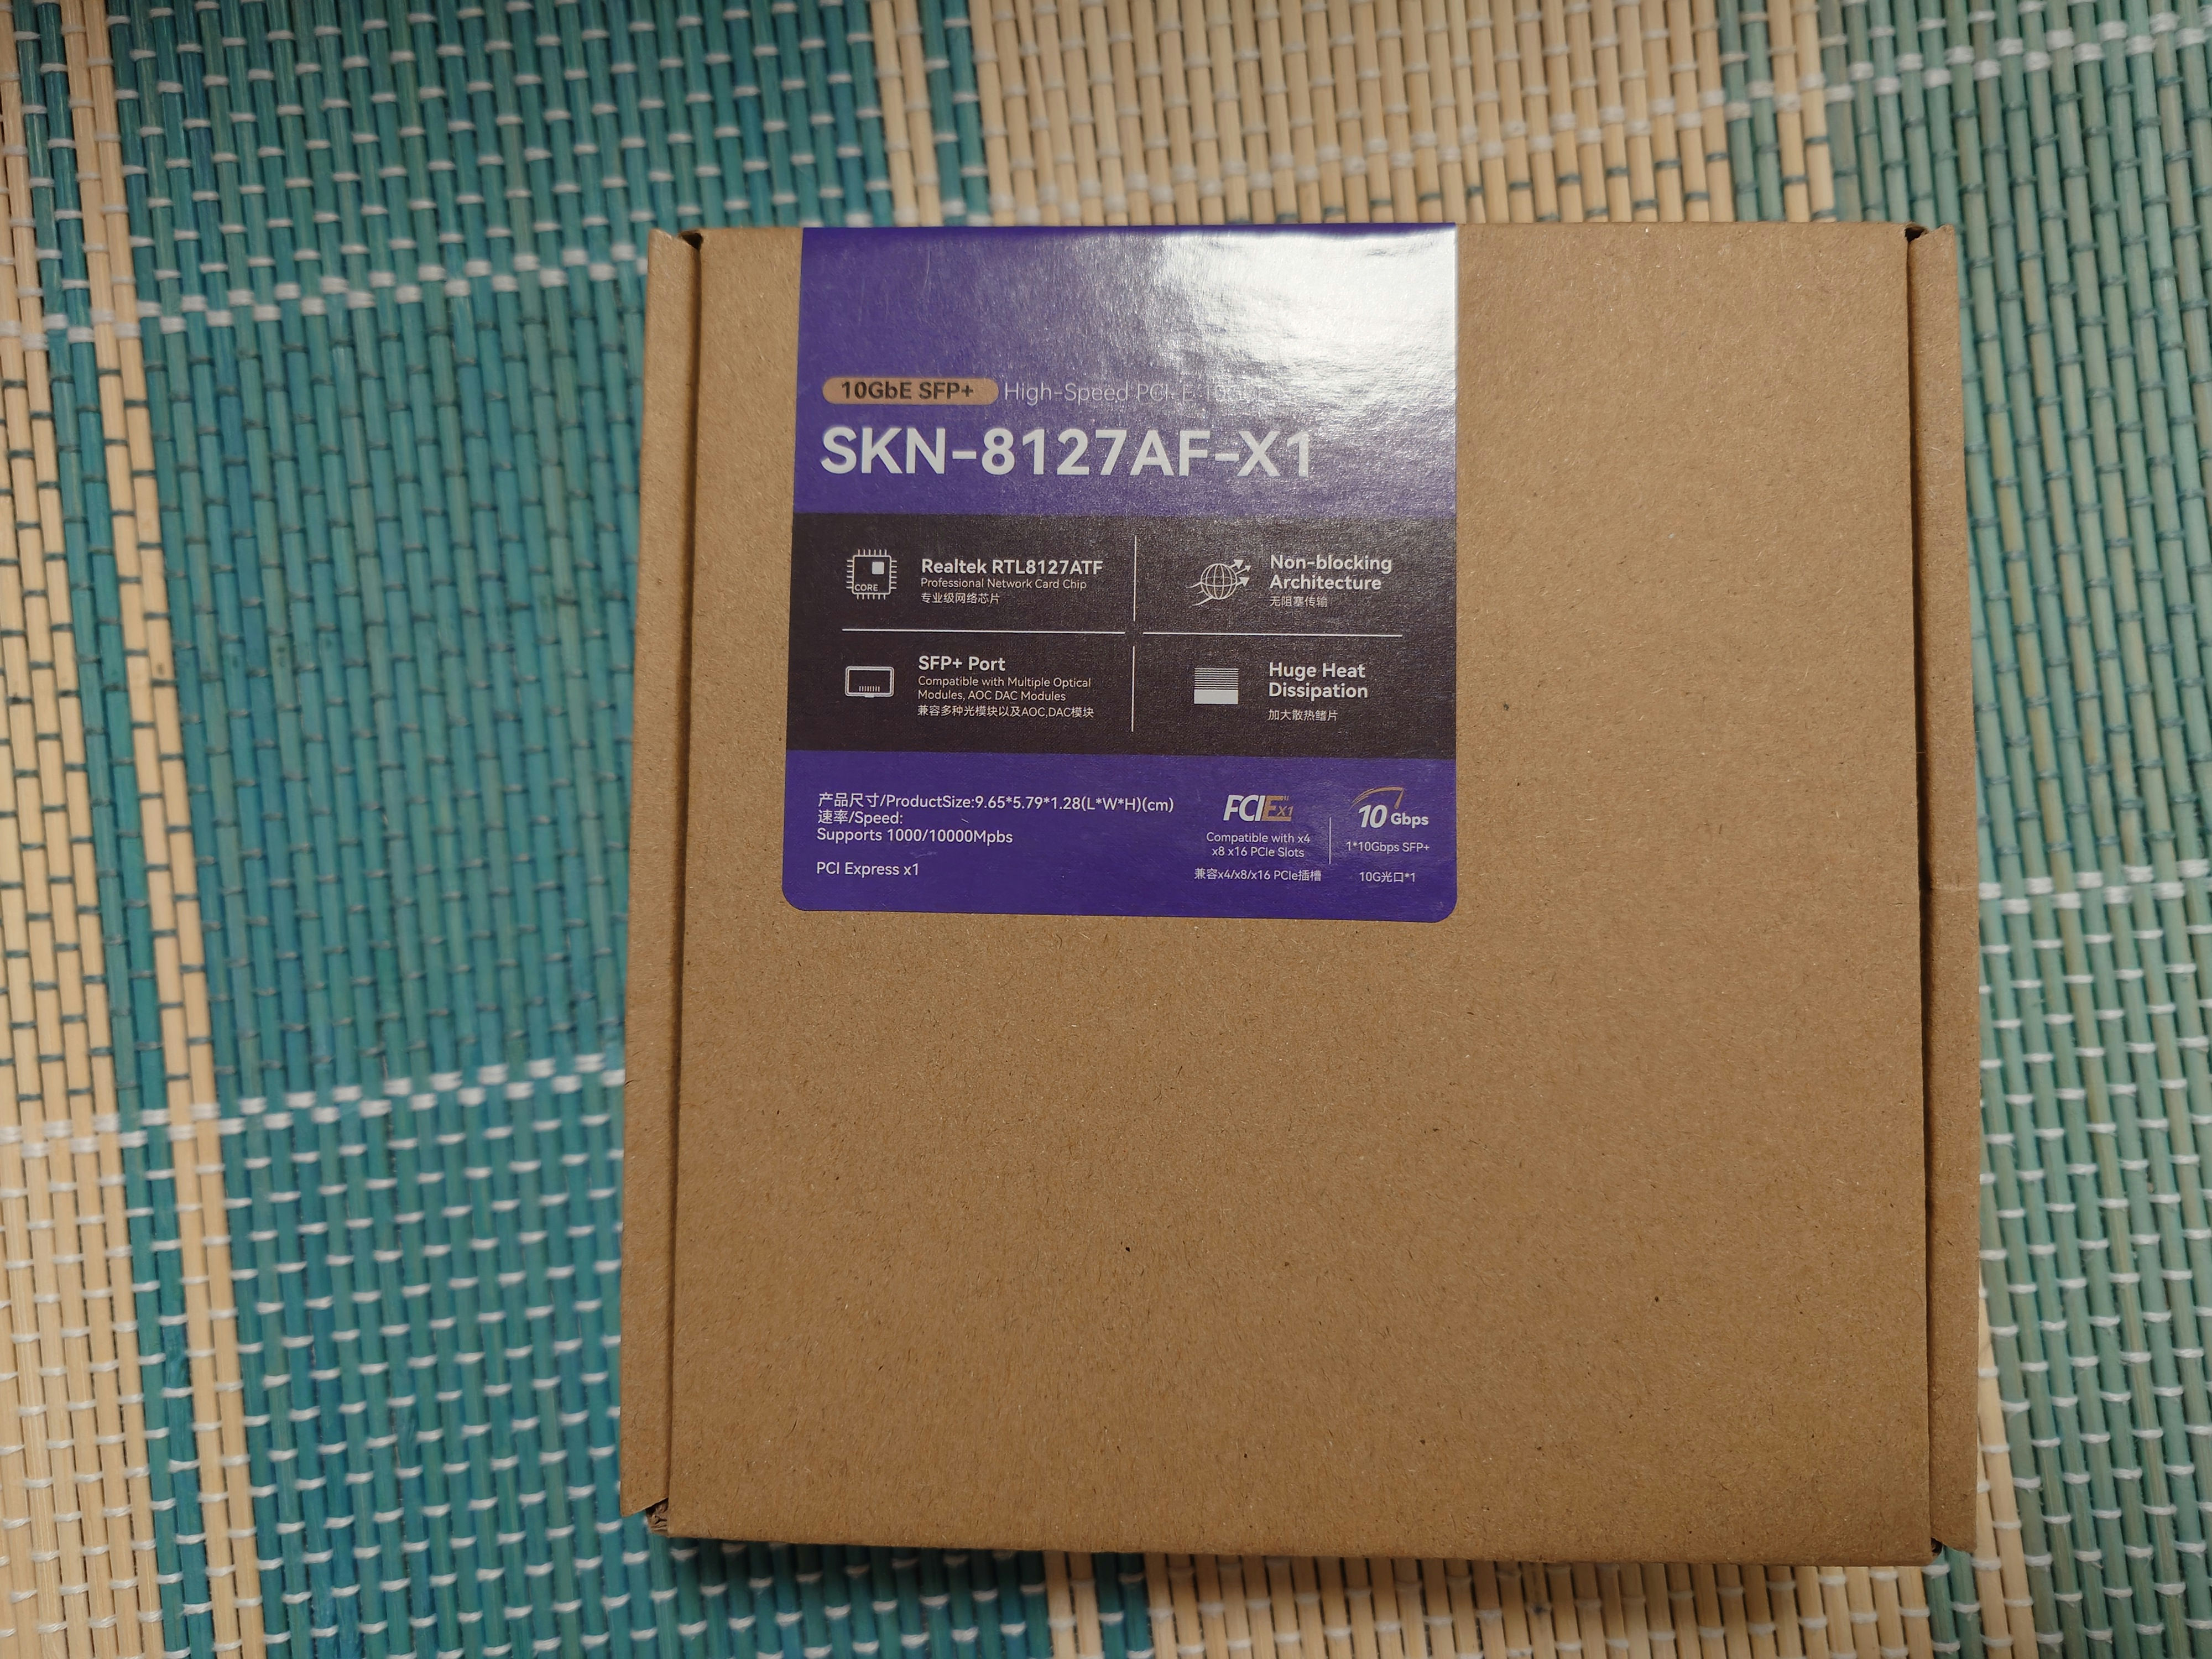
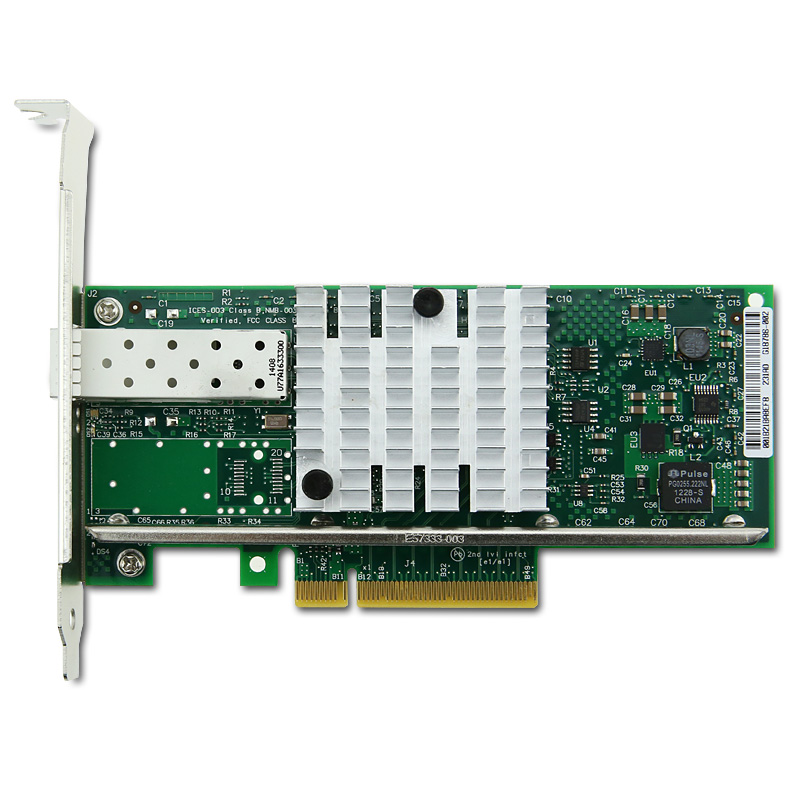
以前買ったMellanox ConnectX-4でWoLができなかった話ではSKN-8127AF-X1を使うことを検討していたが、DACとの相性が悪いのかこれは使えなかった。まずDACケーブルを挿してもLEDが付かず、OSから見ても当然線が刺さってない扱いだった。

SKN-8127AF-X1自体は日本語の取説まであり、いい感じのパッケージだっただけに残念だ。

しむふり生活というブログによるとオートネゴシエーションの設定が死んでいるので、手動でリンク速度を設定すれば行けるらしいが、この情報を知る前に処分したためもう分からない。

ブラケットもやたら傷まみれだったし、単純に不良品だった可能性もあるが今となっては解らない。

コネクタはPCIe4.0x1で、空きがあればどこにでも挿せるのは嬉しかった。

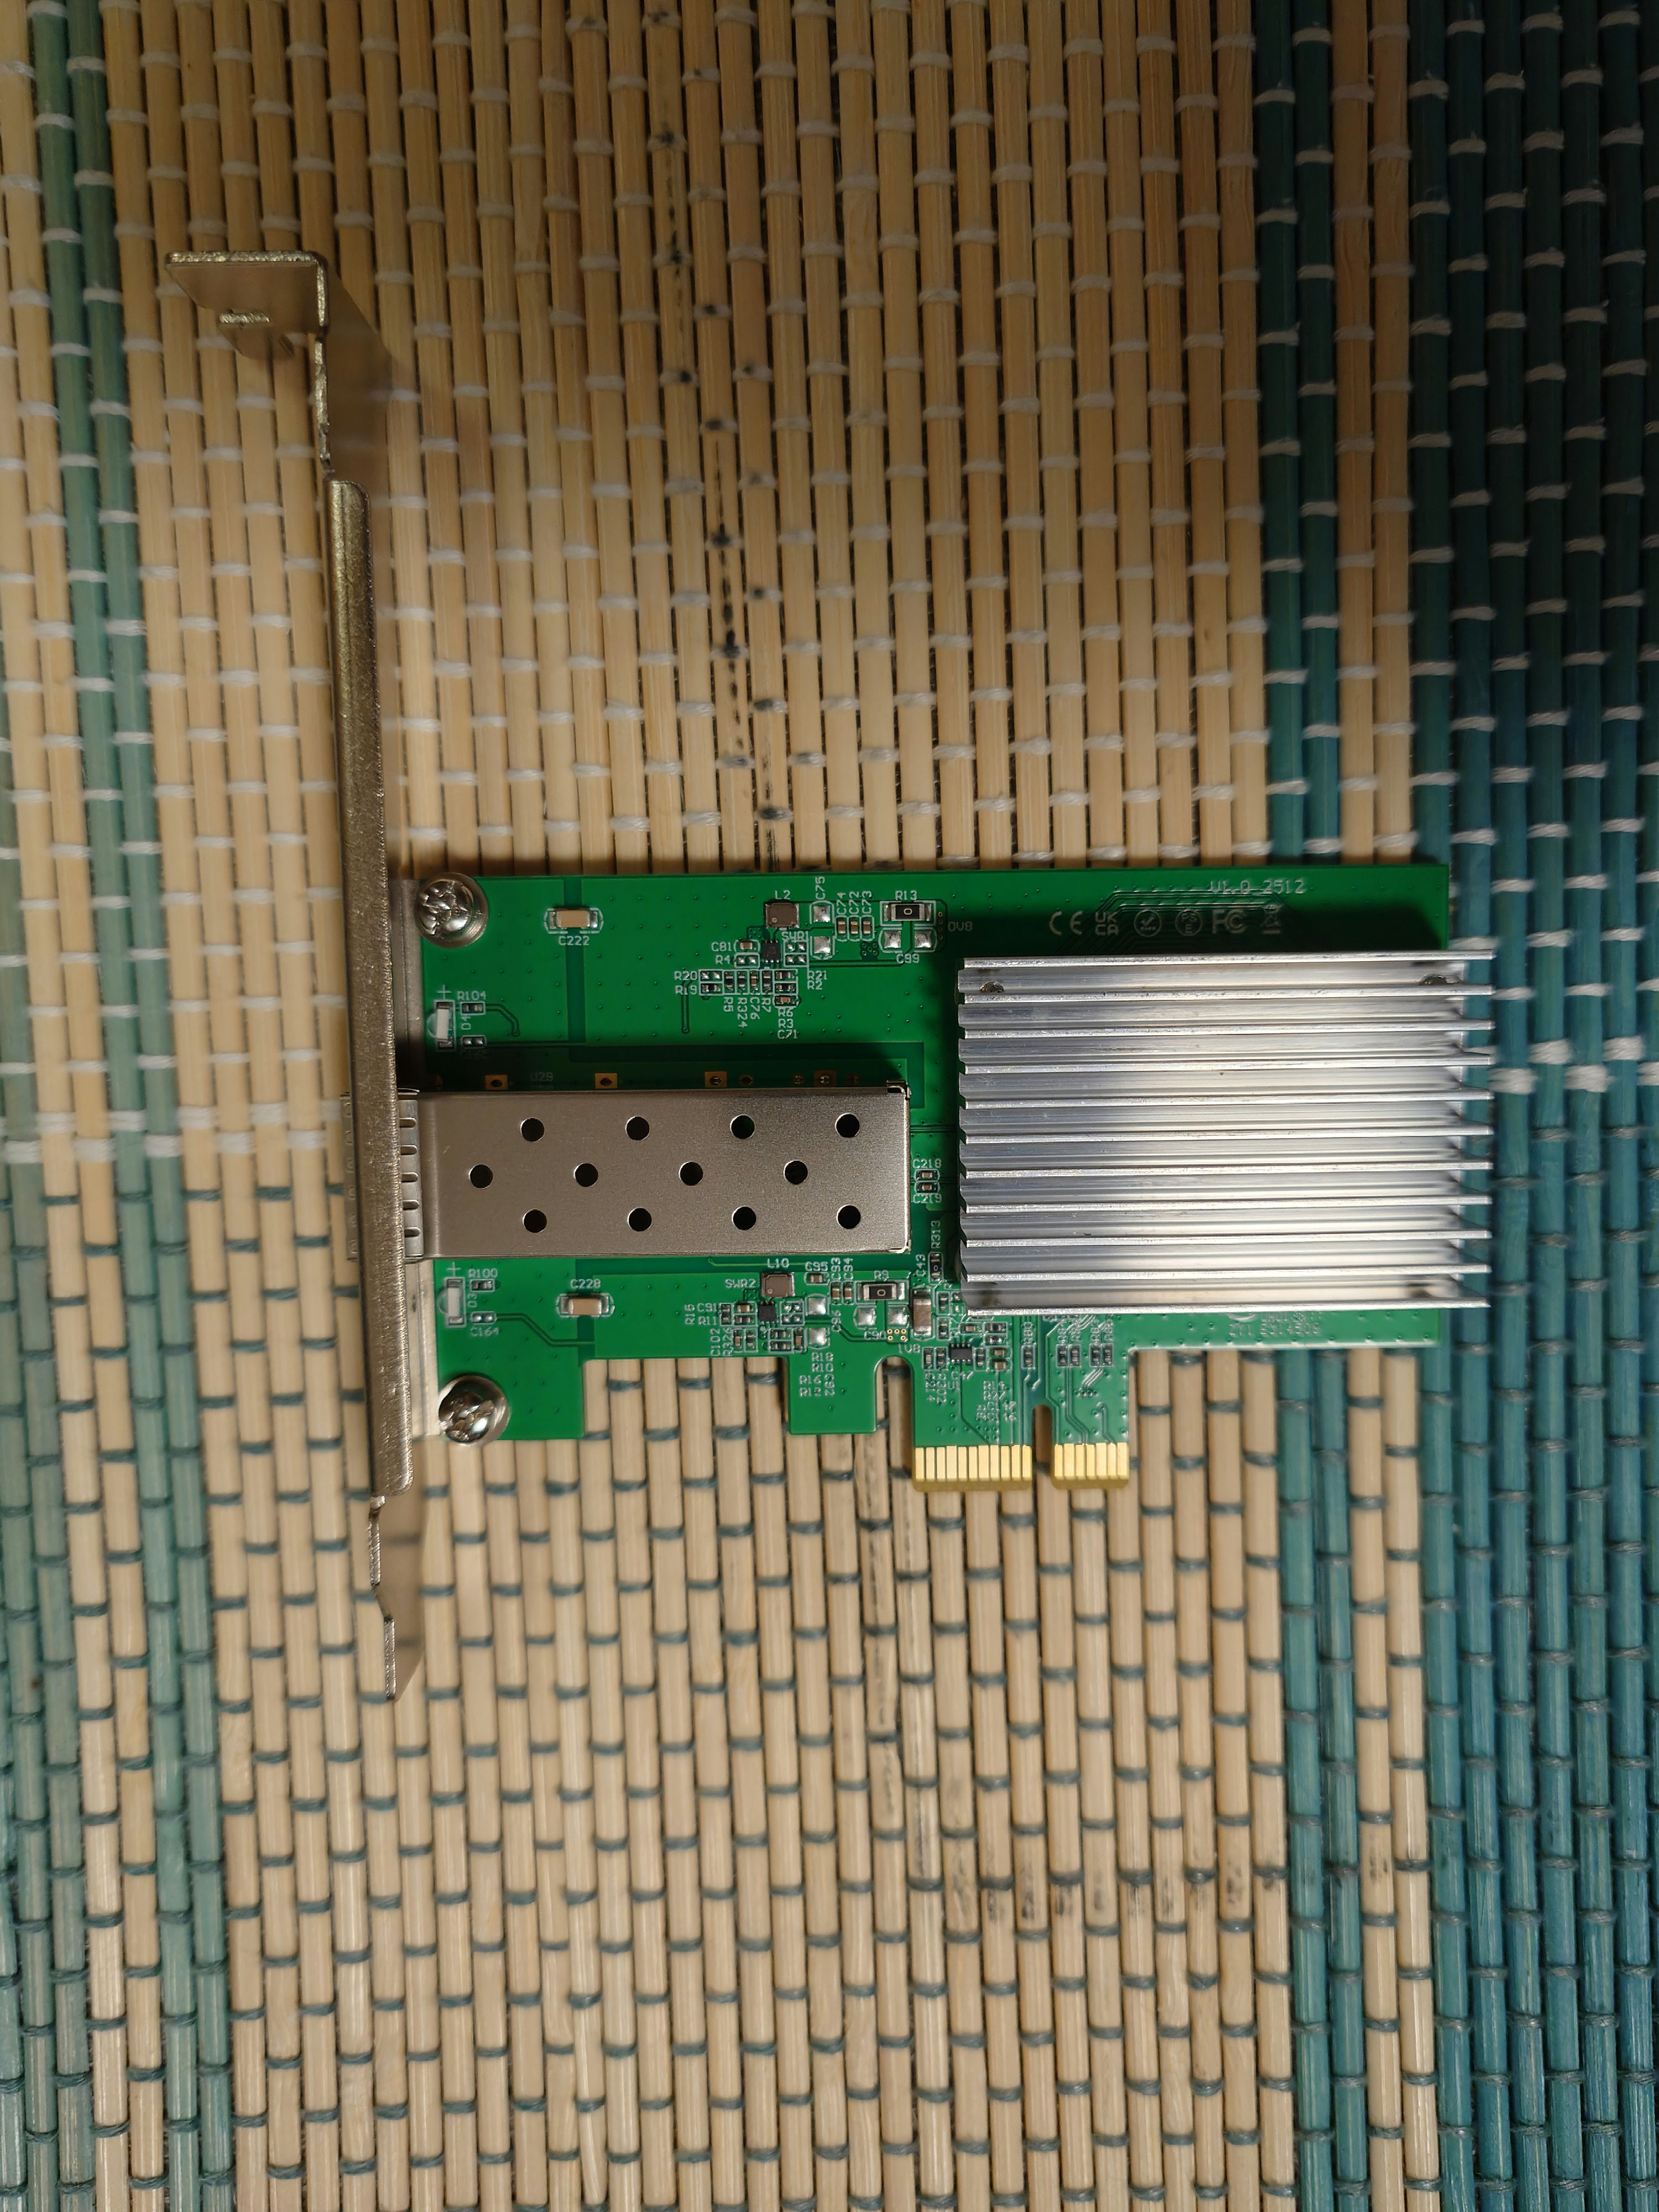
TXA403開封の儀とか

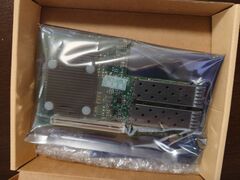
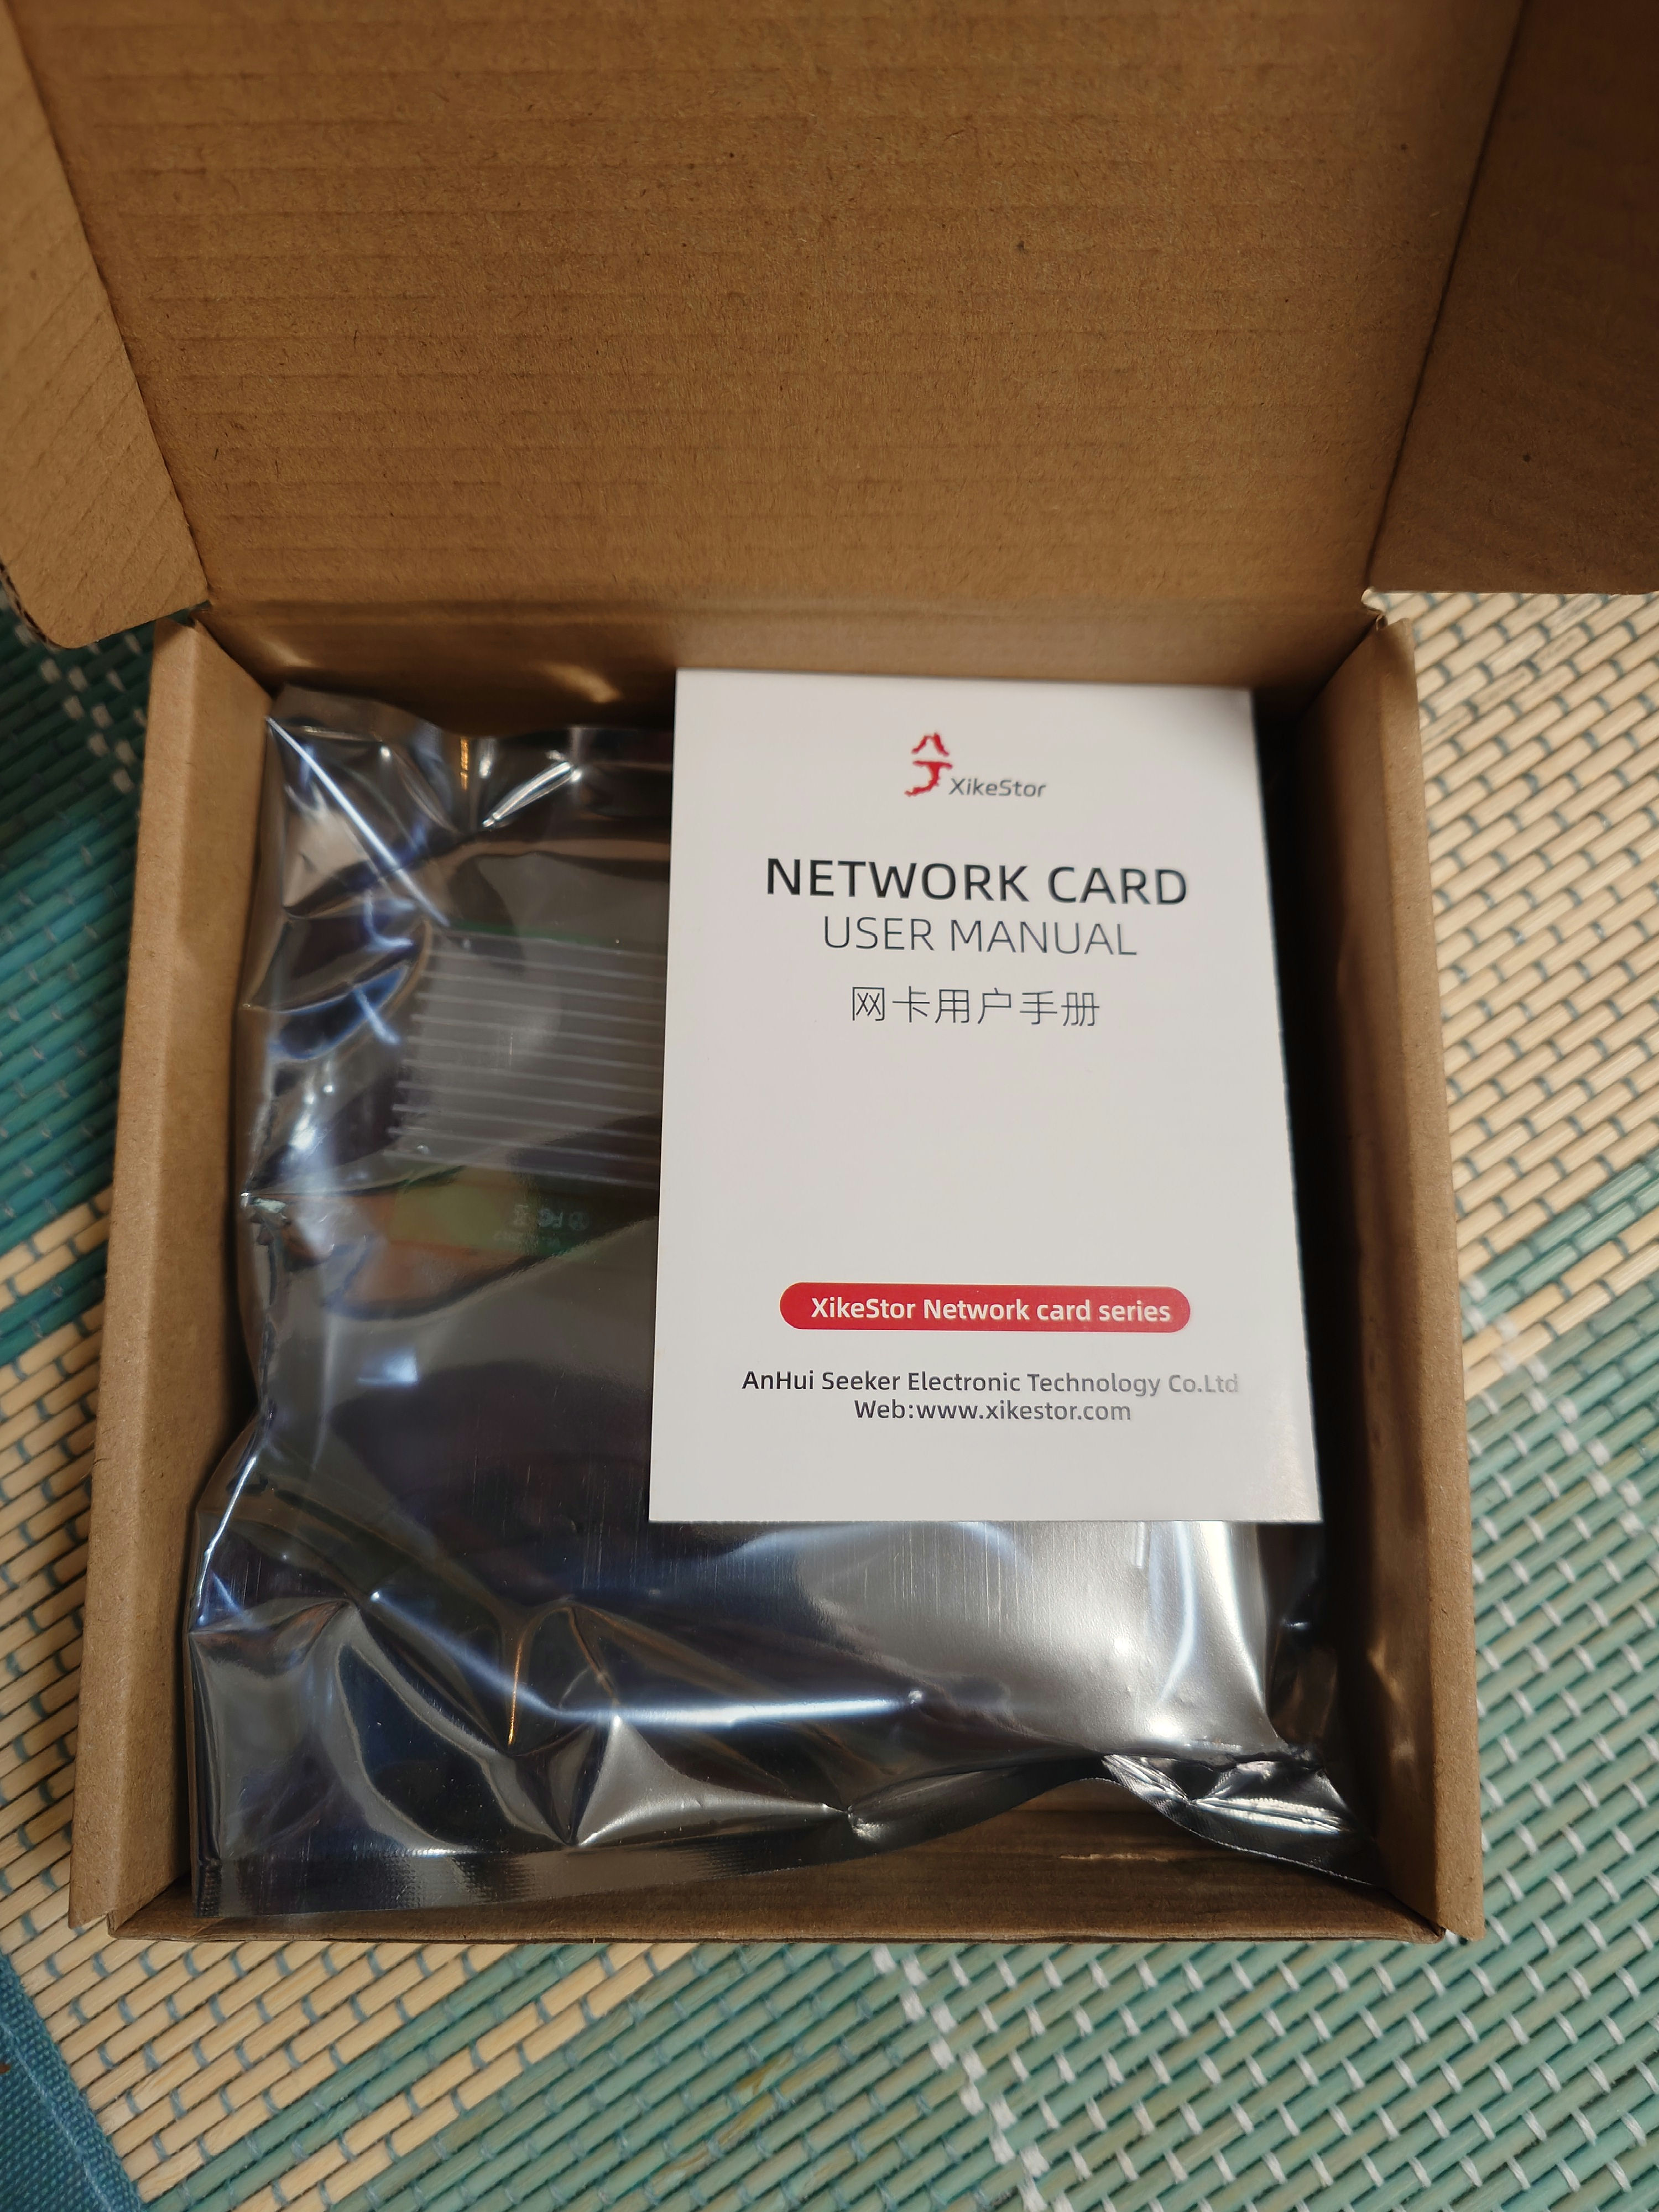
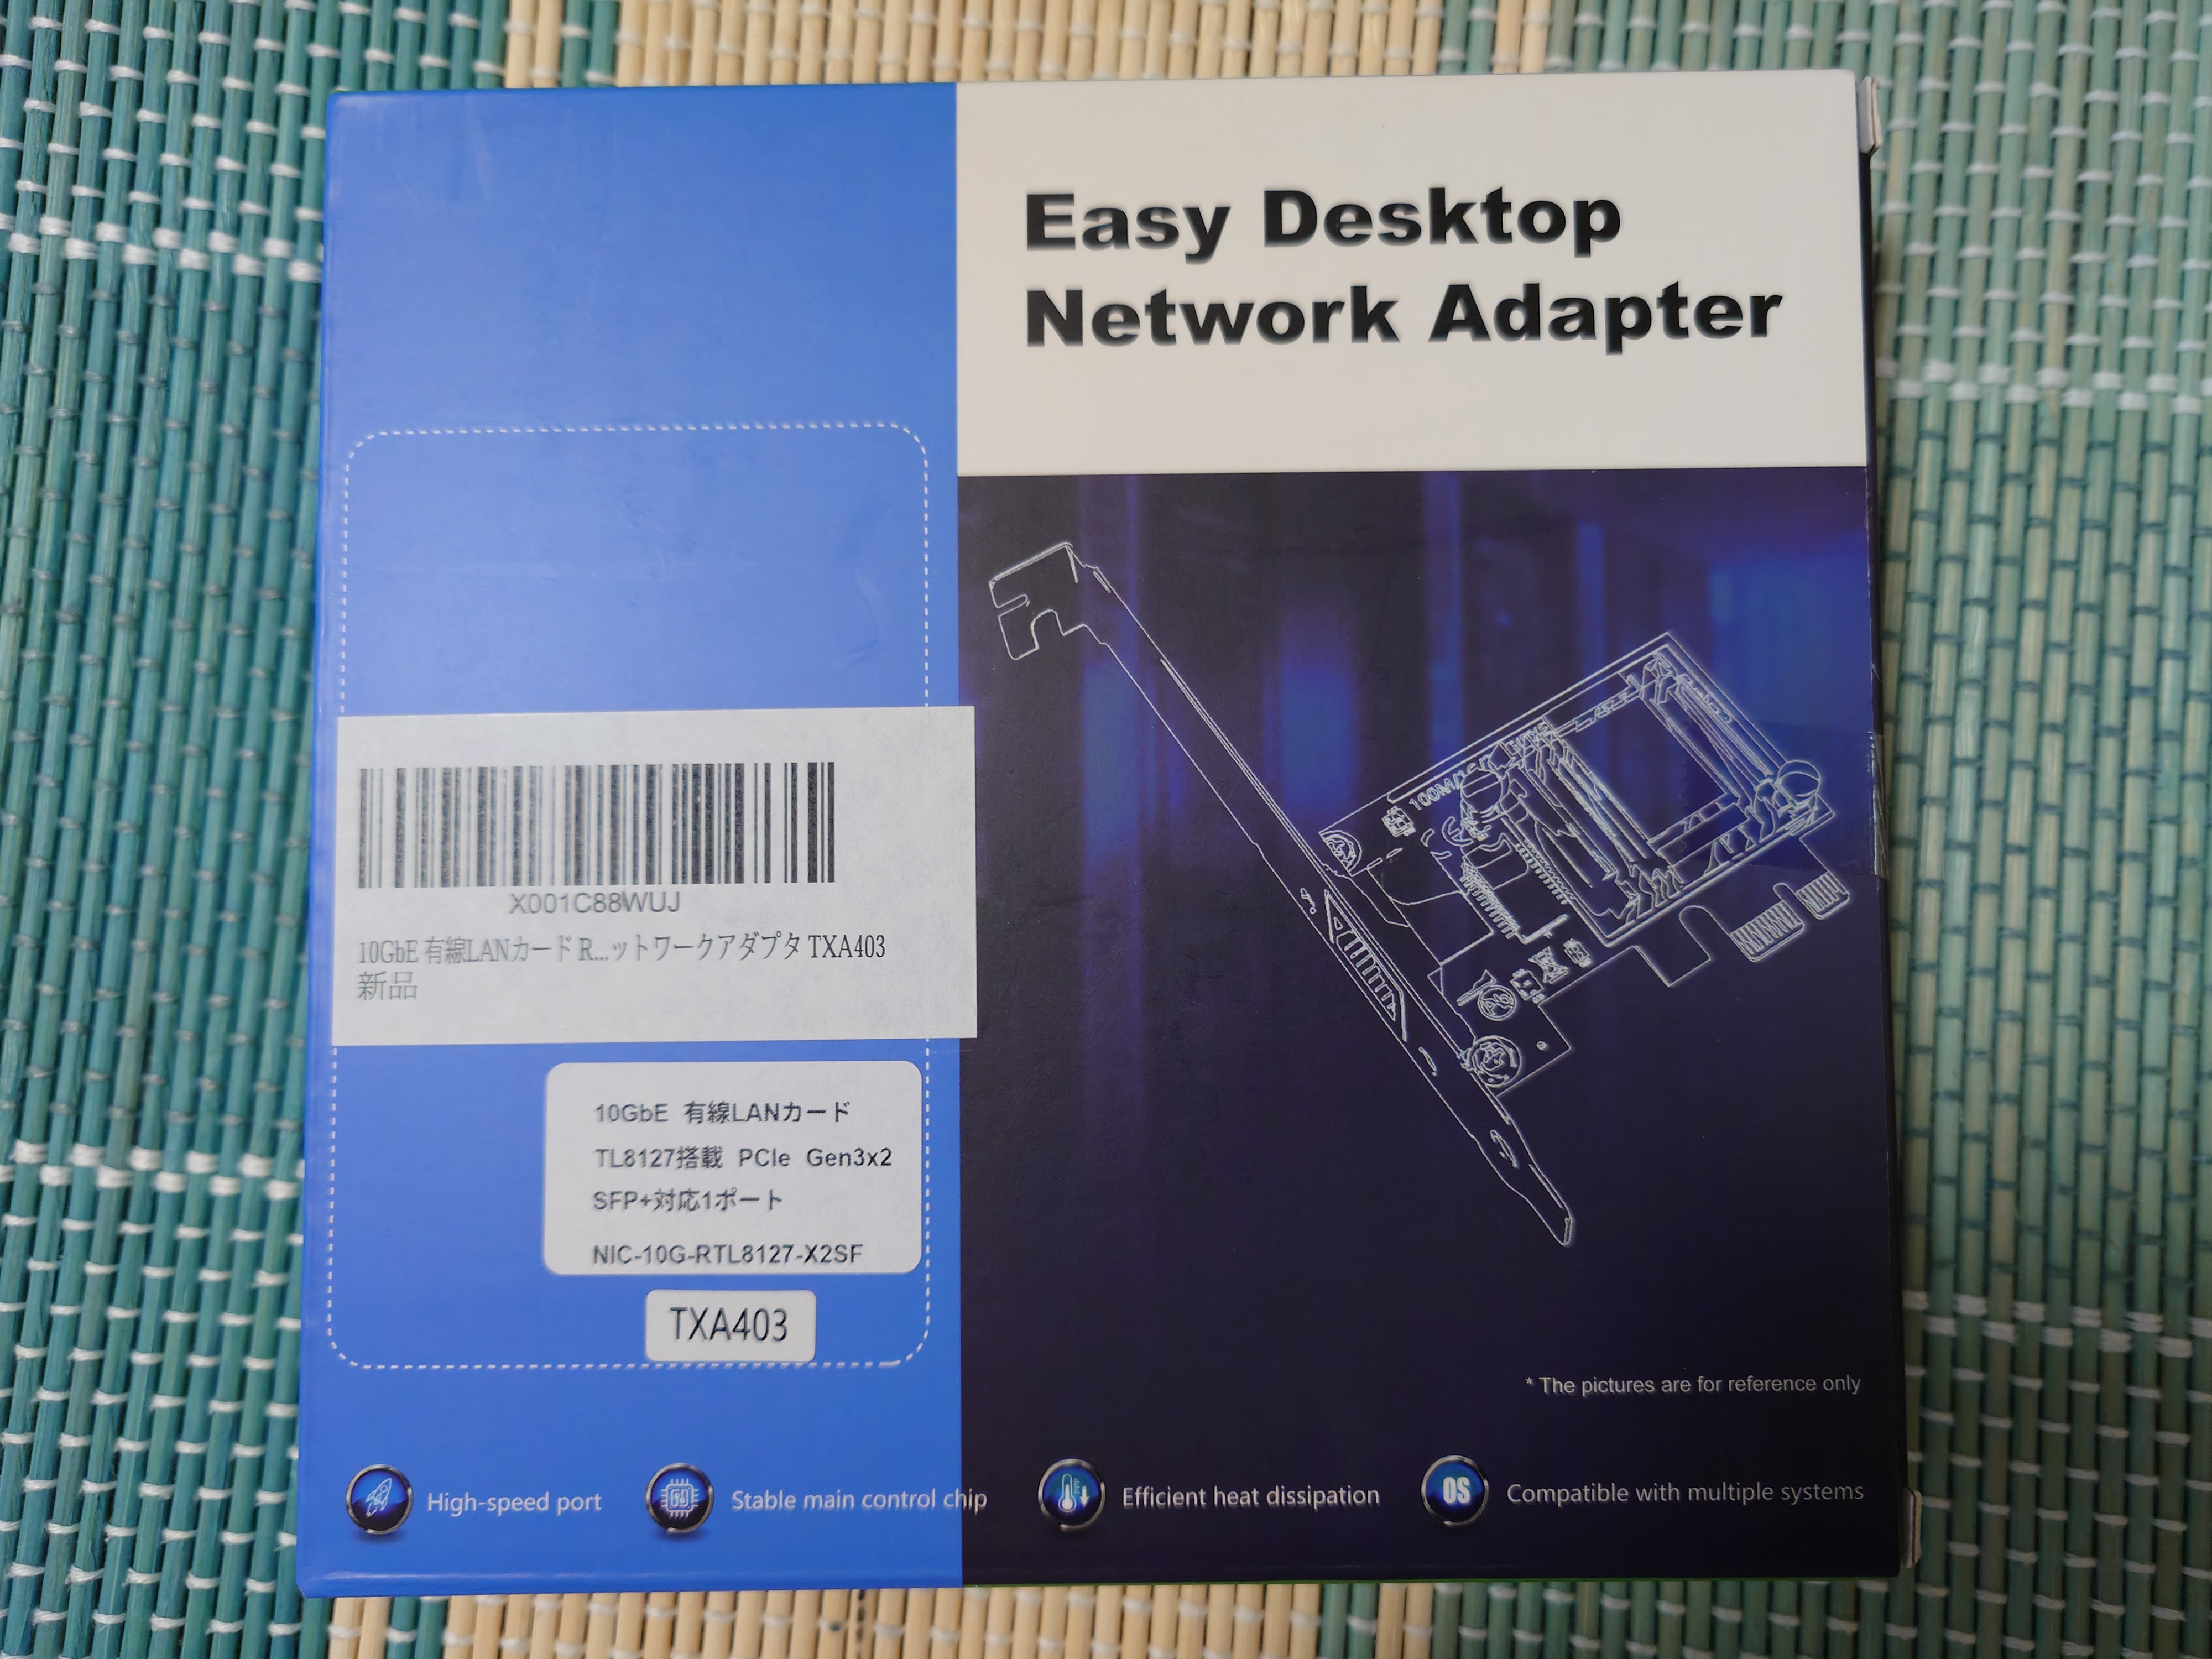
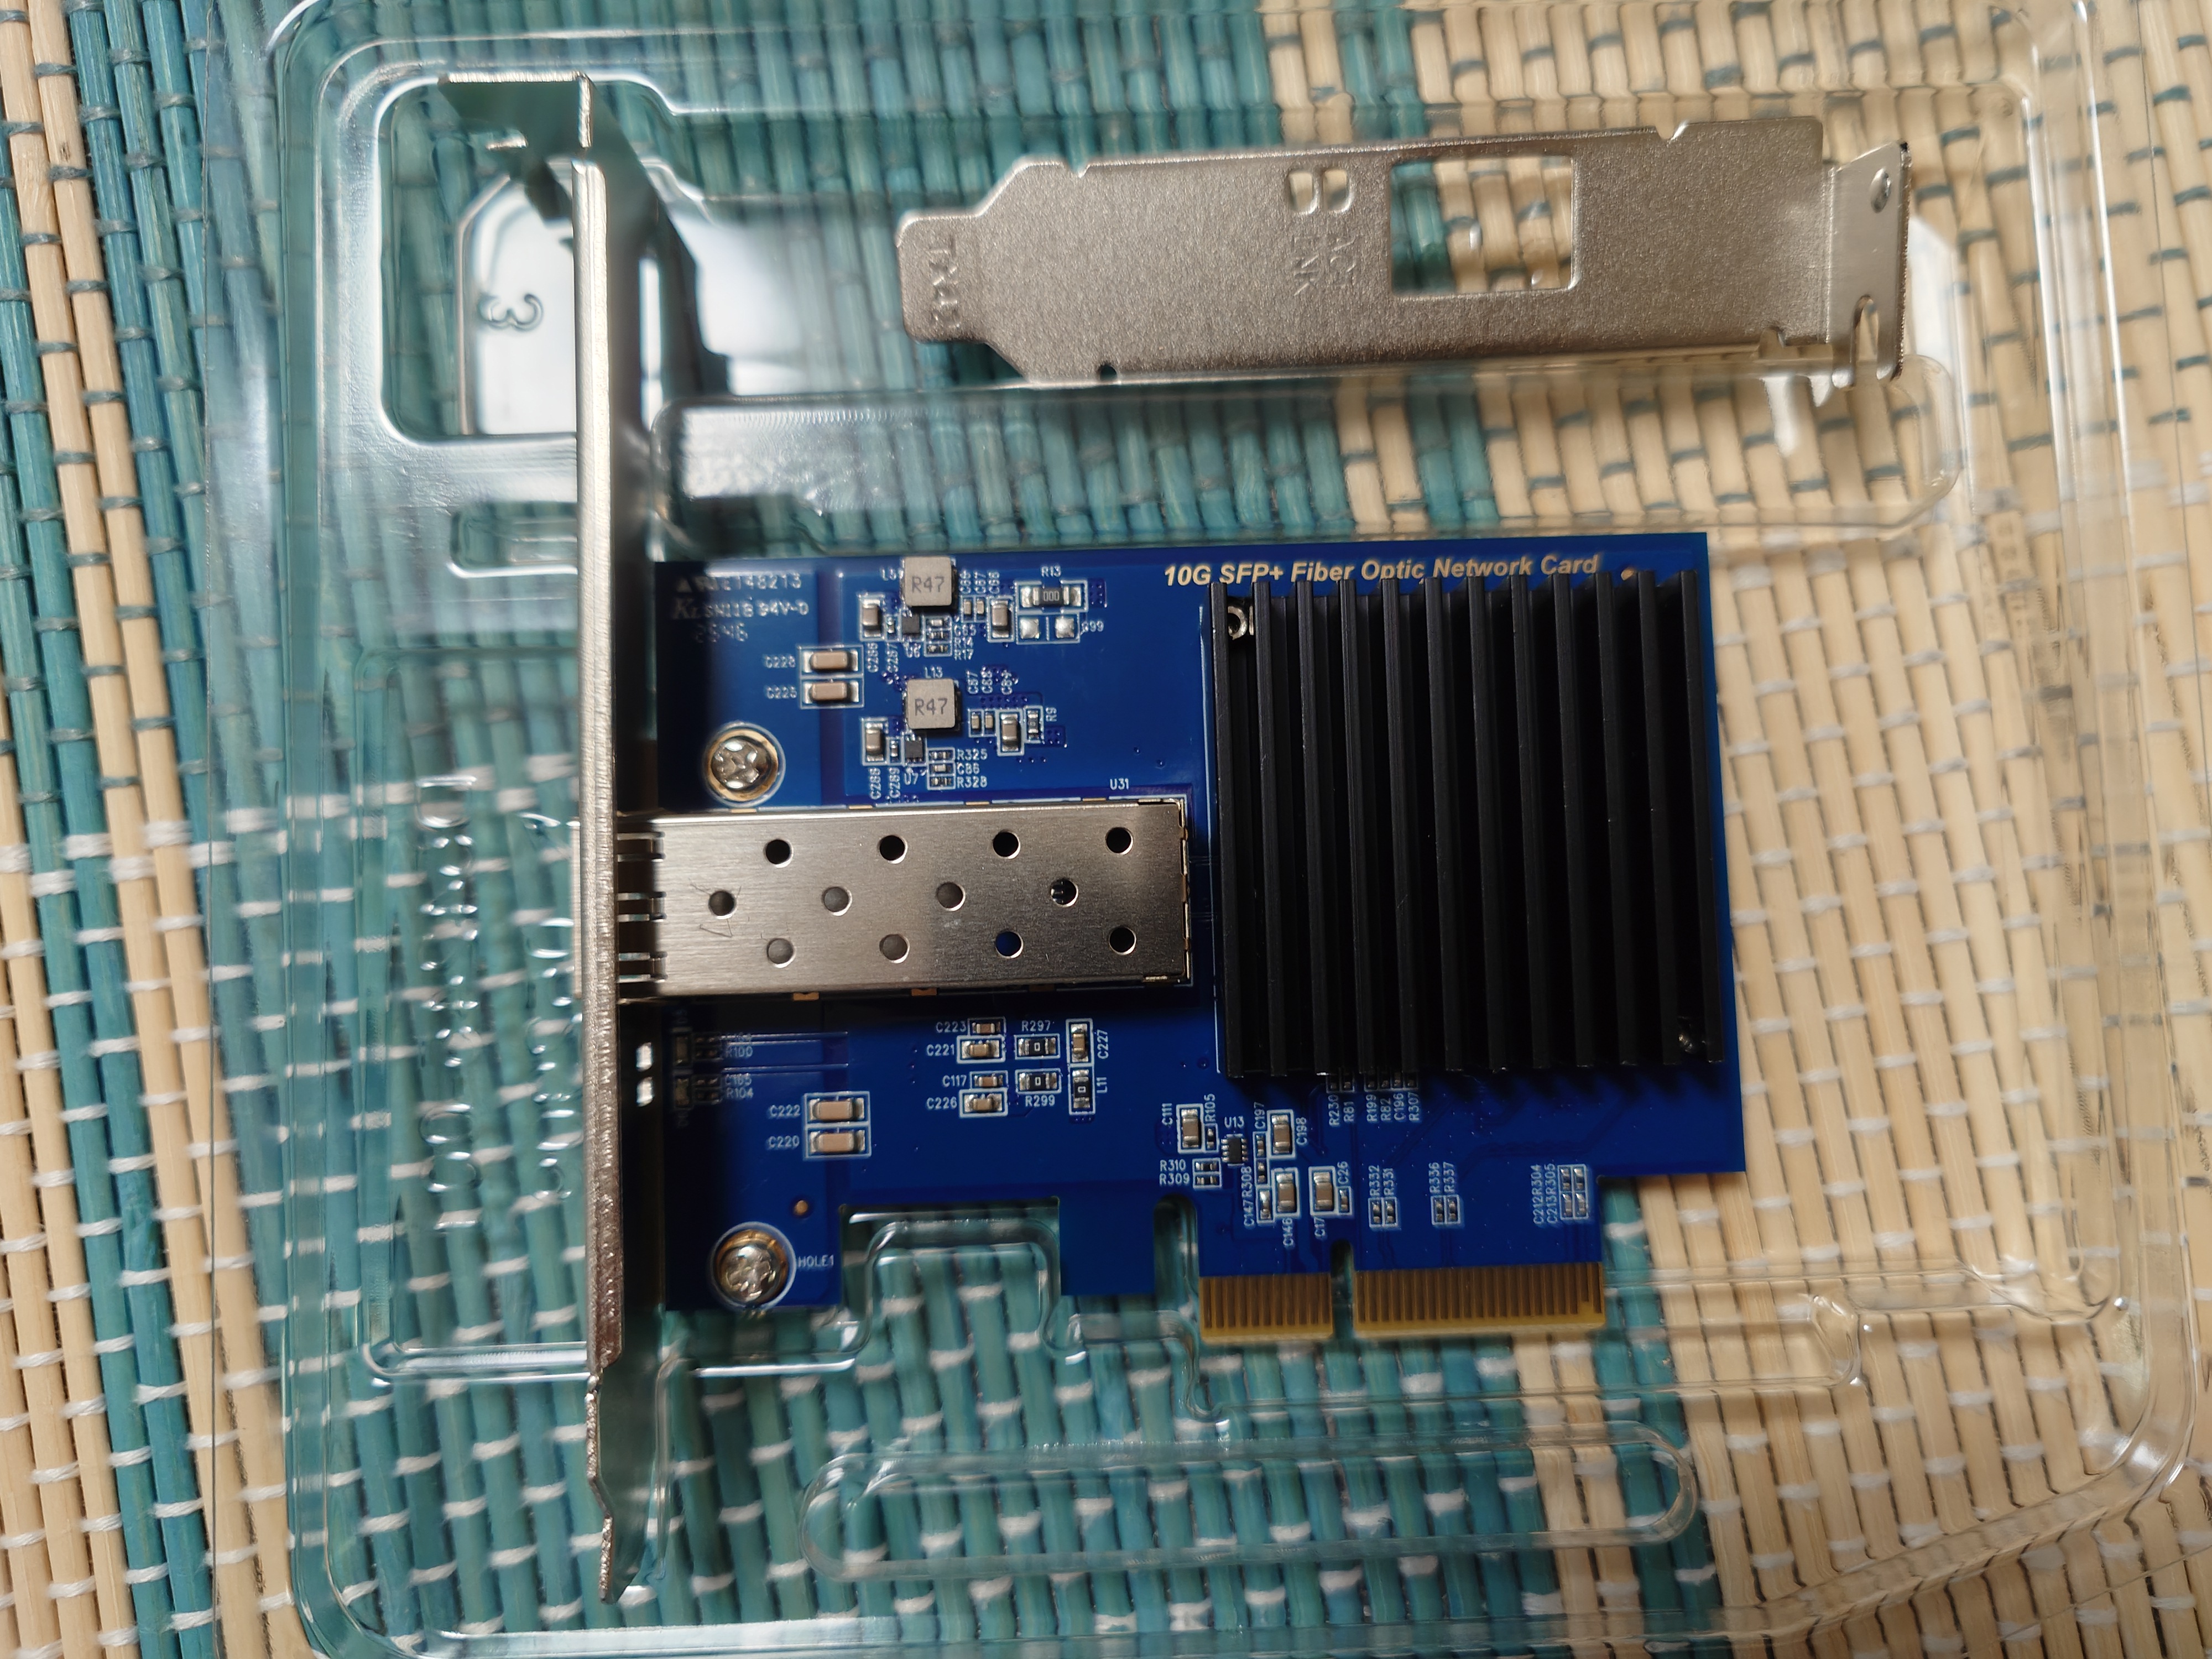
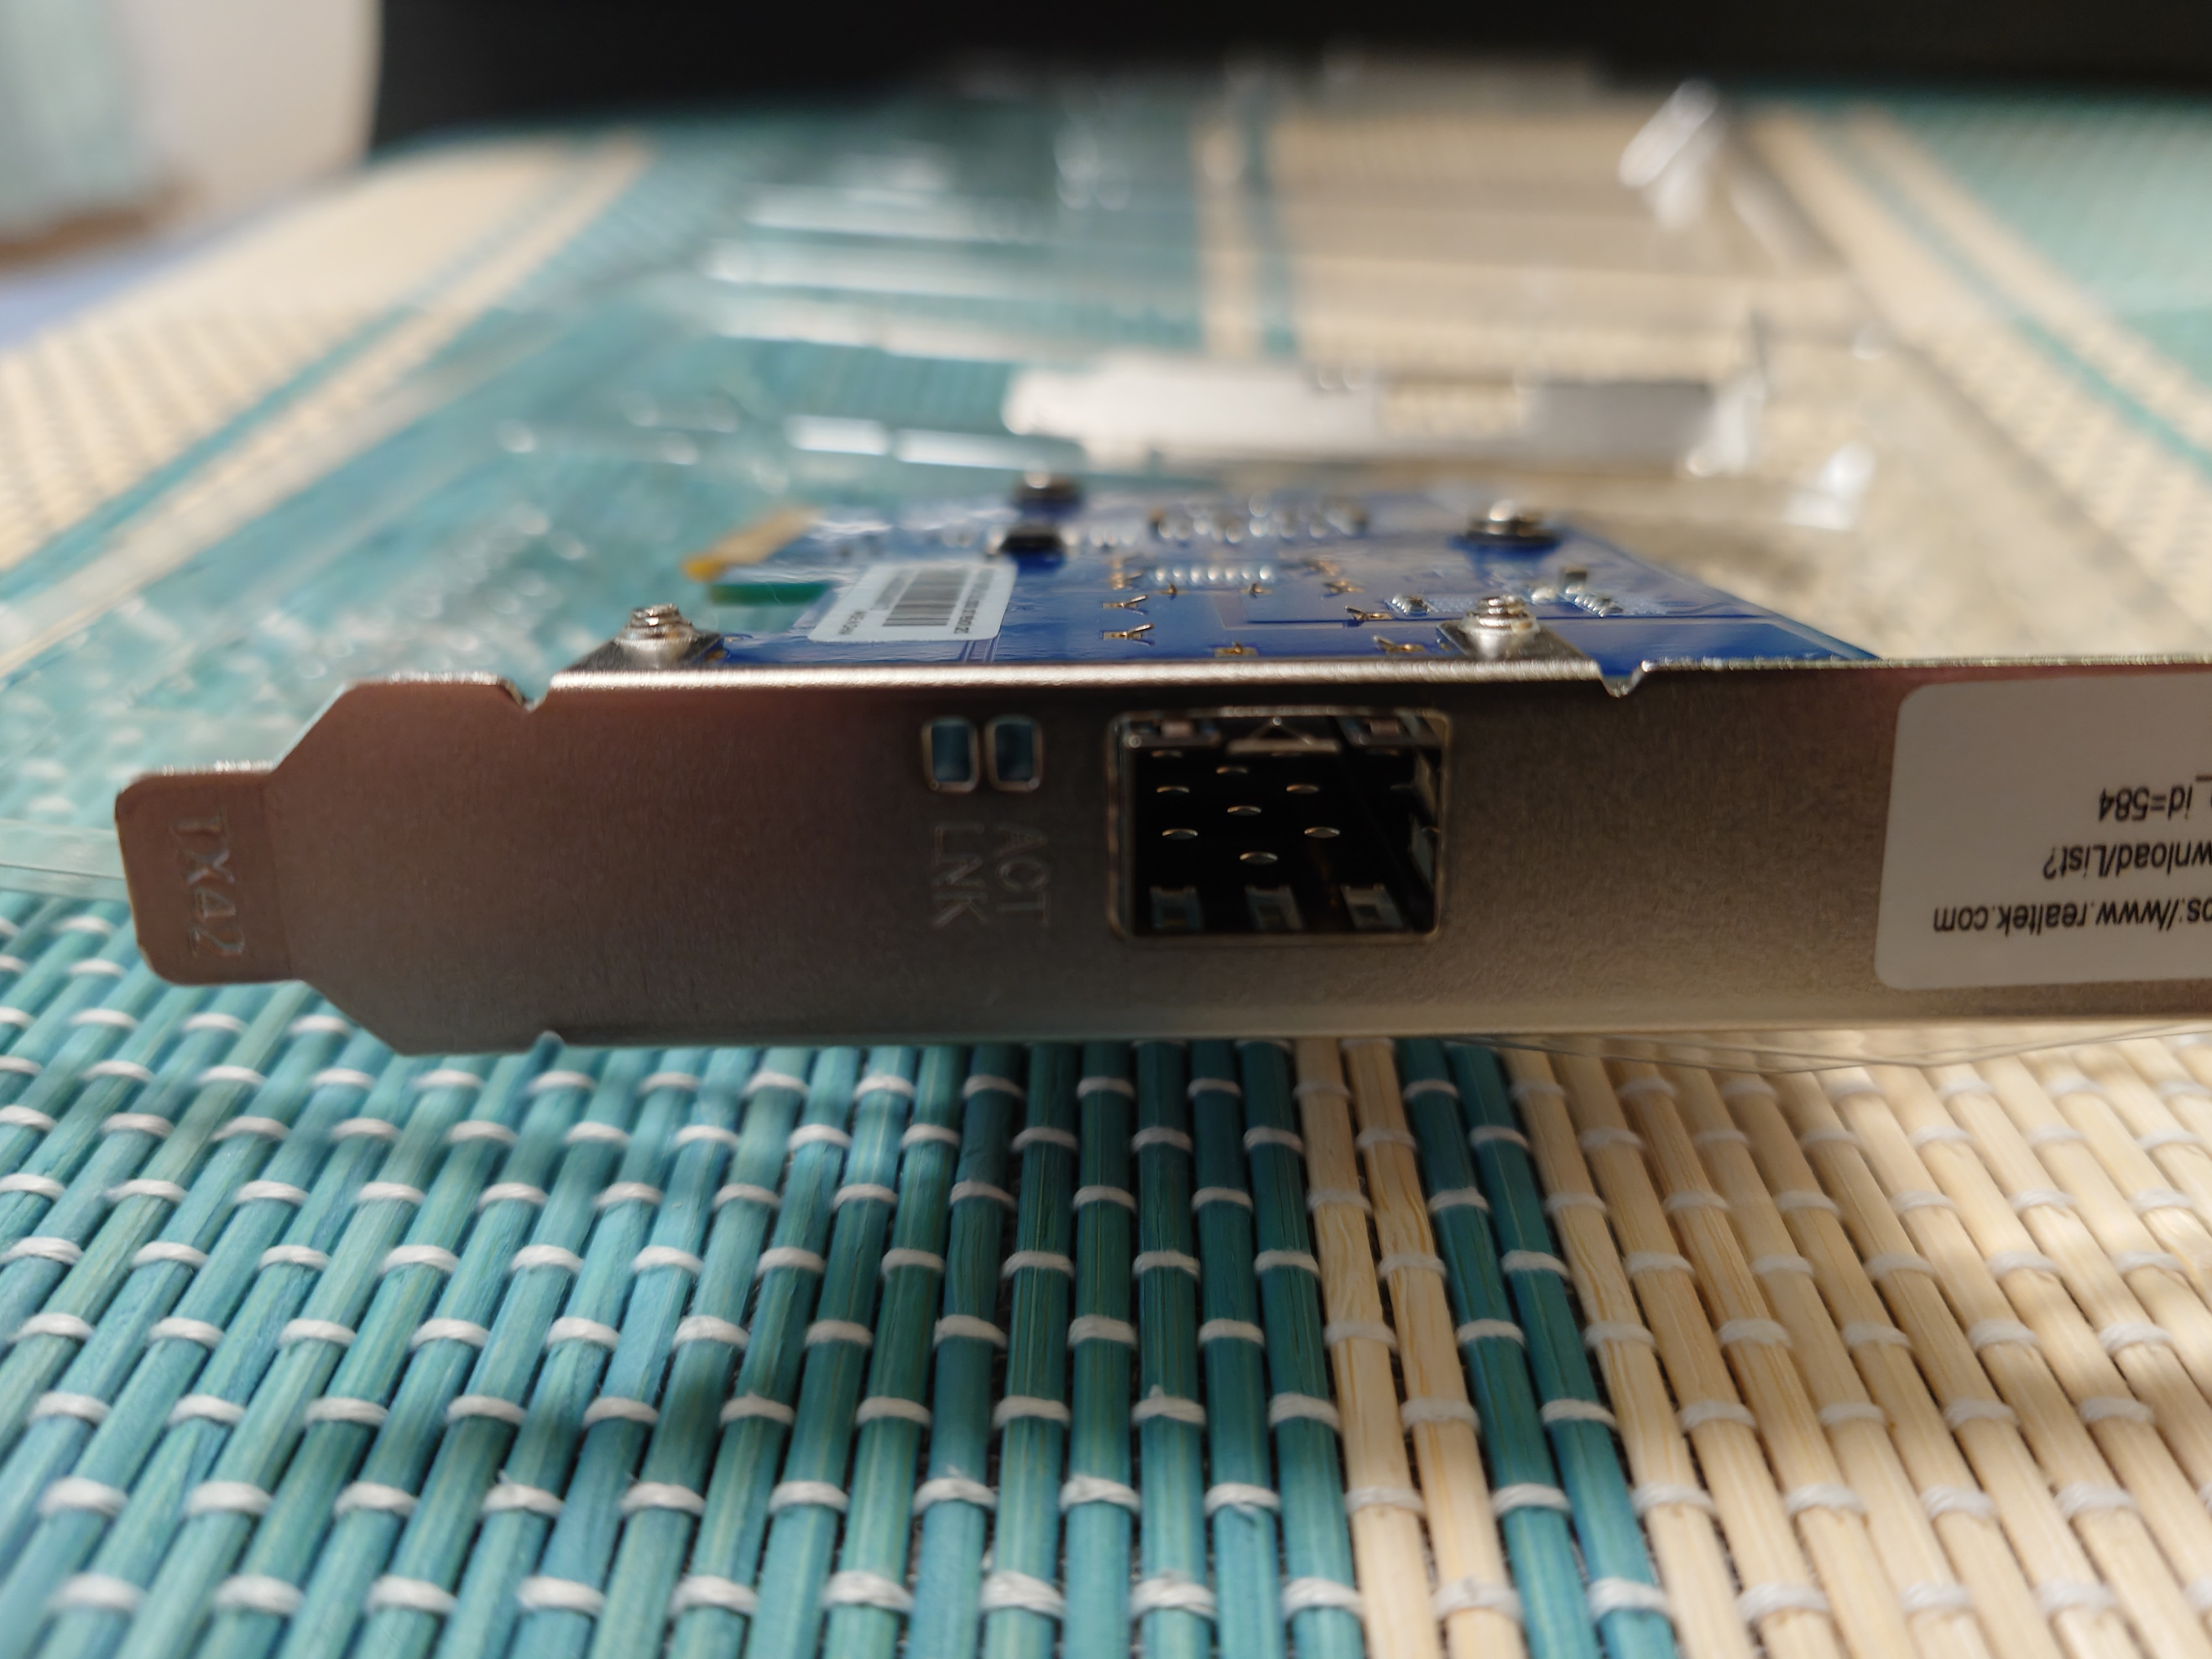
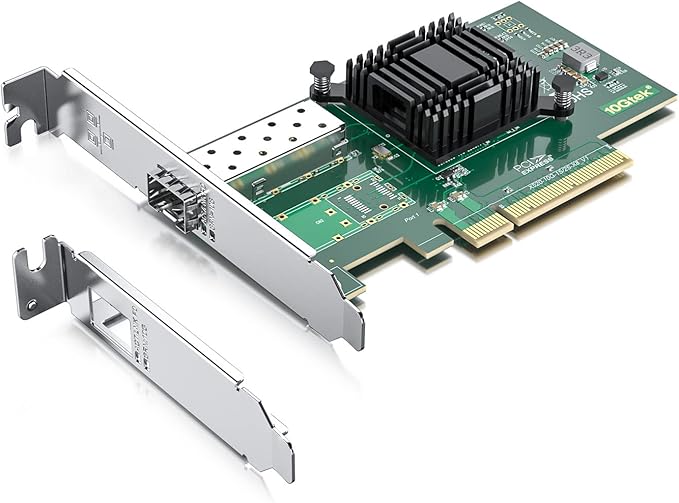
TXA403が届くと箱にRJ45が描かれており、封印もセロテープだったため、一抹の不安に襲われた。

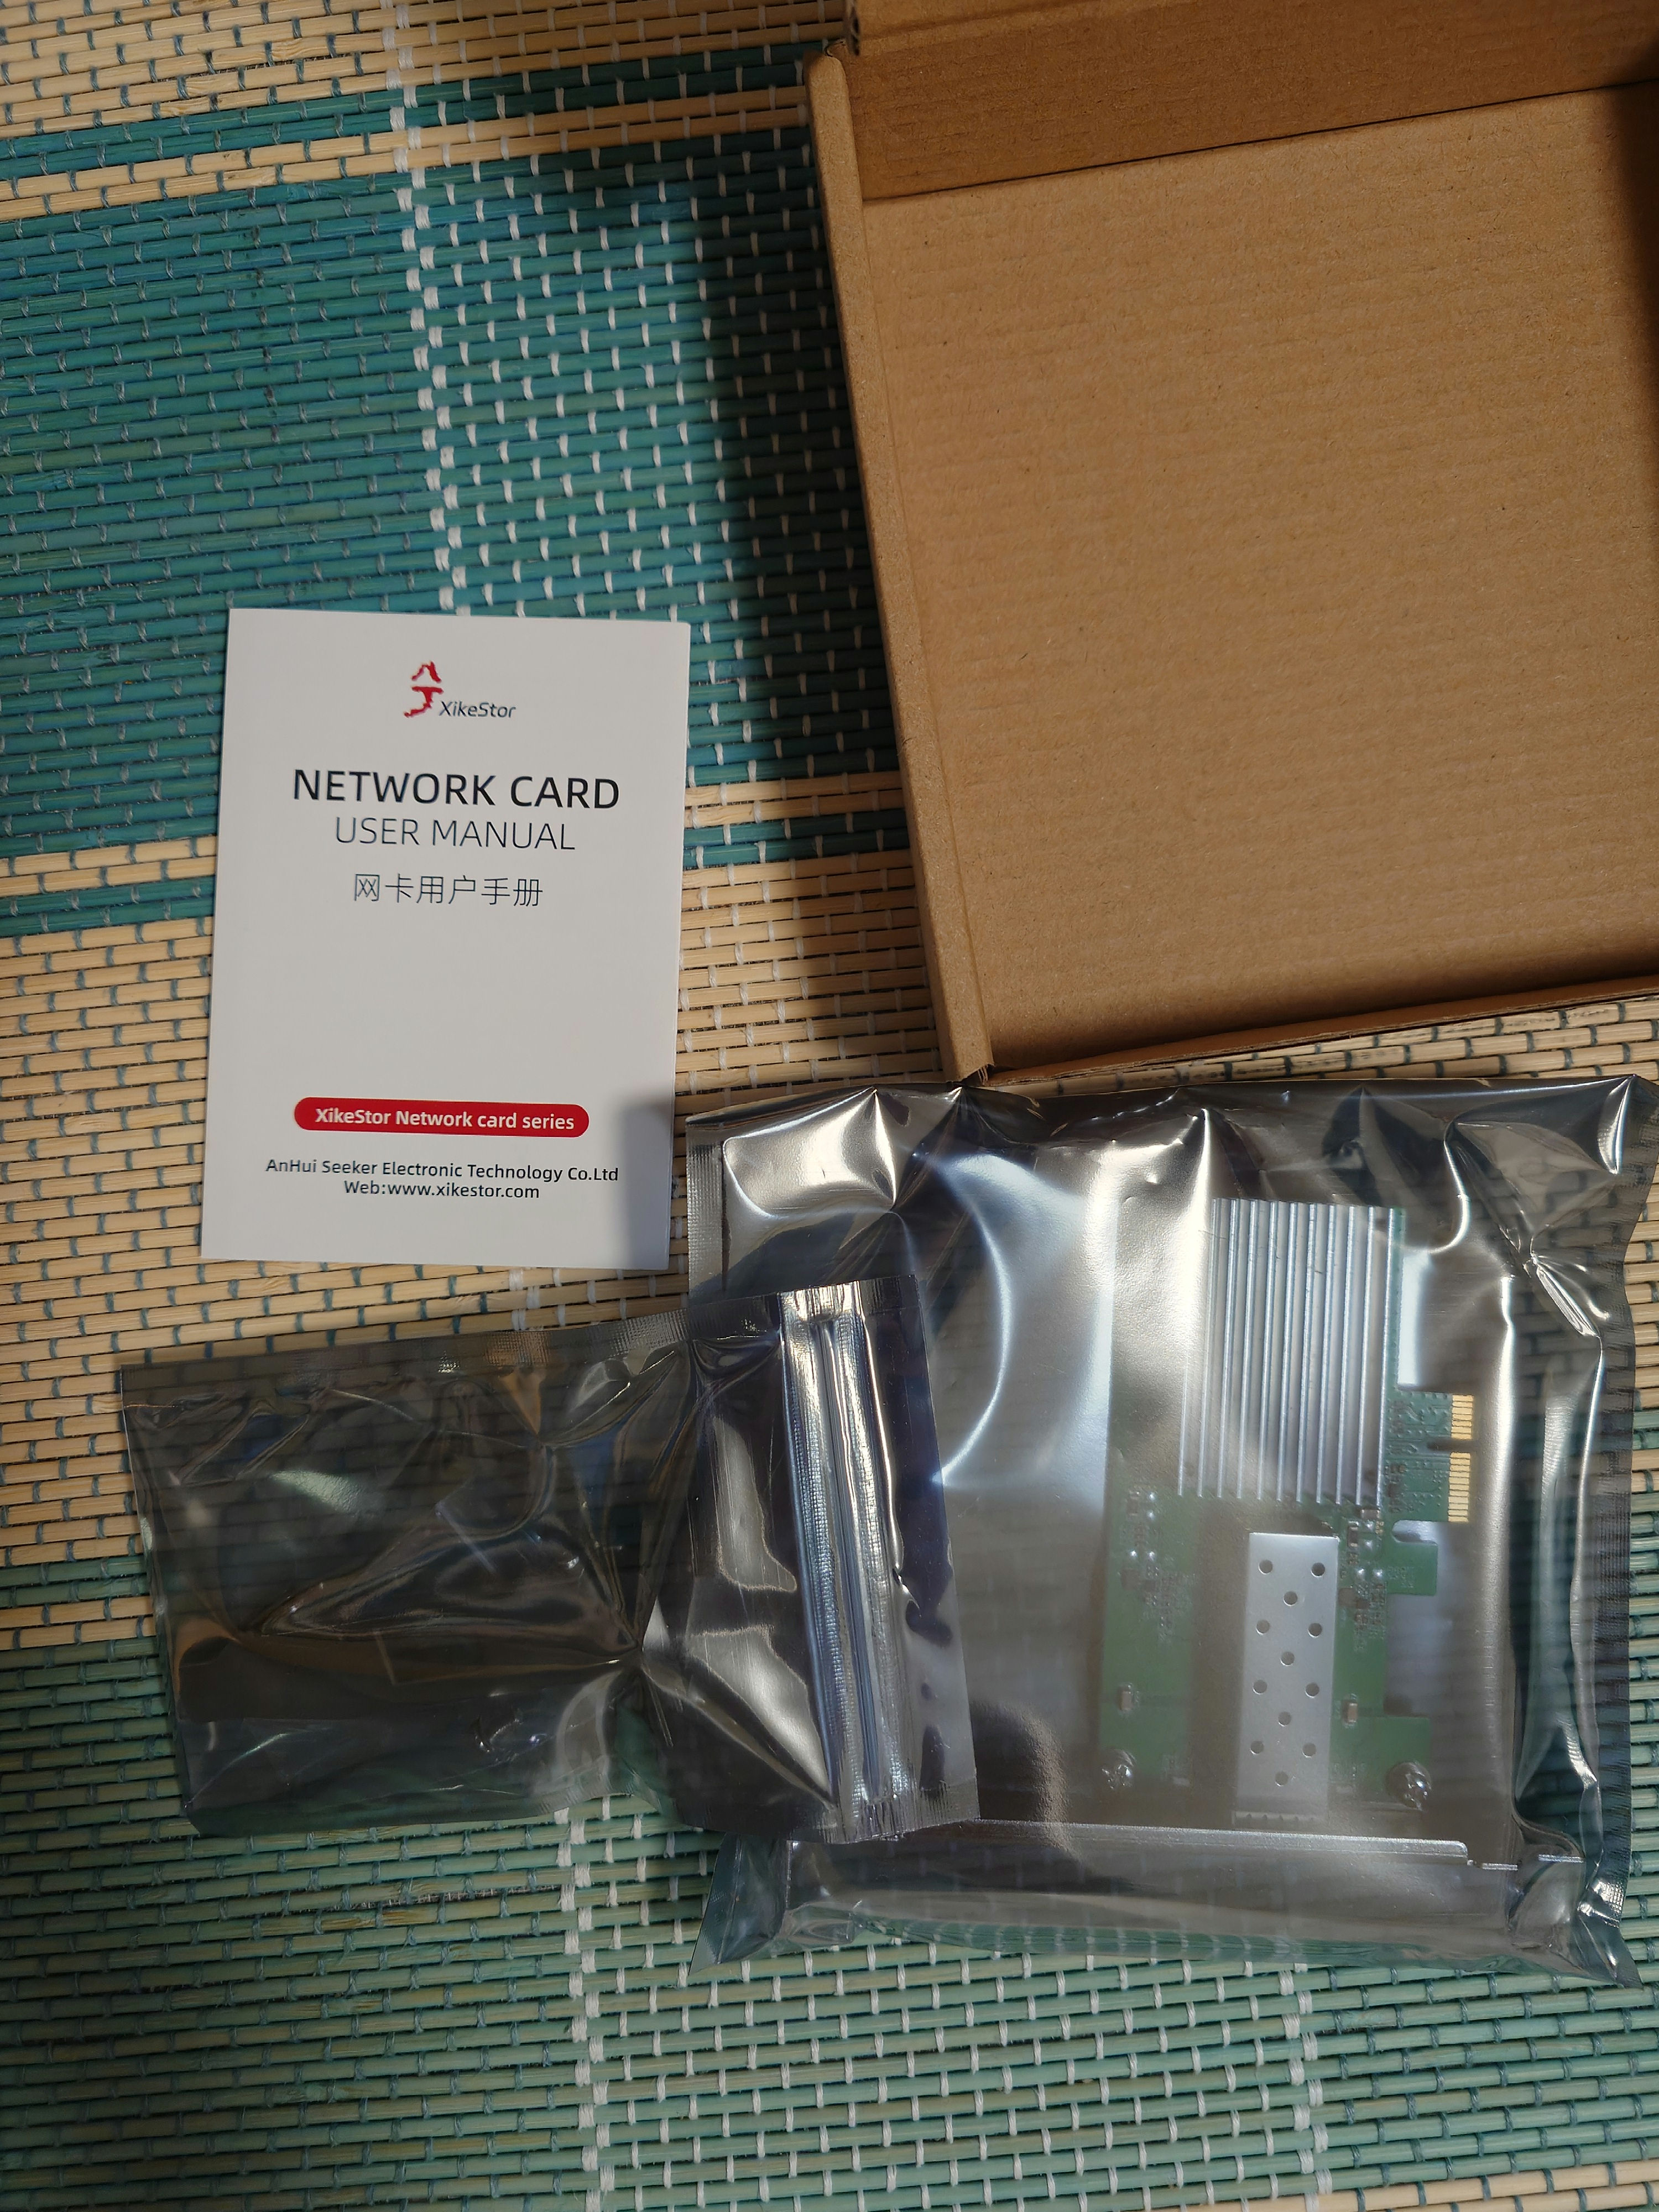
しかし開けてみるとちゃんとSFP+だった。手抜きか?

SKN-8127AF-X1と比べると内容は随分簡素で、個別の袋やネジ、取説はなかったが、あっちが無駄に豪華すぎるだけで別にこれでいい気がした。

ヒートシンクをSKN-8127AF-X1と比較すると目が少なく、向きも違うので若干冷却性能は下がるかもしれないが、恐らく問題になることはないだろう。

コネクタはPCIe3.0x4で、PCIe4.0x1だったSKN-8127AF-X1と比べると大きかった。

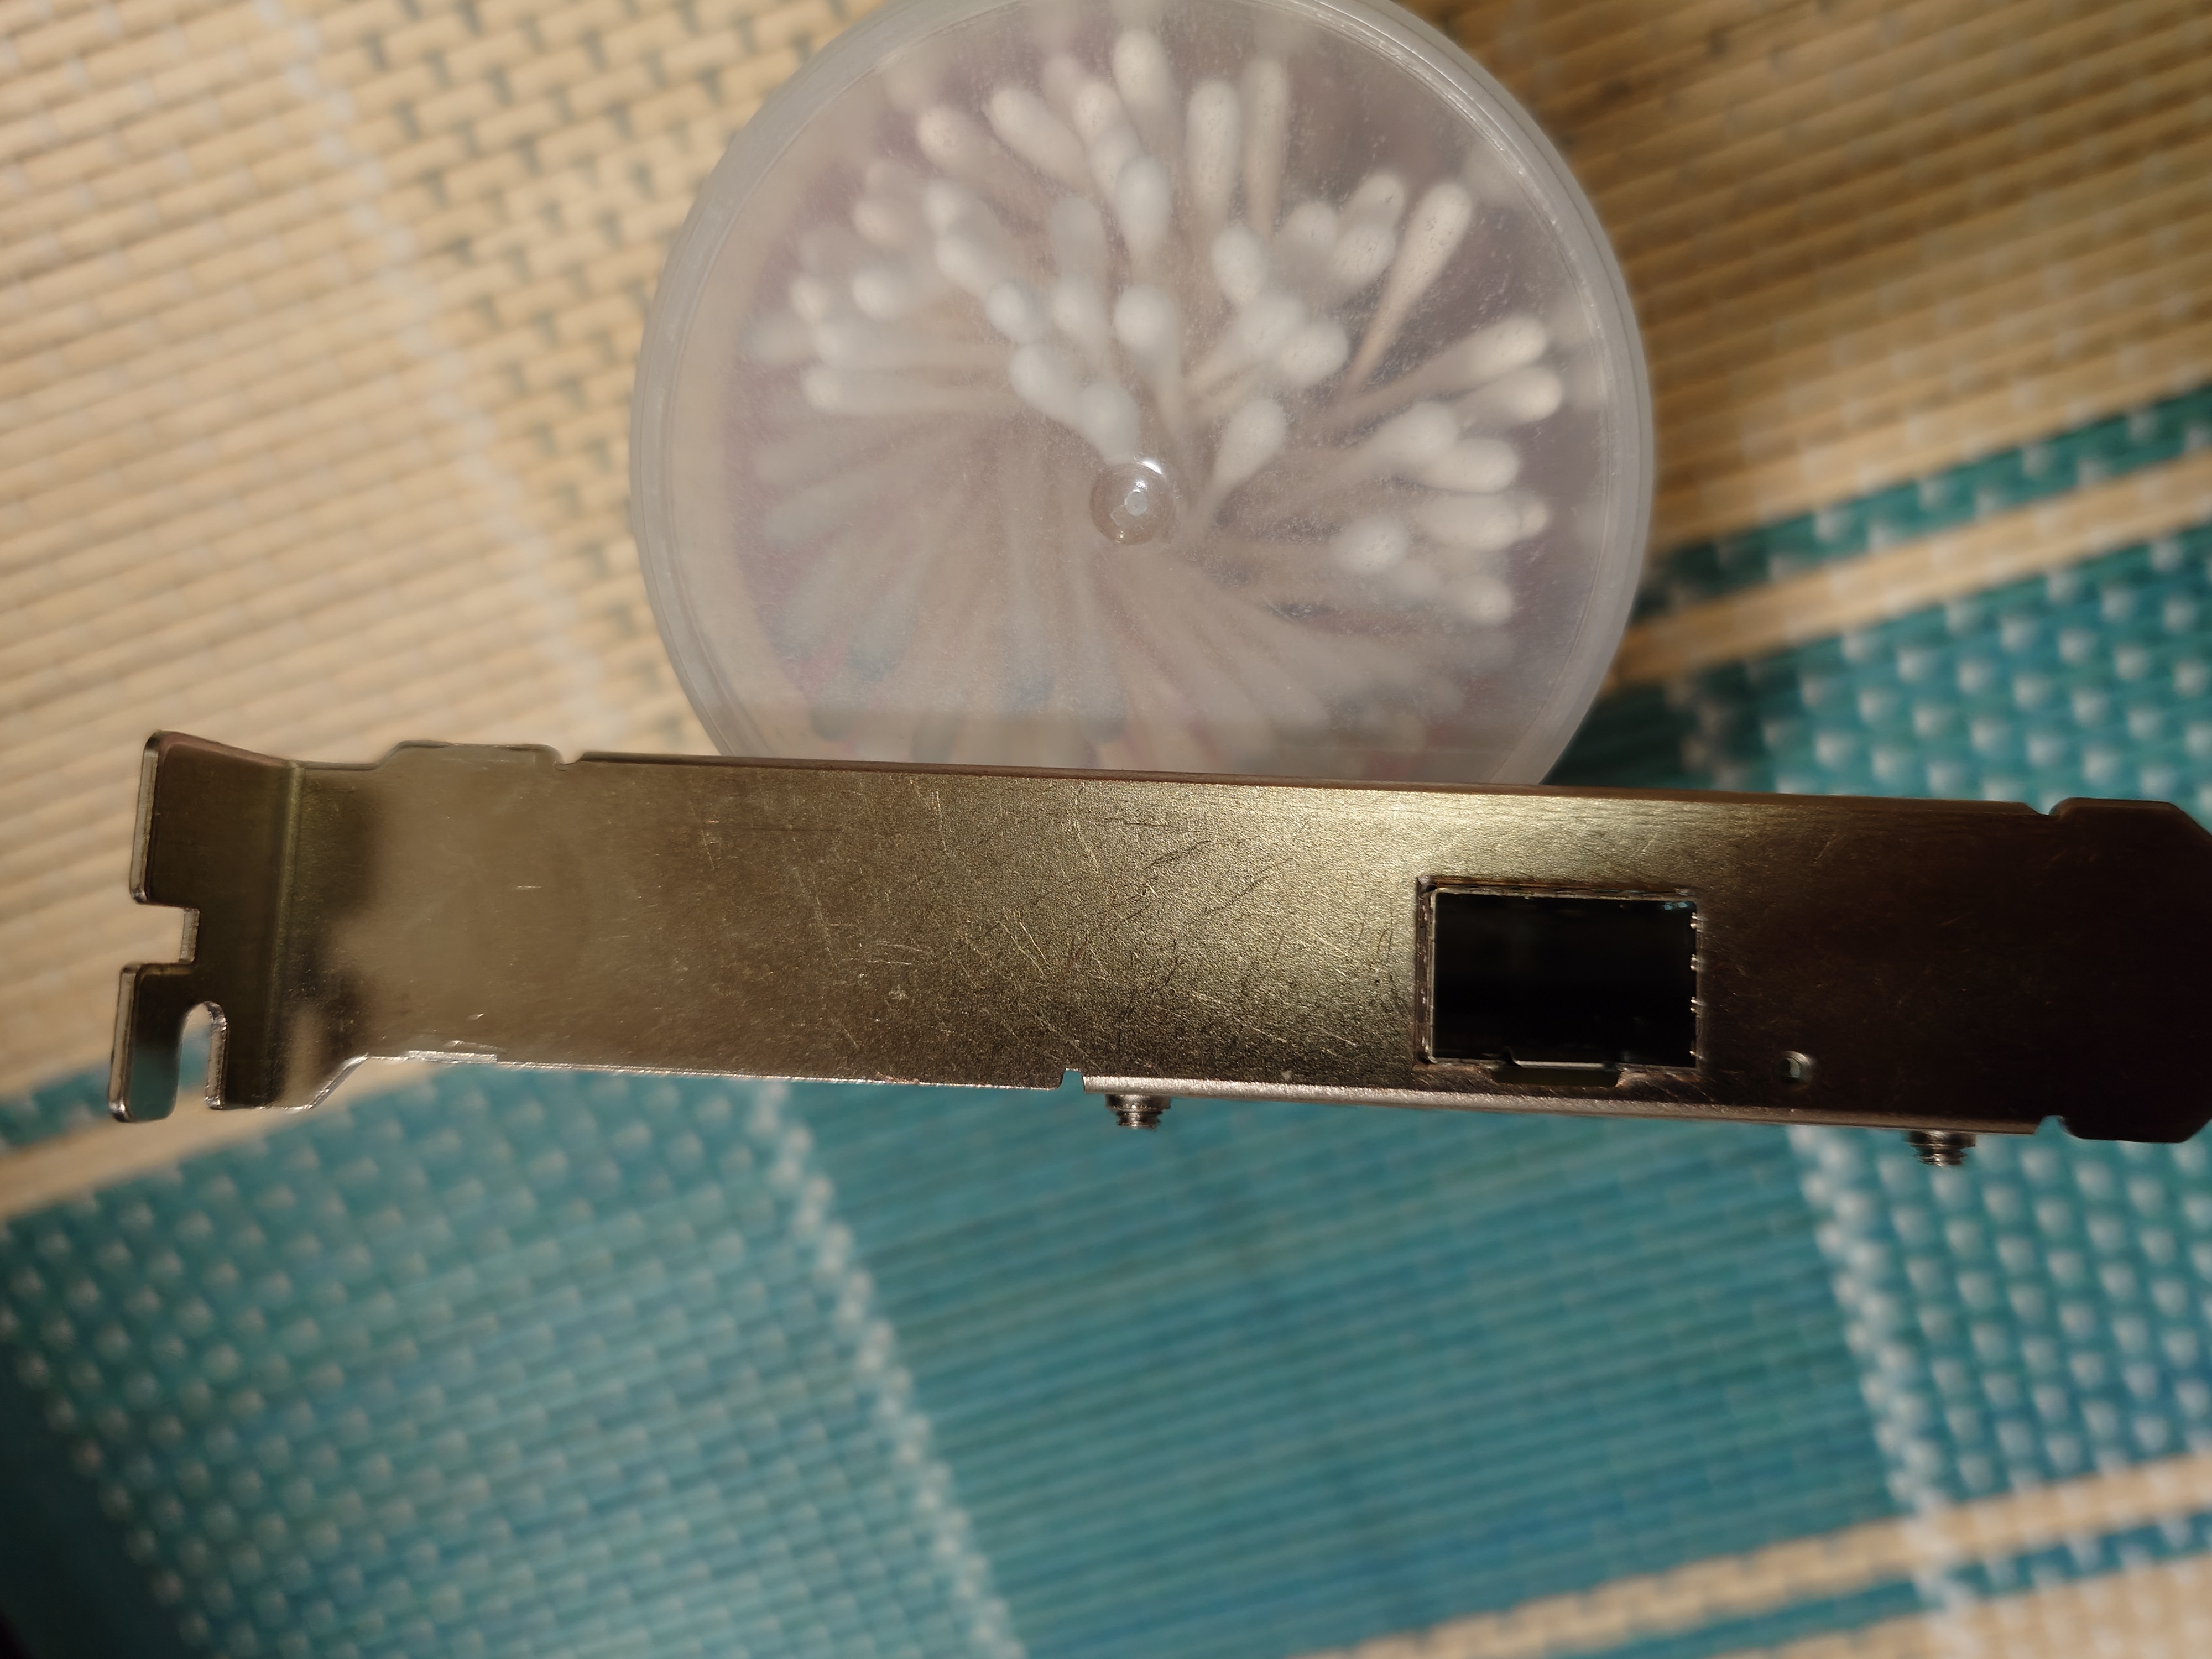
ブラケットもピカピカで問題なかった。

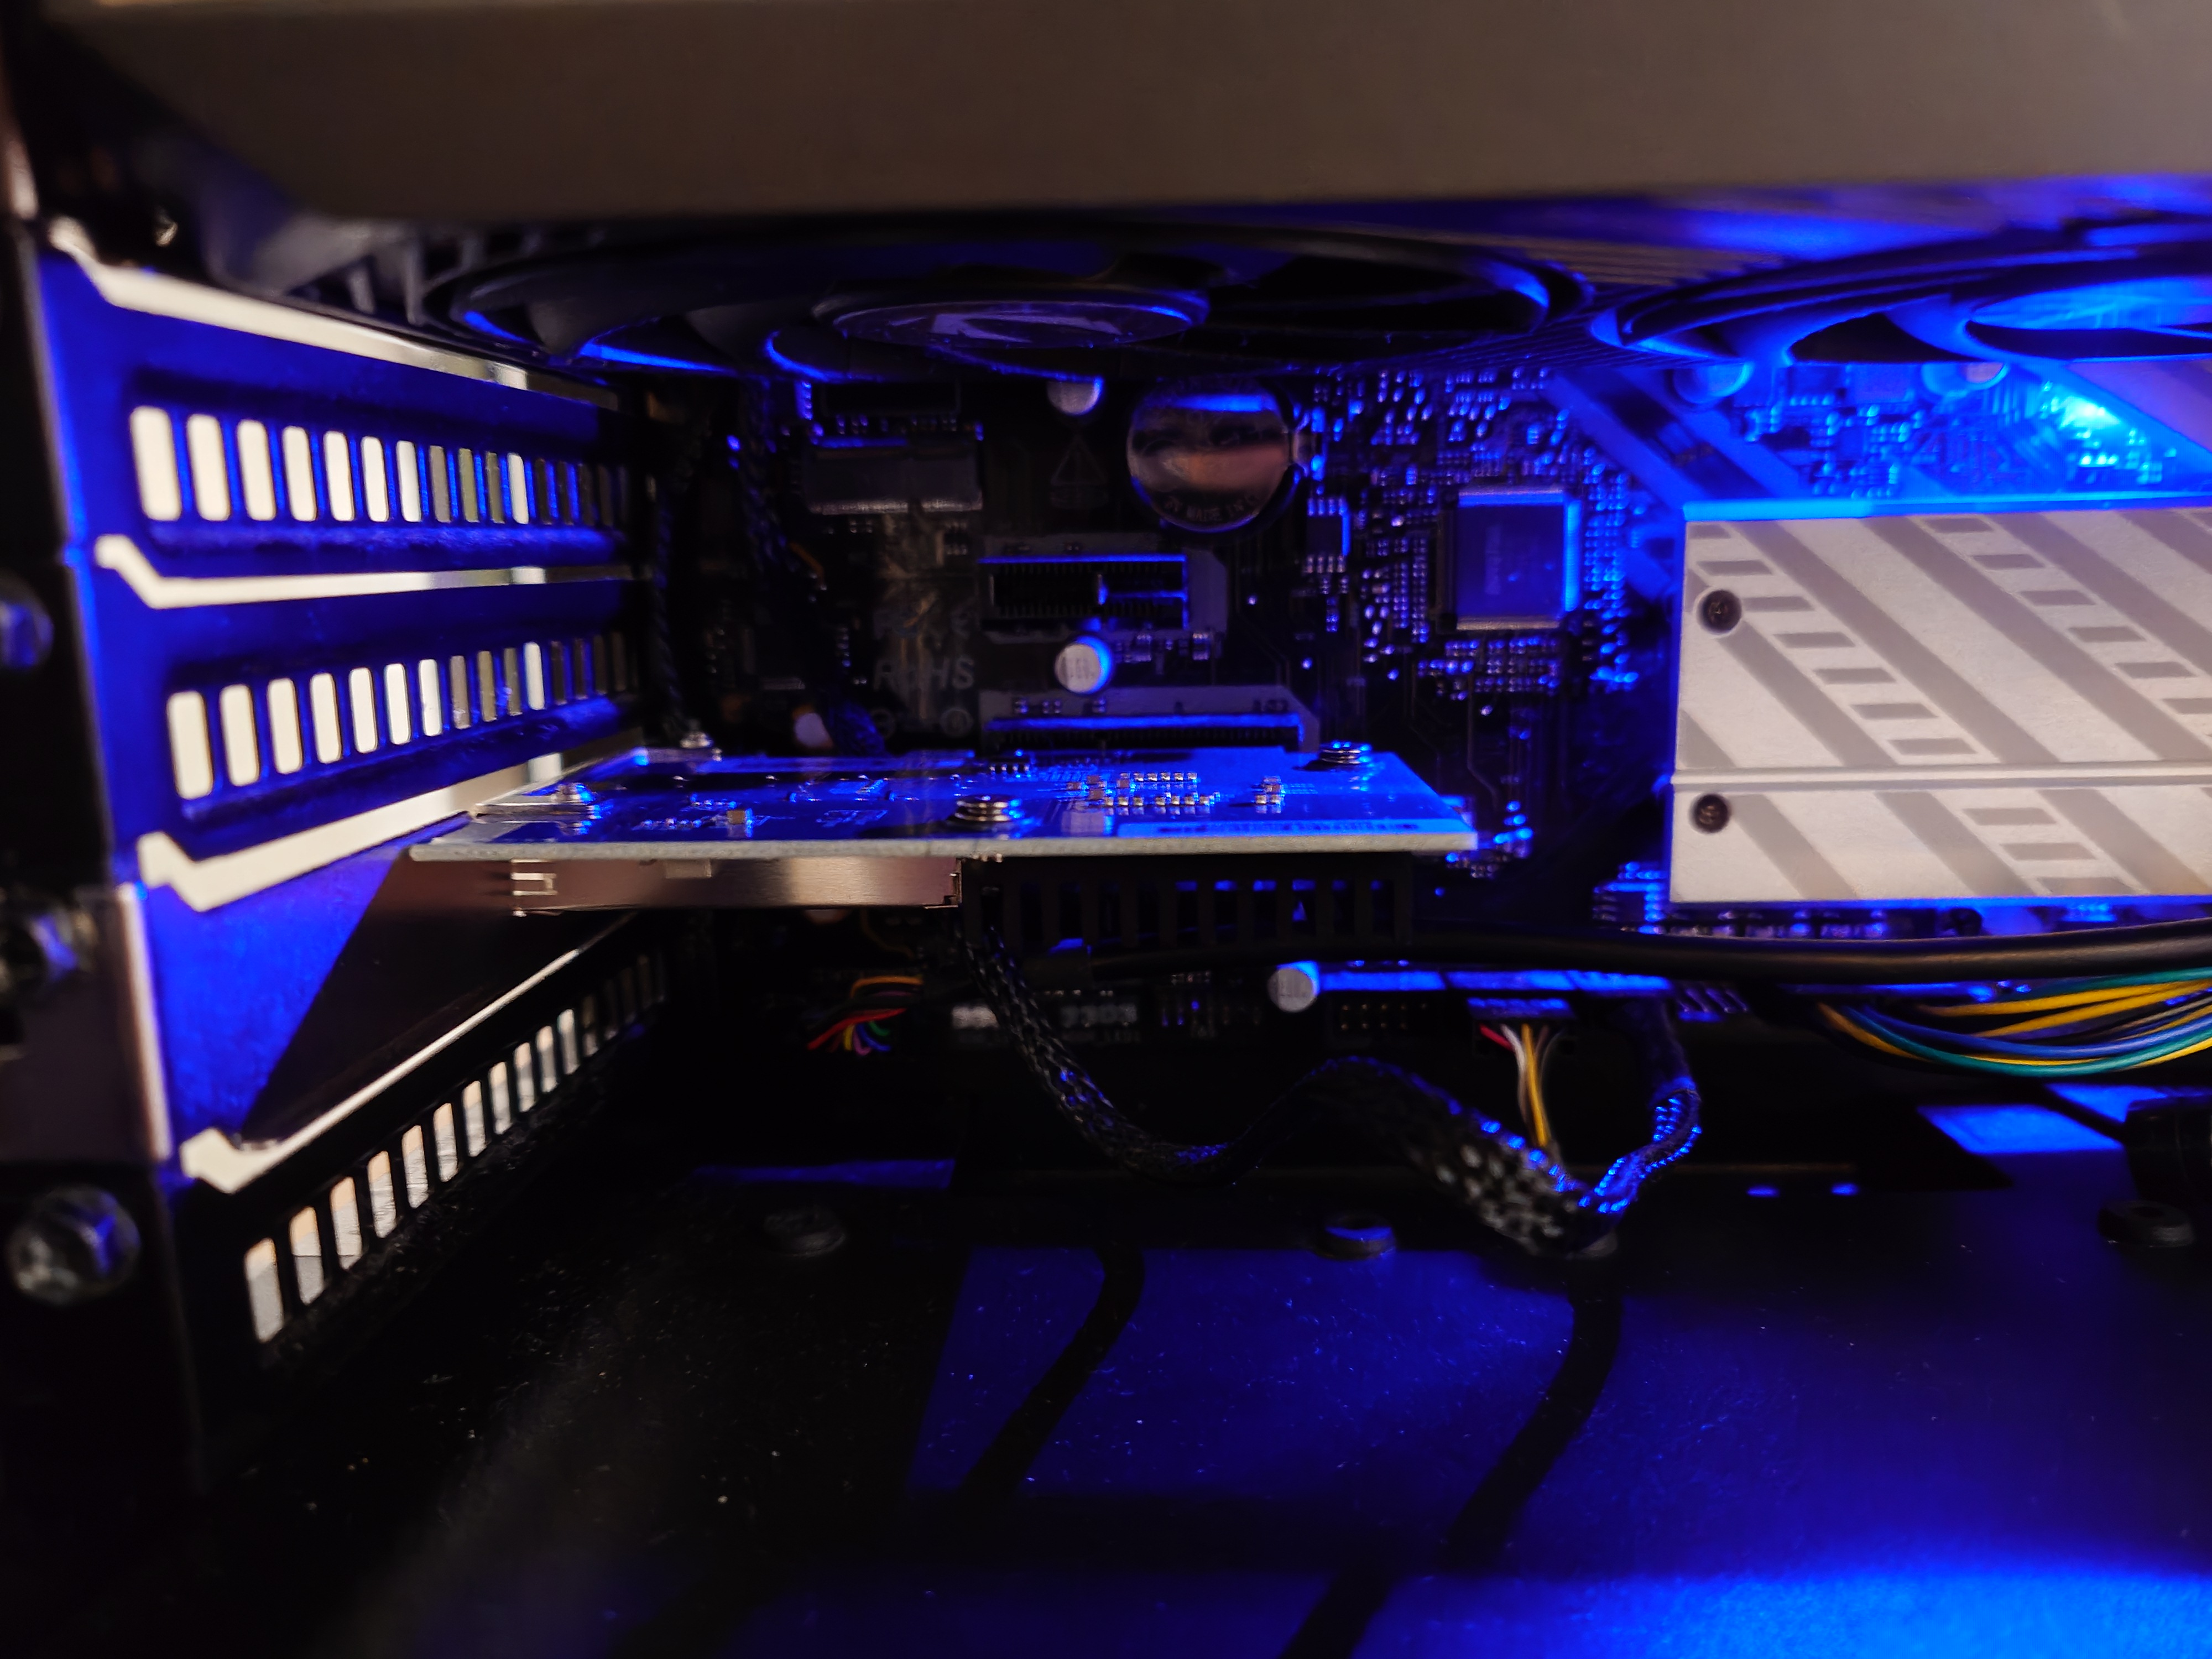
取付時に思ったこととして、ゲーミングPCはよく光るため、この程度のパーツの取り付けなら懐中電灯が要らなくて便利だなと思った。

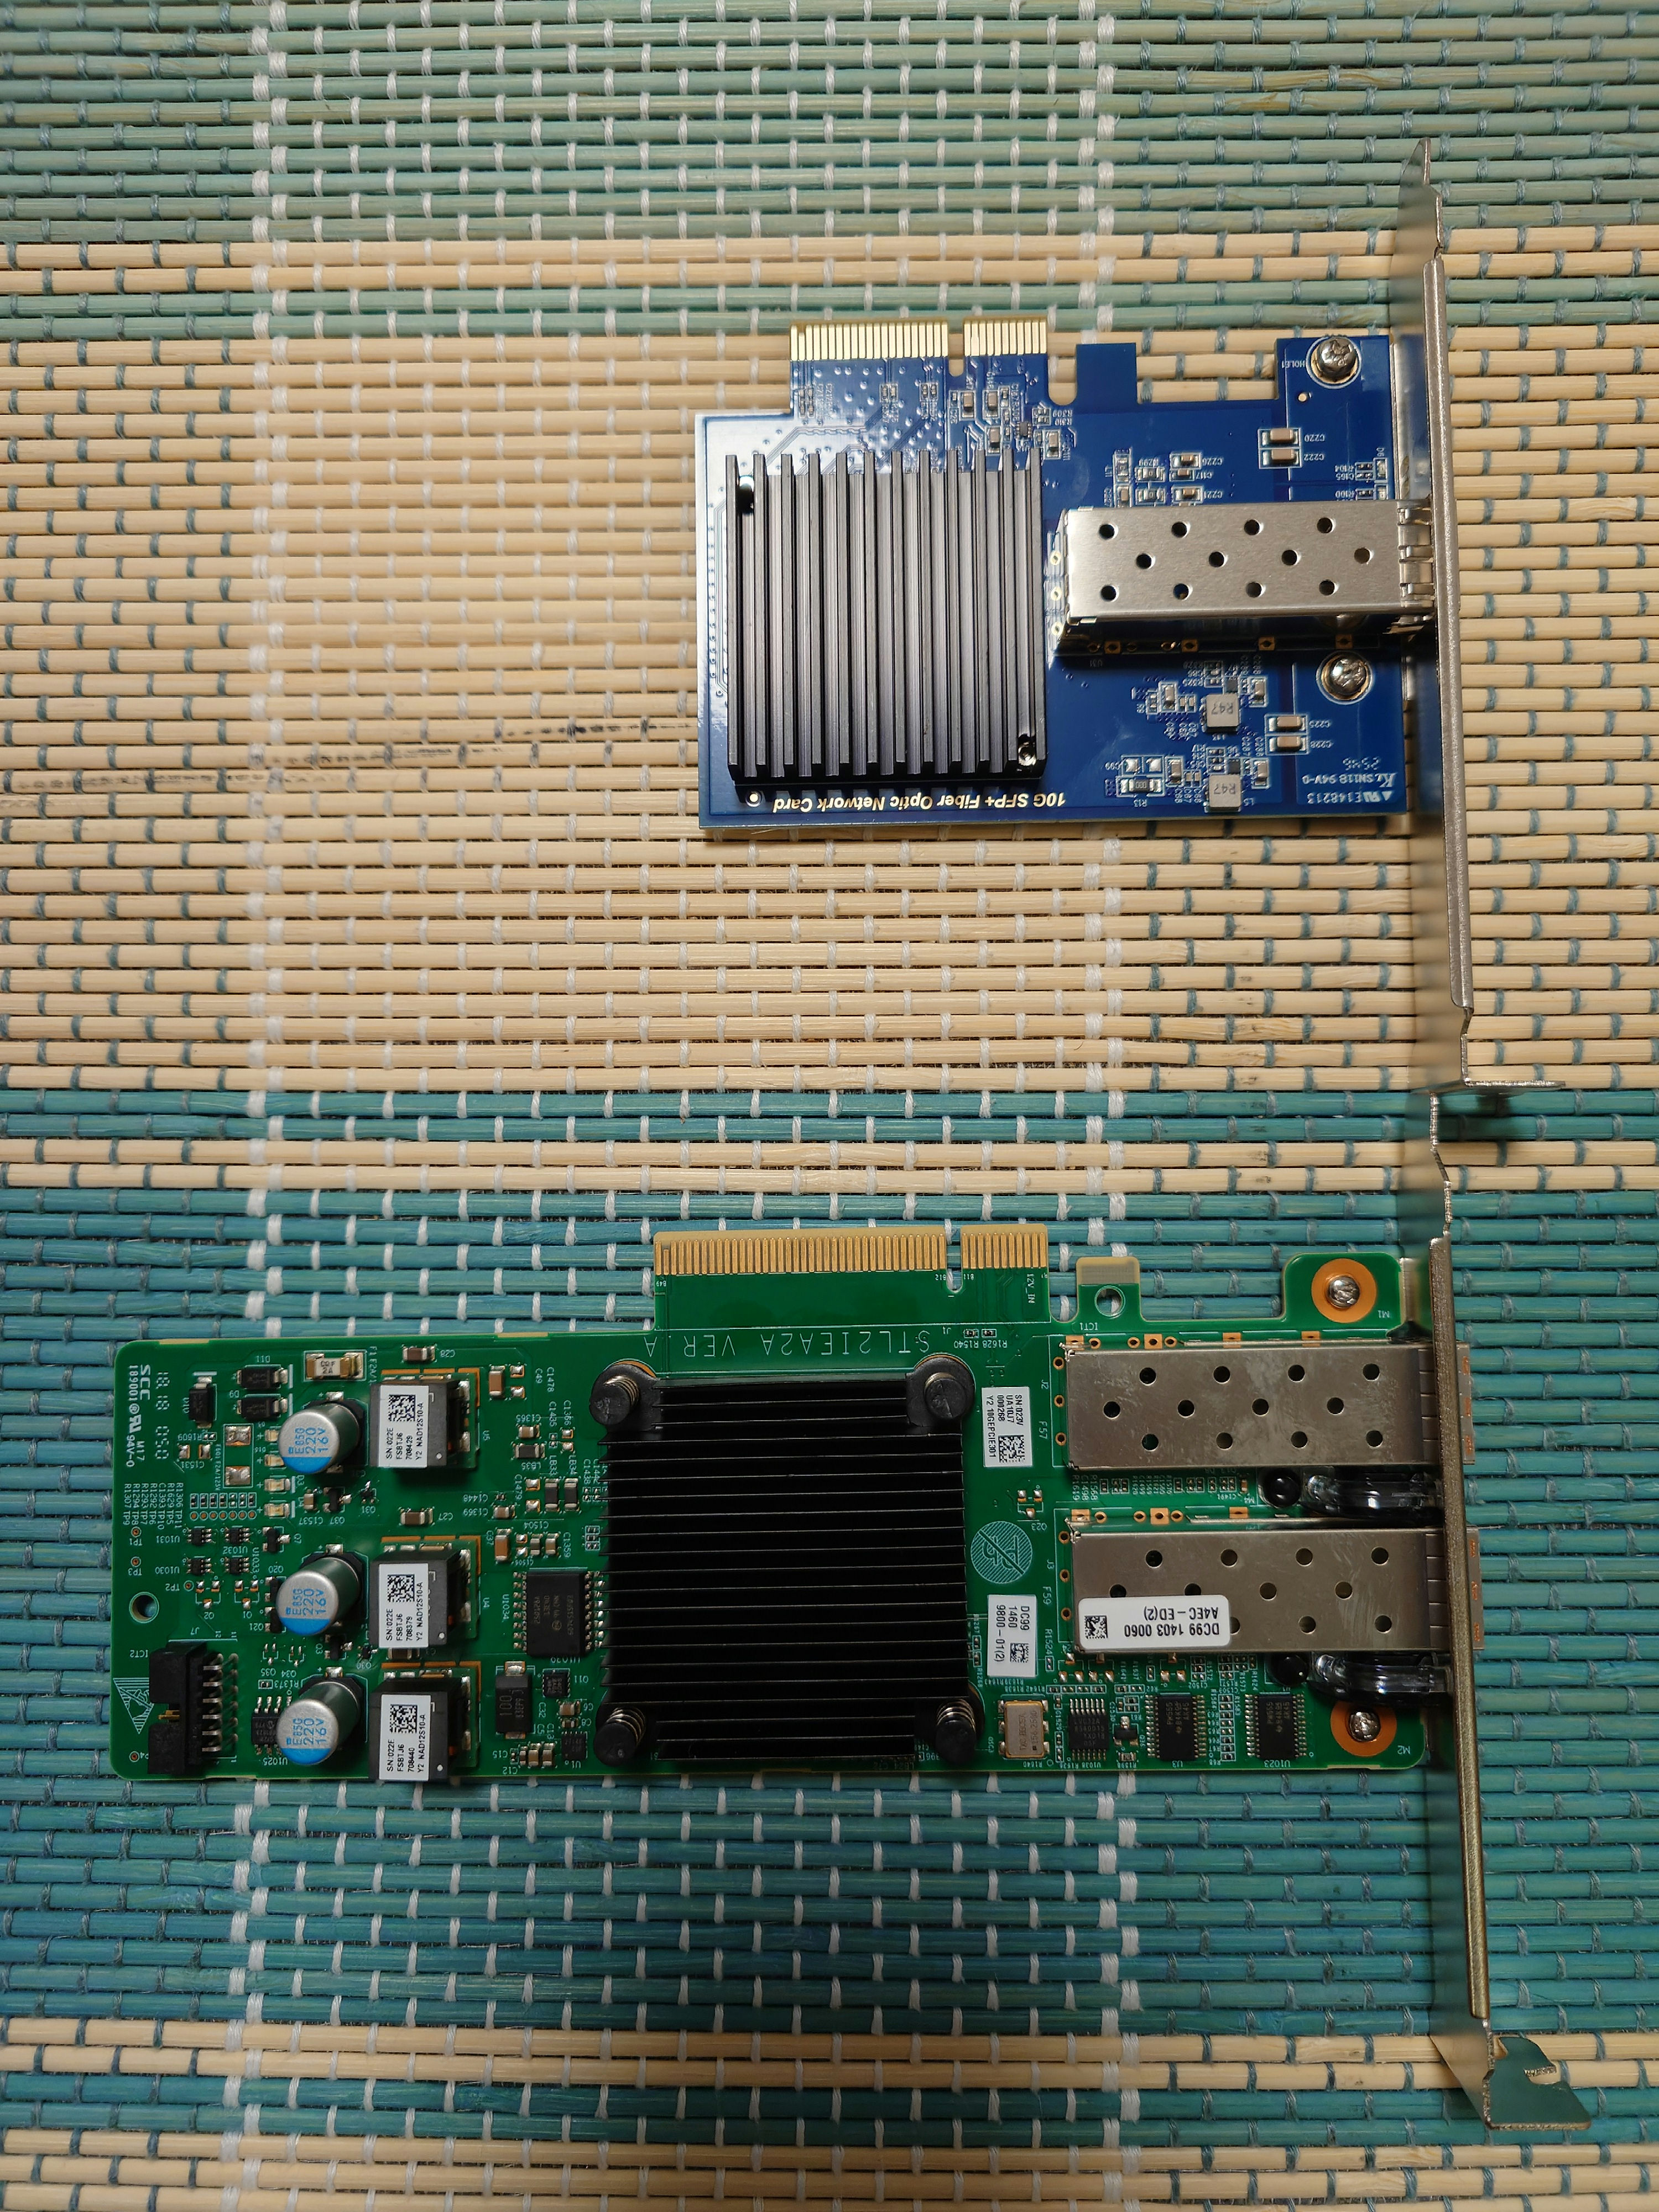
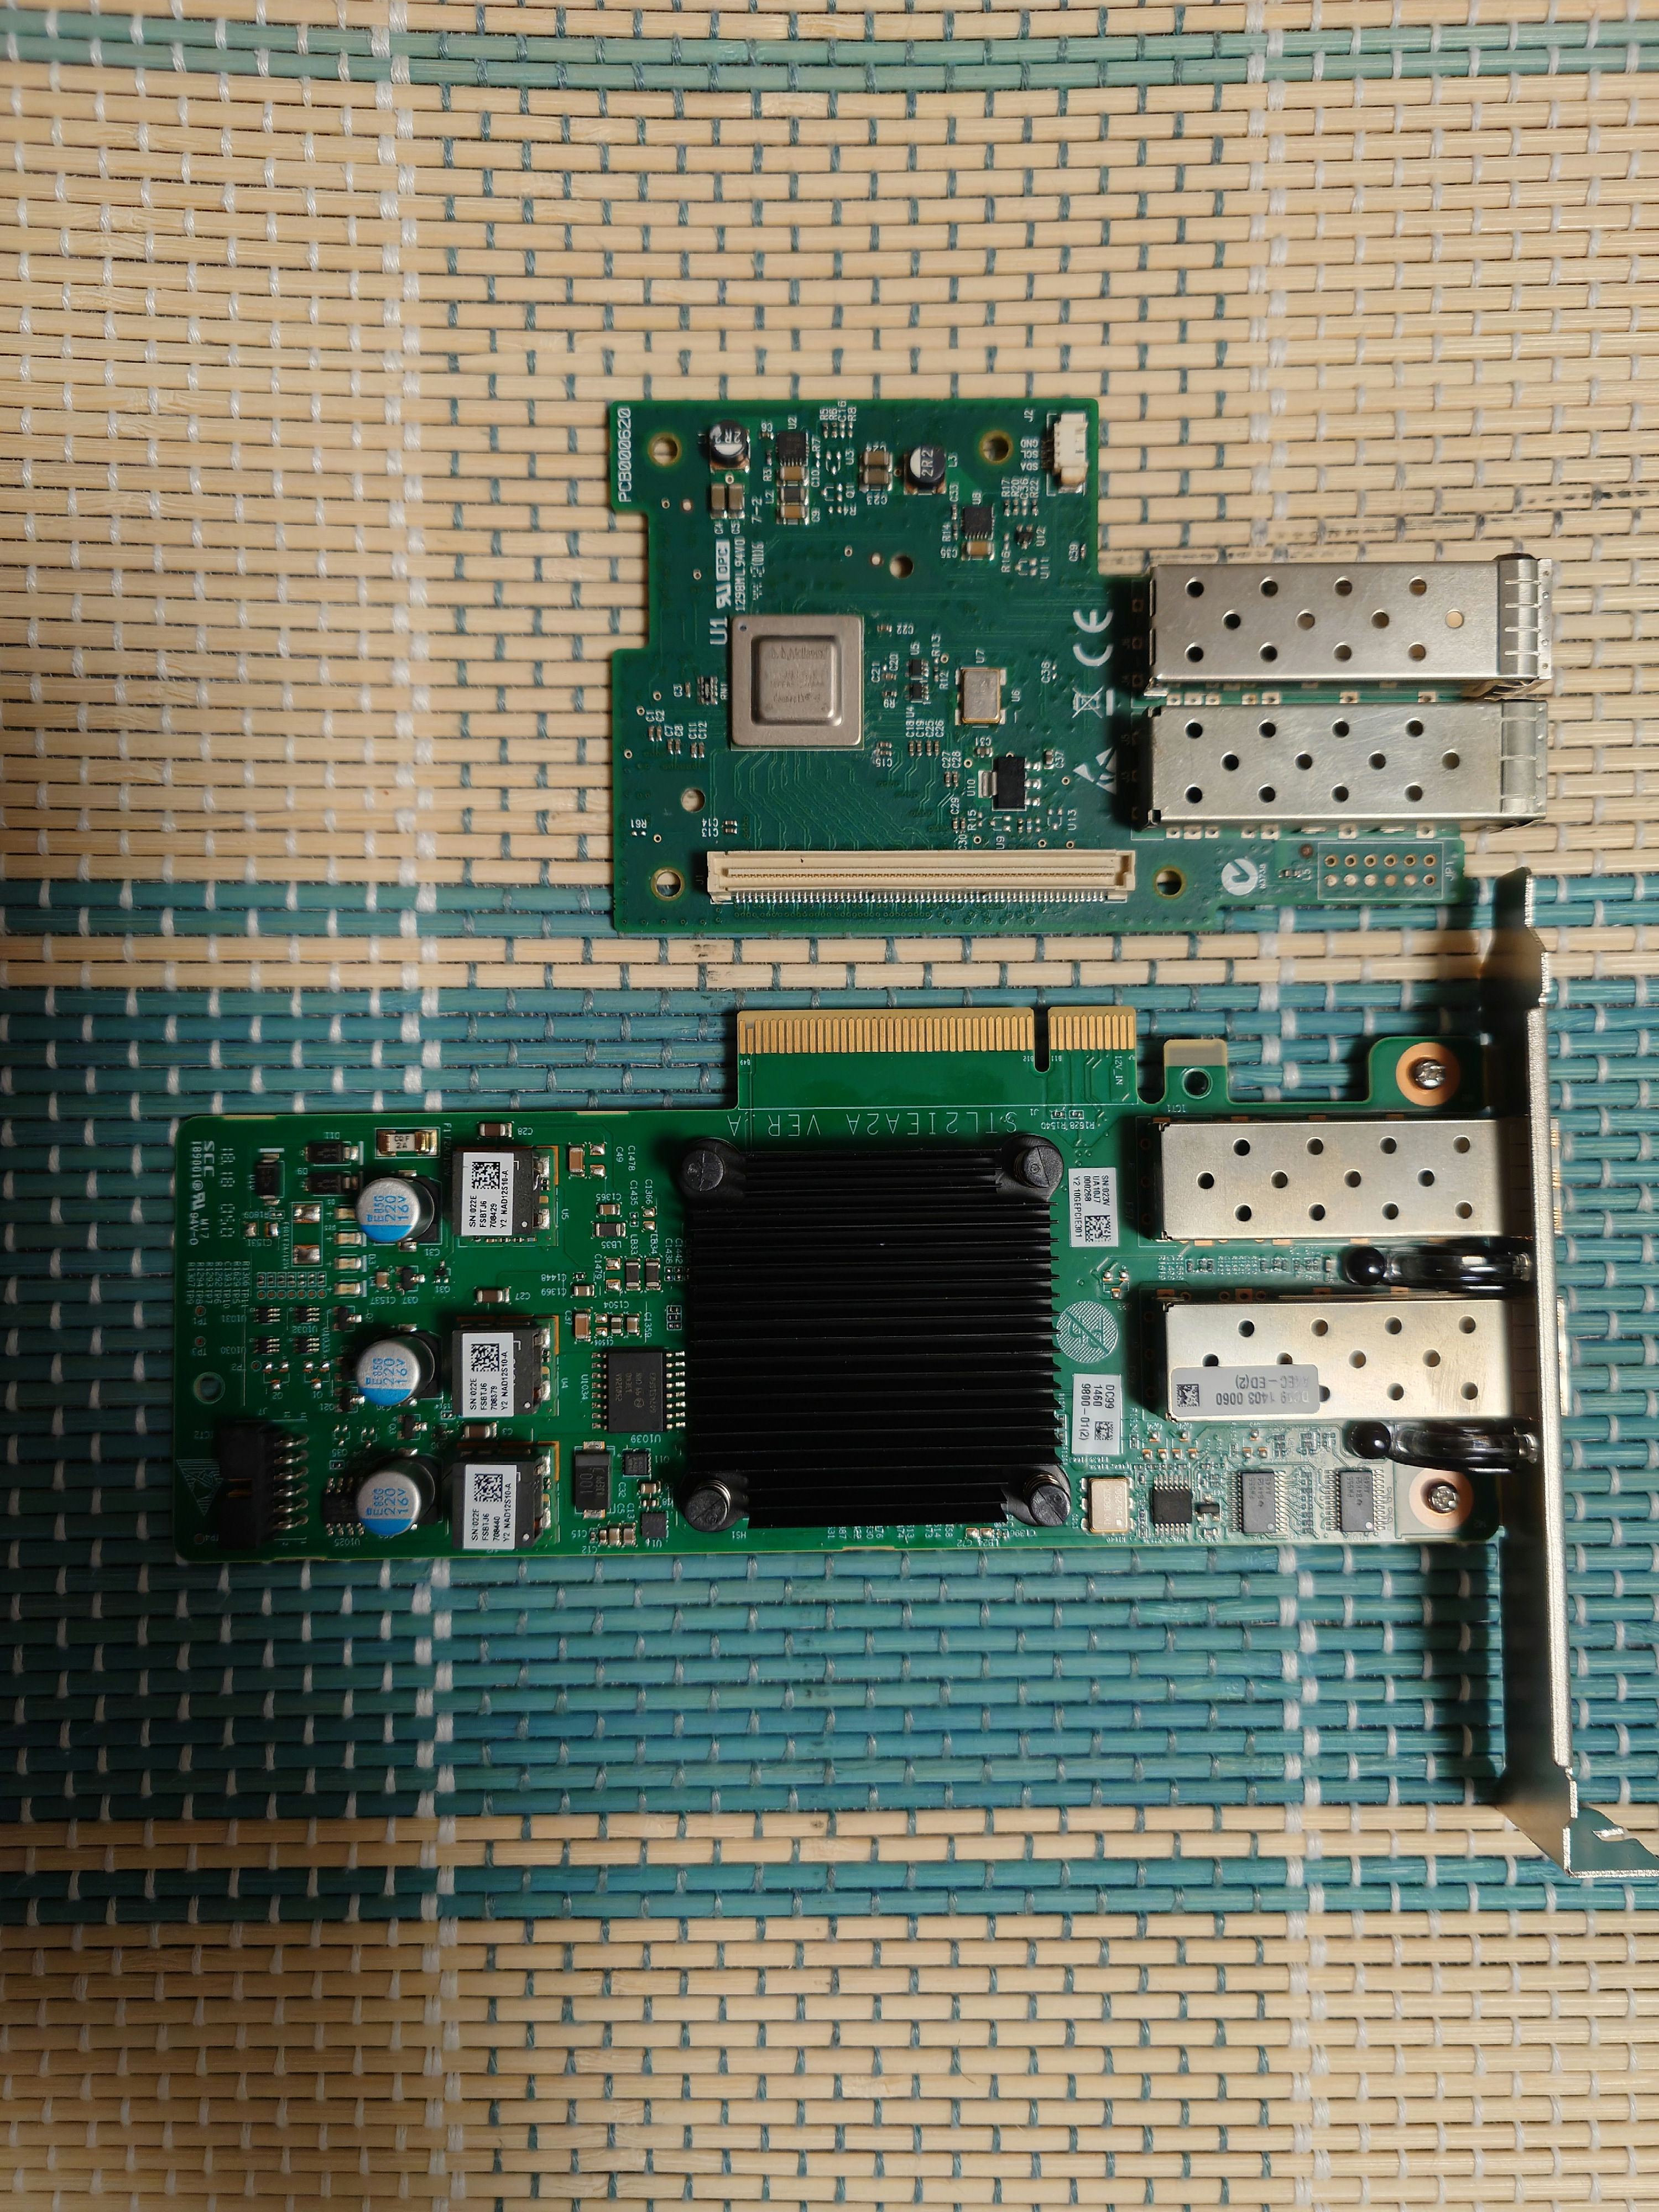
以前使っていたHuawei STL2IEA2Aと比べるとだいぶ小さい。基板が青色なのも少し珍しい気がした。

Huawei STL2IEA2Aとの比較

TXA403側は情報が少ないので一部の情報はググって出てきたのを適当につぎはぎしている。

機能 Huawei STL2IEA2A TXA403
チップセット Mellanox ConnectX-4 Lx Realtek RTL8127ATF
消費電力 12W 1W
コネクタ PCIe3.0x8 PCIe3.0x4
ポート数 2 1
WoL 非対応 対応
Linux対応 ◎ △
Windows対応 ◎ ◎

RTL8127ATFはLinux対応がイマイチらしく、UbuntuだとWoLを有効にすると問題が起きるっぽい?ので、Linuxでの使用は微妙かもしれない。

ベンチマーク

WindowsからUbuntuに飛ばす速度については、前回計測時より若干早くなっているように感じた。逆は特に変わらず。

Windows → Ubuntu

[ ID] Interval           Transfer     Bitrate
[  5]   0.00-1.00   sec  1.11 GBytes  9.52 Gbits/sec
[  5]   1.00-2.01   sec  1.11 GBytes  9.49 Gbits/sec
[  5]   2.01-3.00   sec  1.10 GBytes  9.49 Gbits/sec
[  5]   3.00-4.01   sec  1.12 GBytes  9.49 Gbits/sec
[  5]   4.01-5.00   sec  1.09 GBytes  9.49 Gbits/sec
[  5]   5.00-6.02   sec  1.12 GBytes  9.49 Gbits/sec
[  5]   6.02-7.00   sec  1.09 GBytes  9.49 Gbits/sec
[  5]   7.00-8.01   sec  1.11 GBytes  9.49 Gbits/sec
[  5]   8.01-9.02   sec  1.11 GBytes  9.49 Gbits/sec
[  5]   9.02-10.01  sec  1.10 GBytes  9.49 Gbits/sec
- - - - - - - - - - - - - - - - - - - - - - - - -
[ ID] Interval           Transfer     Bitrate
[  5]   0.00-10.01  sec  11.1 GBytes  9.49 Gbits/sec                  sender
[  5]   0.00-10.01  sec  11.1 GBytes  9.49 Gbits/sec                  receiver

Ubuntu → Windows

[ ID] Interval           Transfer     Bitrate
[  5]   0.00-1.01   sec  1.09 GBytes  9.26 Gbits/sec
[  5]   1.01-2.00   sec  1.07 GBytes  9.27 Gbits/sec
[  5]   2.00-3.01   sec  1.09 GBytes  9.27 Gbits/sec
[  5]   3.01-4.00   sec  1.07 GBytes  9.28 Gbits/sec
[  5]   4.00-5.01   sec  1.09 GBytes  9.28 Gbits/sec
[  5]   5.01-6.01   sec  1.07 GBytes  9.28 Gbits/sec
[  5]   6.01-7.01   sec  1.09 GBytes  9.29 Gbits/sec
[  5]   7.01-8.00   sec  1.07 GBytes  9.29 Gbits/sec
[  5]   8.00-9.01   sec  1.09 GBytes  9.28 Gbits/sec
[  5]   9.01-10.00  sec  1.07 GBytes  9.28 Gbits/sec
- - - - - - - - - - - - - - - - - - - - - - - - -
[ ID] Interval           Transfer     Bitrate
[  5]   0.00-10.00  sec  10.8 GBytes  9.28 Gbits/sec                  receiver

あとがき

R86S U1のNICを交換したのと今回の作業でSFP+対応のNICが2枚も余ってしまった。

まさかこんなニッチなNICを早くも二枚も余らせてしまうとは…。ひとまずは予備に持っているが、どうしたものか。

2026/09/24(木)以前買ったMellanox ConnectX-4でWoLができなかった話

メインのマシンを遠隔で上げたくなることがしばしばあるのでSFP+ NICでWoL出来ないか試してみたが、出来なかったログ。

宅内に10GbE環境を導入してみたで購入したNICで試した。

確認環境

Env Ver
WinMFT x64 4.37.0-154
Windows 11 Pro 25H2
NIC Huawei STL2IEA2A / Mellanox Connect-X4

手順

コマンドを叩くのにはMSYS2のzshを使用している。

  1. NVIDIA Firmware Tools (MFT)からWinMFTをダウンロードし、インストール
  2. 管理者権限でコマンドプロンプトを開く
  3. mst status -vを流し、デバイスの一覧を取得

    MST devices:
    ------------
    
    mt4117_pciconf0        seg:bus:dev.fn=0000:81:00.0
    
    mt4117_pciconf0.1      seg:bus:dev.fn=0000:81:00.1
    
  4. WoL設定名の確認
    mlxconfig -d mt4117_pciconf0 show_confs | grep WOL
                WOL CONF:
                    WOL_MAGIC_EN=<False|True>               Enables server Wake-on-LAN upon reception of WOL magic packet.
    
  5. WoL設定の確認。WoLがサポートされてない

    mlxconfig -d mt4117_pciconf0 query WOL_MAGIC_EN
    
    Device #1:
    ----------
    
    Device type:        ConnectX4LX
    Name:               N/A
    Description:        N/A
    Device:             mt4117_pciconf0
    
    Configurations:                                         Next Boot
    -E- The Device doesn't support WOL_MAGIC_EN parameter
    
  6. ごり押しで設定できないか試すが設定できなかった

    mlxconfig -d mt4117_pciconf0 set WOL_MAGIC_EN=true
    
    Device #1:
    ----------
    
    Device type:        ConnectX4LX
    Name:               N/A
    Description:        N/A
    Device:             mt4117_pciconf0
    
    Configurations:                                         Next Boot                         New
    -E- Operation is not supported (Read only TLV: nv_wol_conf)
    

おまけ:このNICが何者か調べてみたらHuawei製だった

HuaweiのSTL2IEA2Aとかいうやつらしい。

mlxfwmanager --query
Querying Mellanox devices firmware ...

Device #1:
----------

  Device Type:      ConnectX4LX
  Part Number:      Huawei_STL2IEA2A_CX4LX_2P_25G_Ax
  Description:      Huawei STL2IEA2A - ConnectX-4 Lx dual-port 25GbE SFP28
  PSID:             HUA0010110034
  PCI Device Name:  mt4117_pciconf0
  Base MAC:         dc9914609800
  Versions:         Current        Available
     FW             14.17.1010     N/A
     PXE            3.4.0903       N/A

  Status:           No matching image found

SFP+でWoLをする方法、Realtekならいけそう

ChatGPTに聞いてみた感じ、Mellanoxのチップセットは基本的にWoL対応しておらず、対応品は6~8万と高額との話だった。

そういえば前にRealtekから安いSFP+対応NICが出ていたがあれはどうだろう?と調べてみたら、Realtek RTL8127ATFのWoL対応品を見つけ、レビューでも行けてそうだったので、次はこれを買って試してみようと思った。新品なのに比較的安価なのも嬉しい。

因みにChatGPTはこのNICを見つけることができなかった。やはり人間がリアルタイムで見聞きした記憶はLLMより優れてるなと思った。

あとがき

マザボのNIC経由ならWoL出来るのは解っているがケーブルを増やしたくないのでSFP+でやりたいのである。

2026/07/16(木)R86S U1のNICを交換した

R86S U1のNICについているSFP+ポートの片方が不安定という問題があり、これがずっと悩みの種だった。

しかしR86S U1のNICはOCP2.0のメザニンカードという特殊な規格であり、入手が難しかった。あと最近なんでも高いことや、ここ一年近く財政が悪く資金がショートしていたこともあり、中々購入のタイミングがなかったが、偶然安いのを見つけたので交換を決意した。

購入したもの

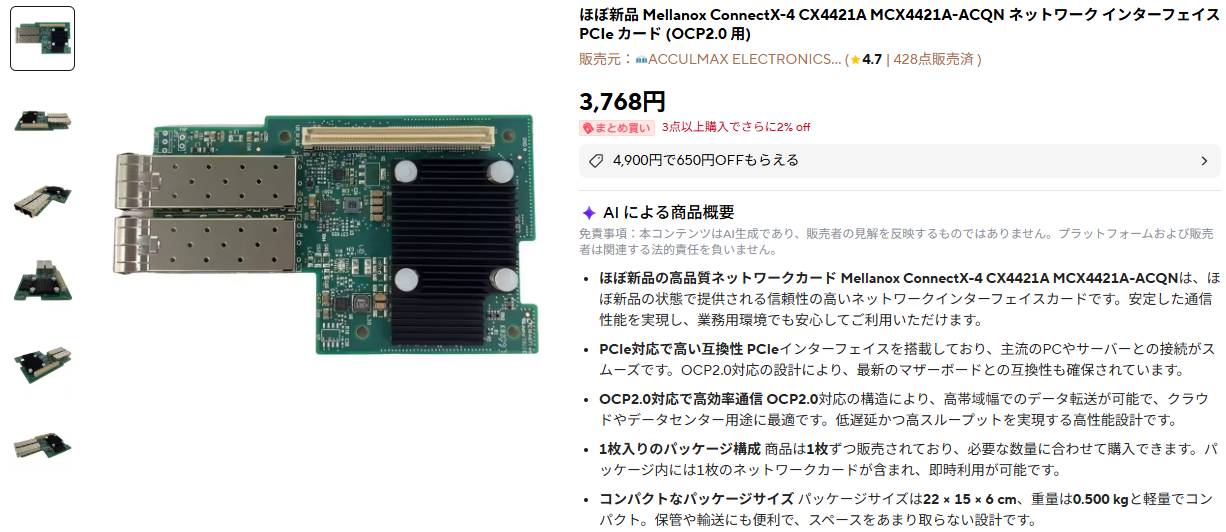
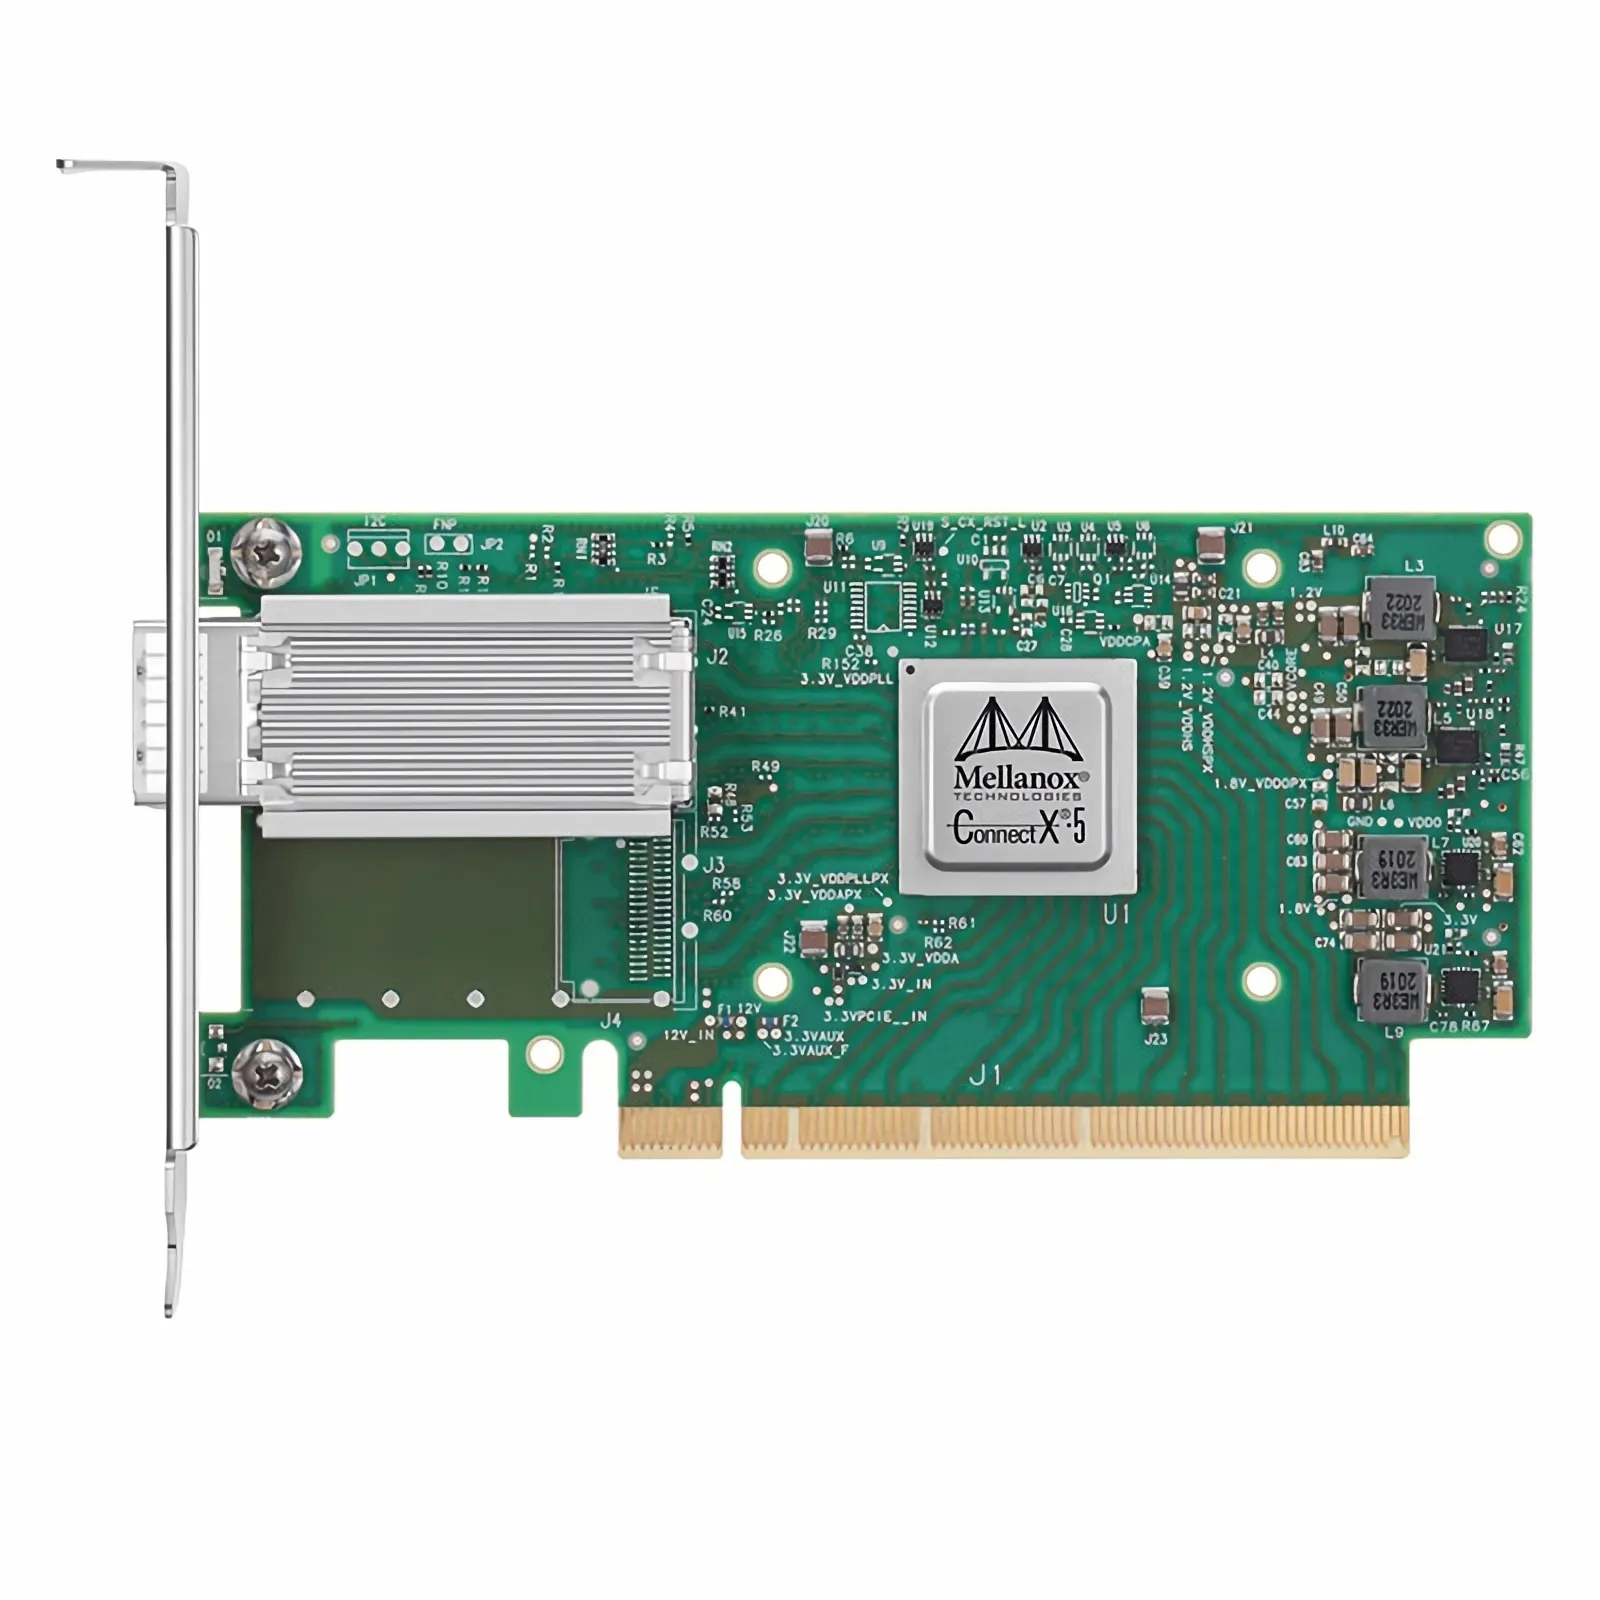
ほぼ新品 Mellanox ConnectX-4 CX4421A MCX4421A-ACQN ネットワーク インターフェイス PCIe カード (OCP2.0 用)

ほぼ新品とあるが中古なのは間違いない。

写真を見る限り左右でコネクタが異なるといったこともなく、3,745円でConnectX-3からConnectX-4に上げられて不調もなくなるならアリではないか?と思い、購入することにした。

配送

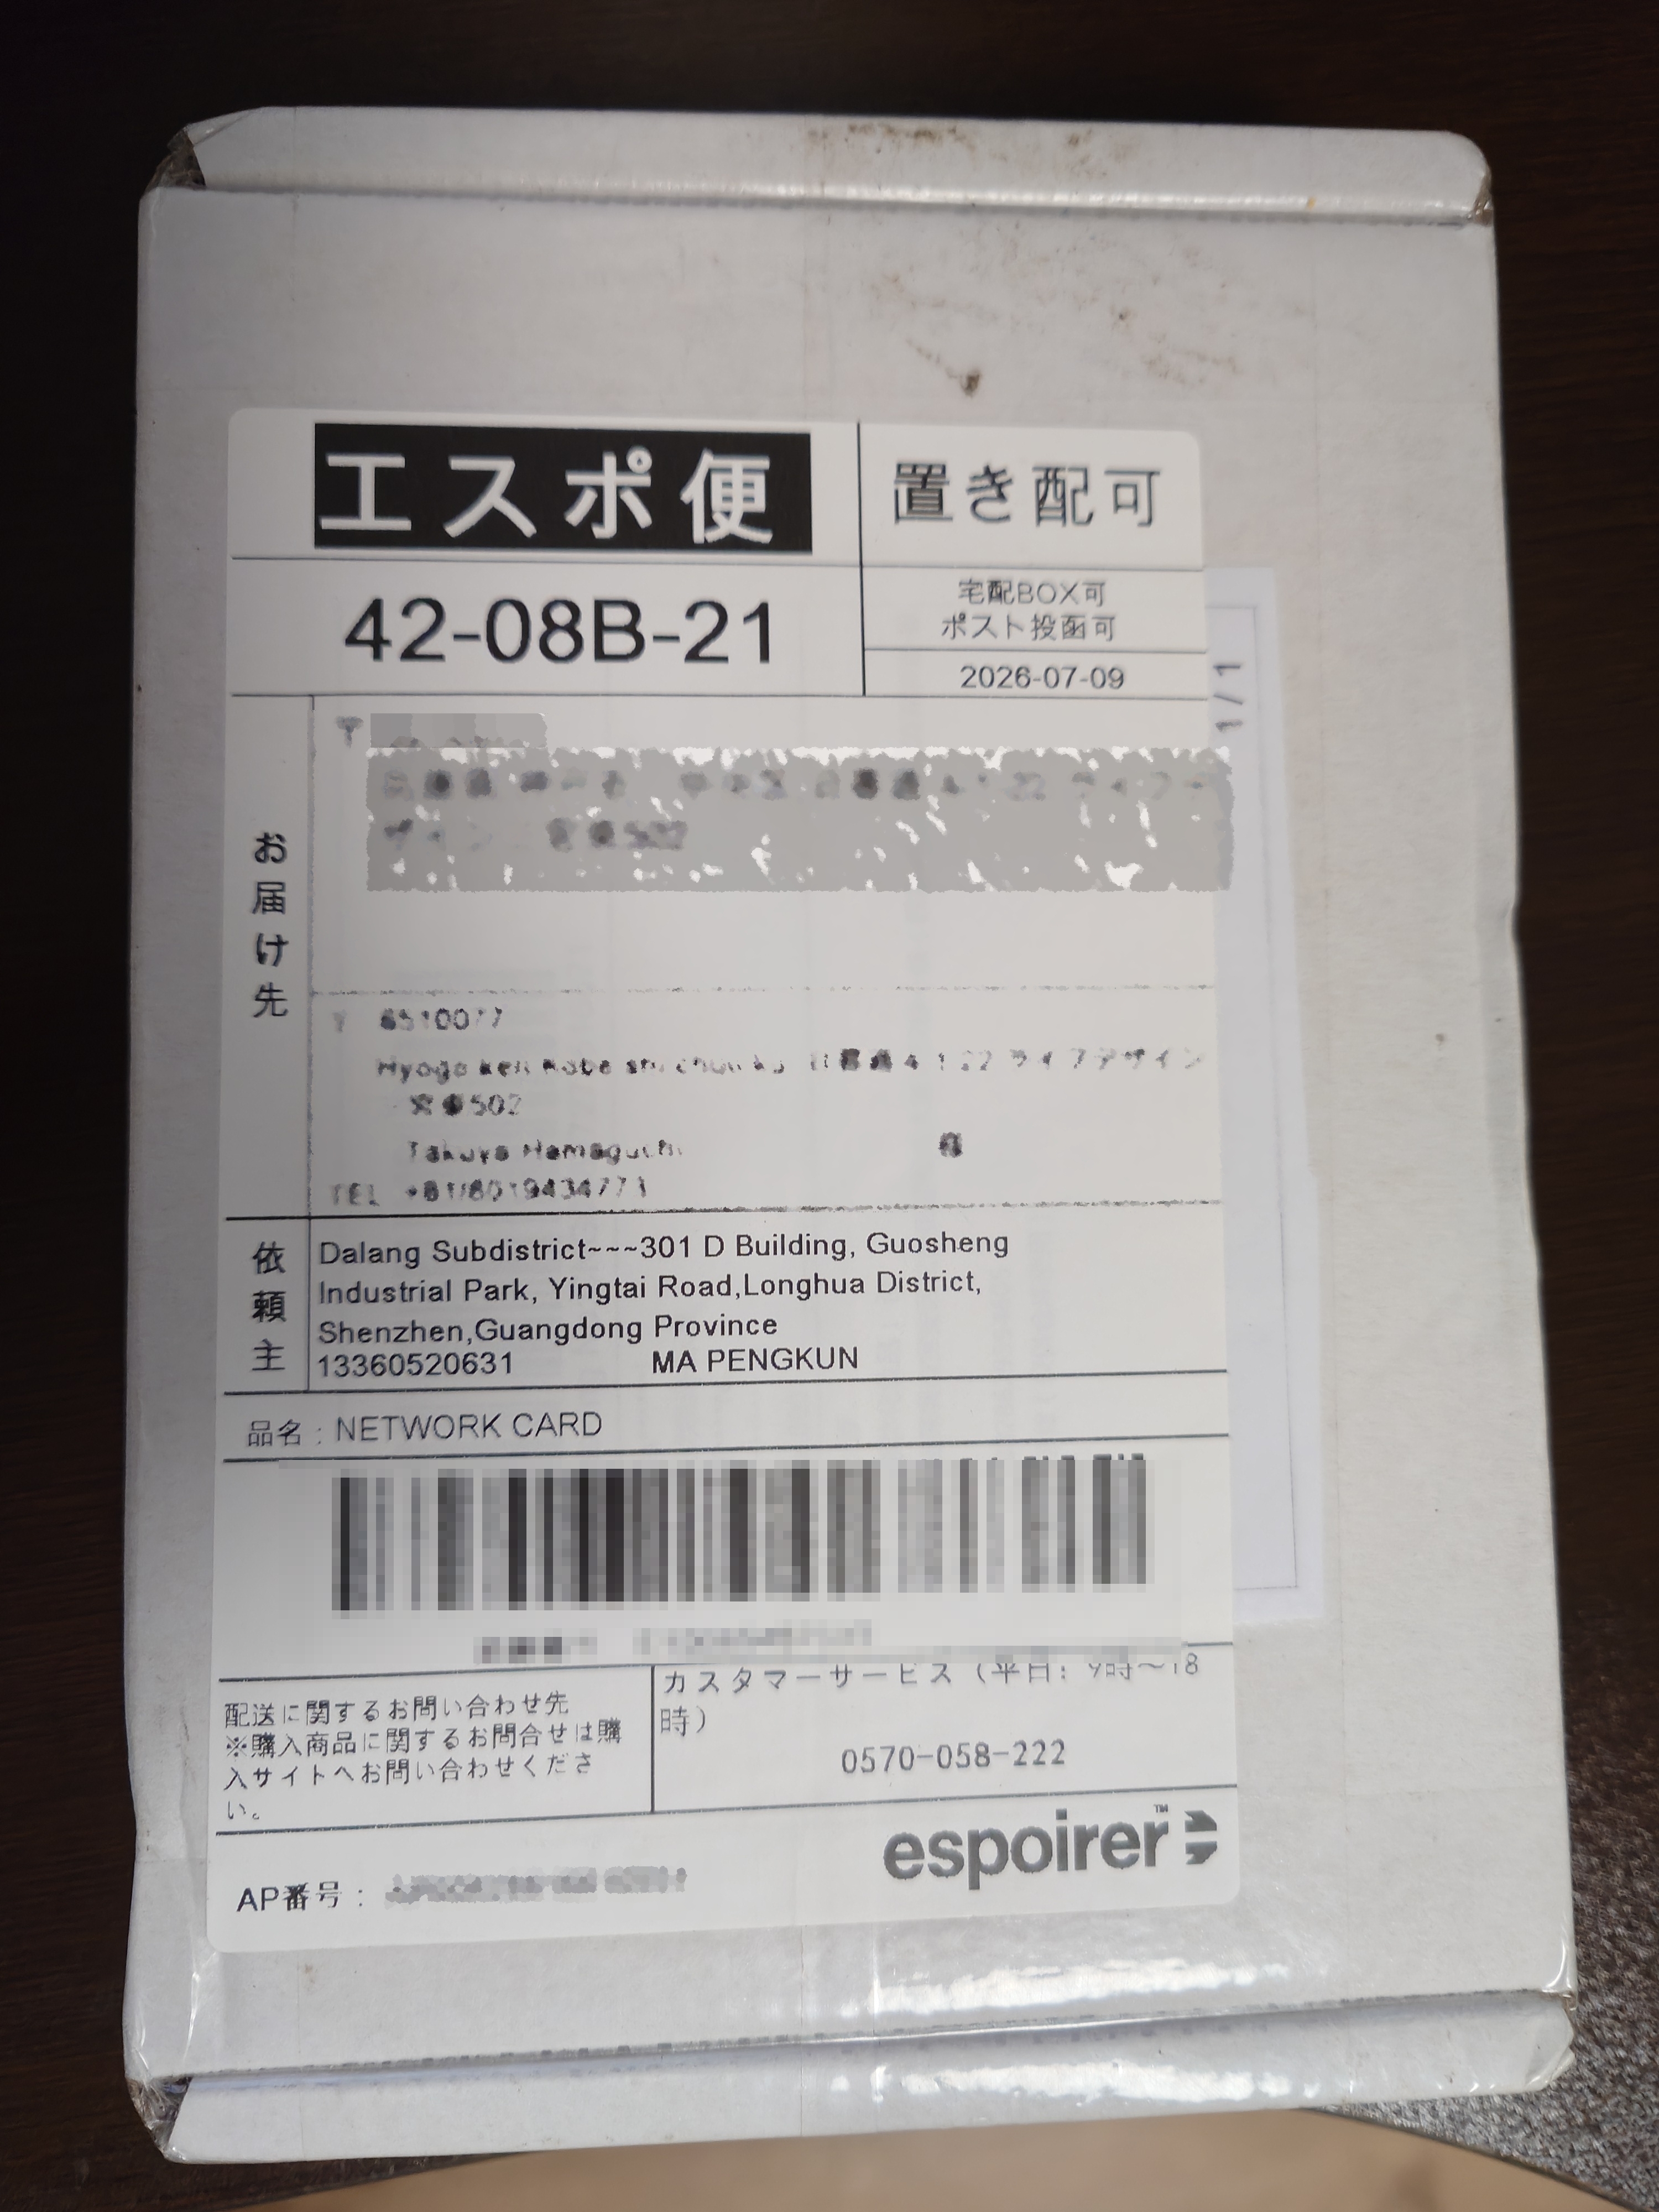
荷物はいつも通りCainiaoから発送され、国内ではエスポ便という聞いたこともない業者に引き渡された。軽く調べたところ株式会社エスポリアという越境ECのサービス会社がやっているようで、ここ最近のアリエクに増えているらしい。ここ自体は仲介業者で配送はしてないらしい。

そういえば最近中華特有のテカテカしたプチプチ袋減った気がする。
実際の配送はかつてAmazon便で悪名を馳せたTMG、椿本グループだった。久々に見たので、一般消費者向け宅配便事業で生きてたのかお前…となった。
開封の儀

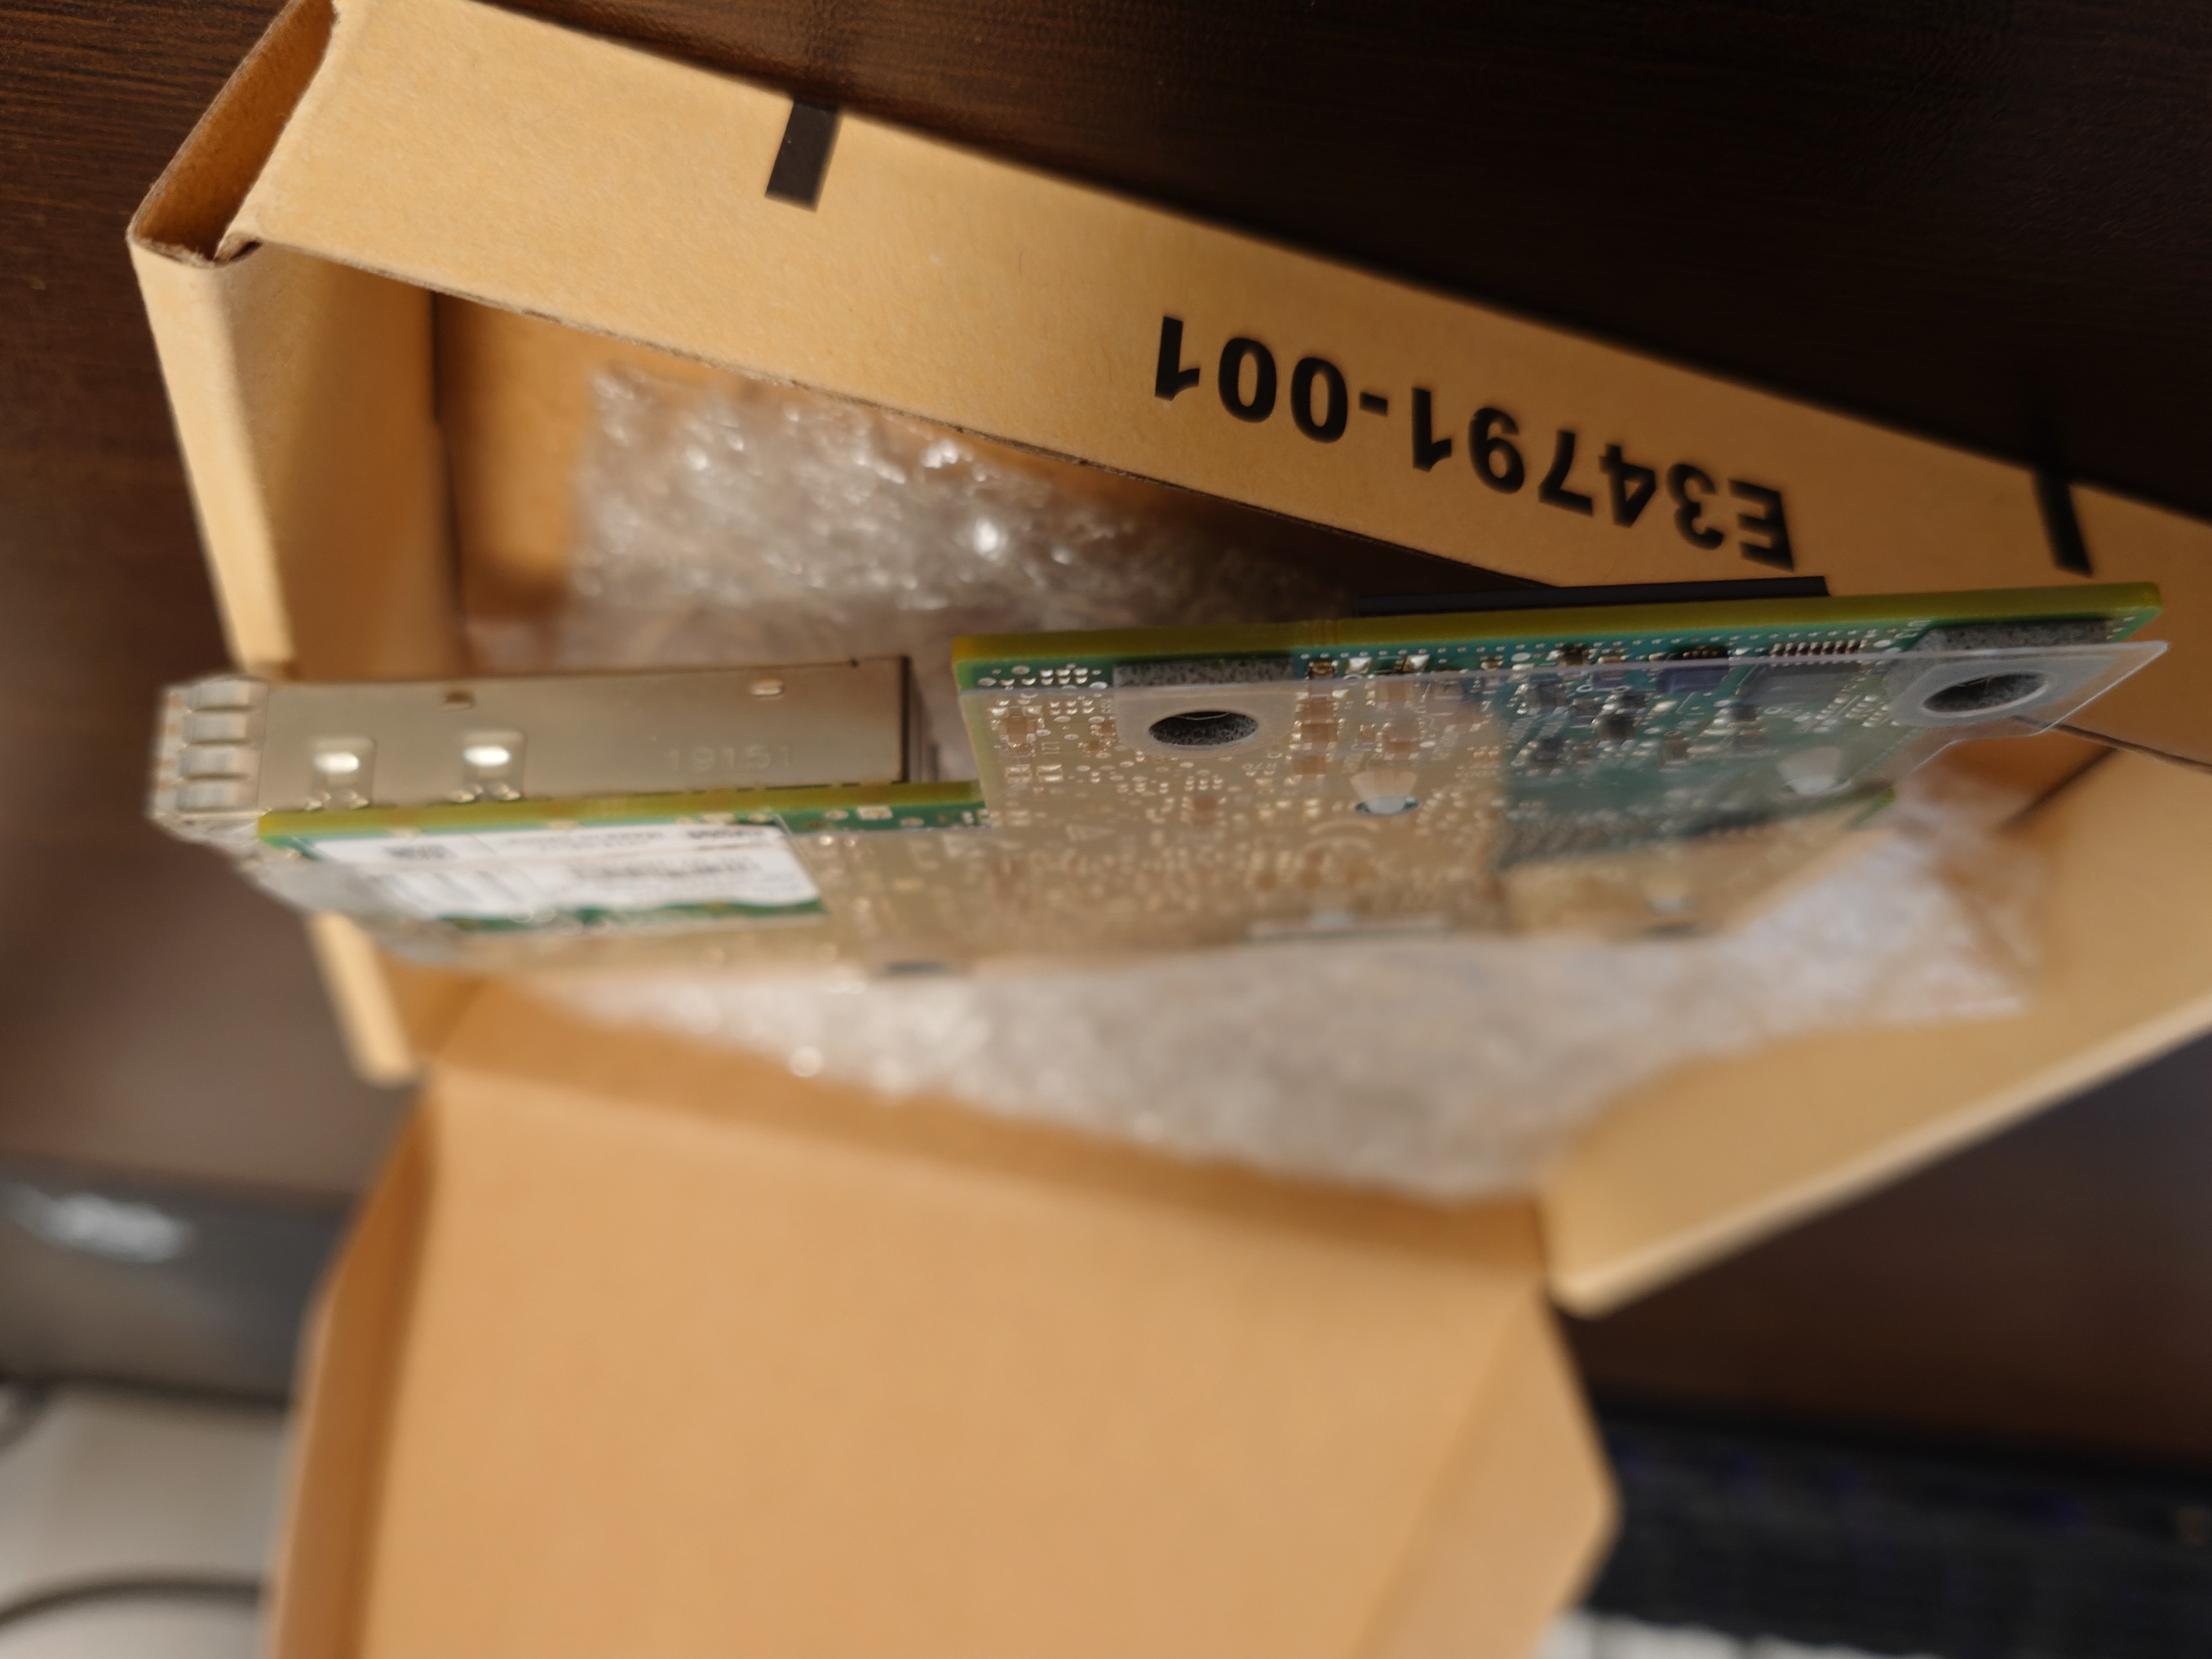
結構ちゃんとした箱に入っていた。

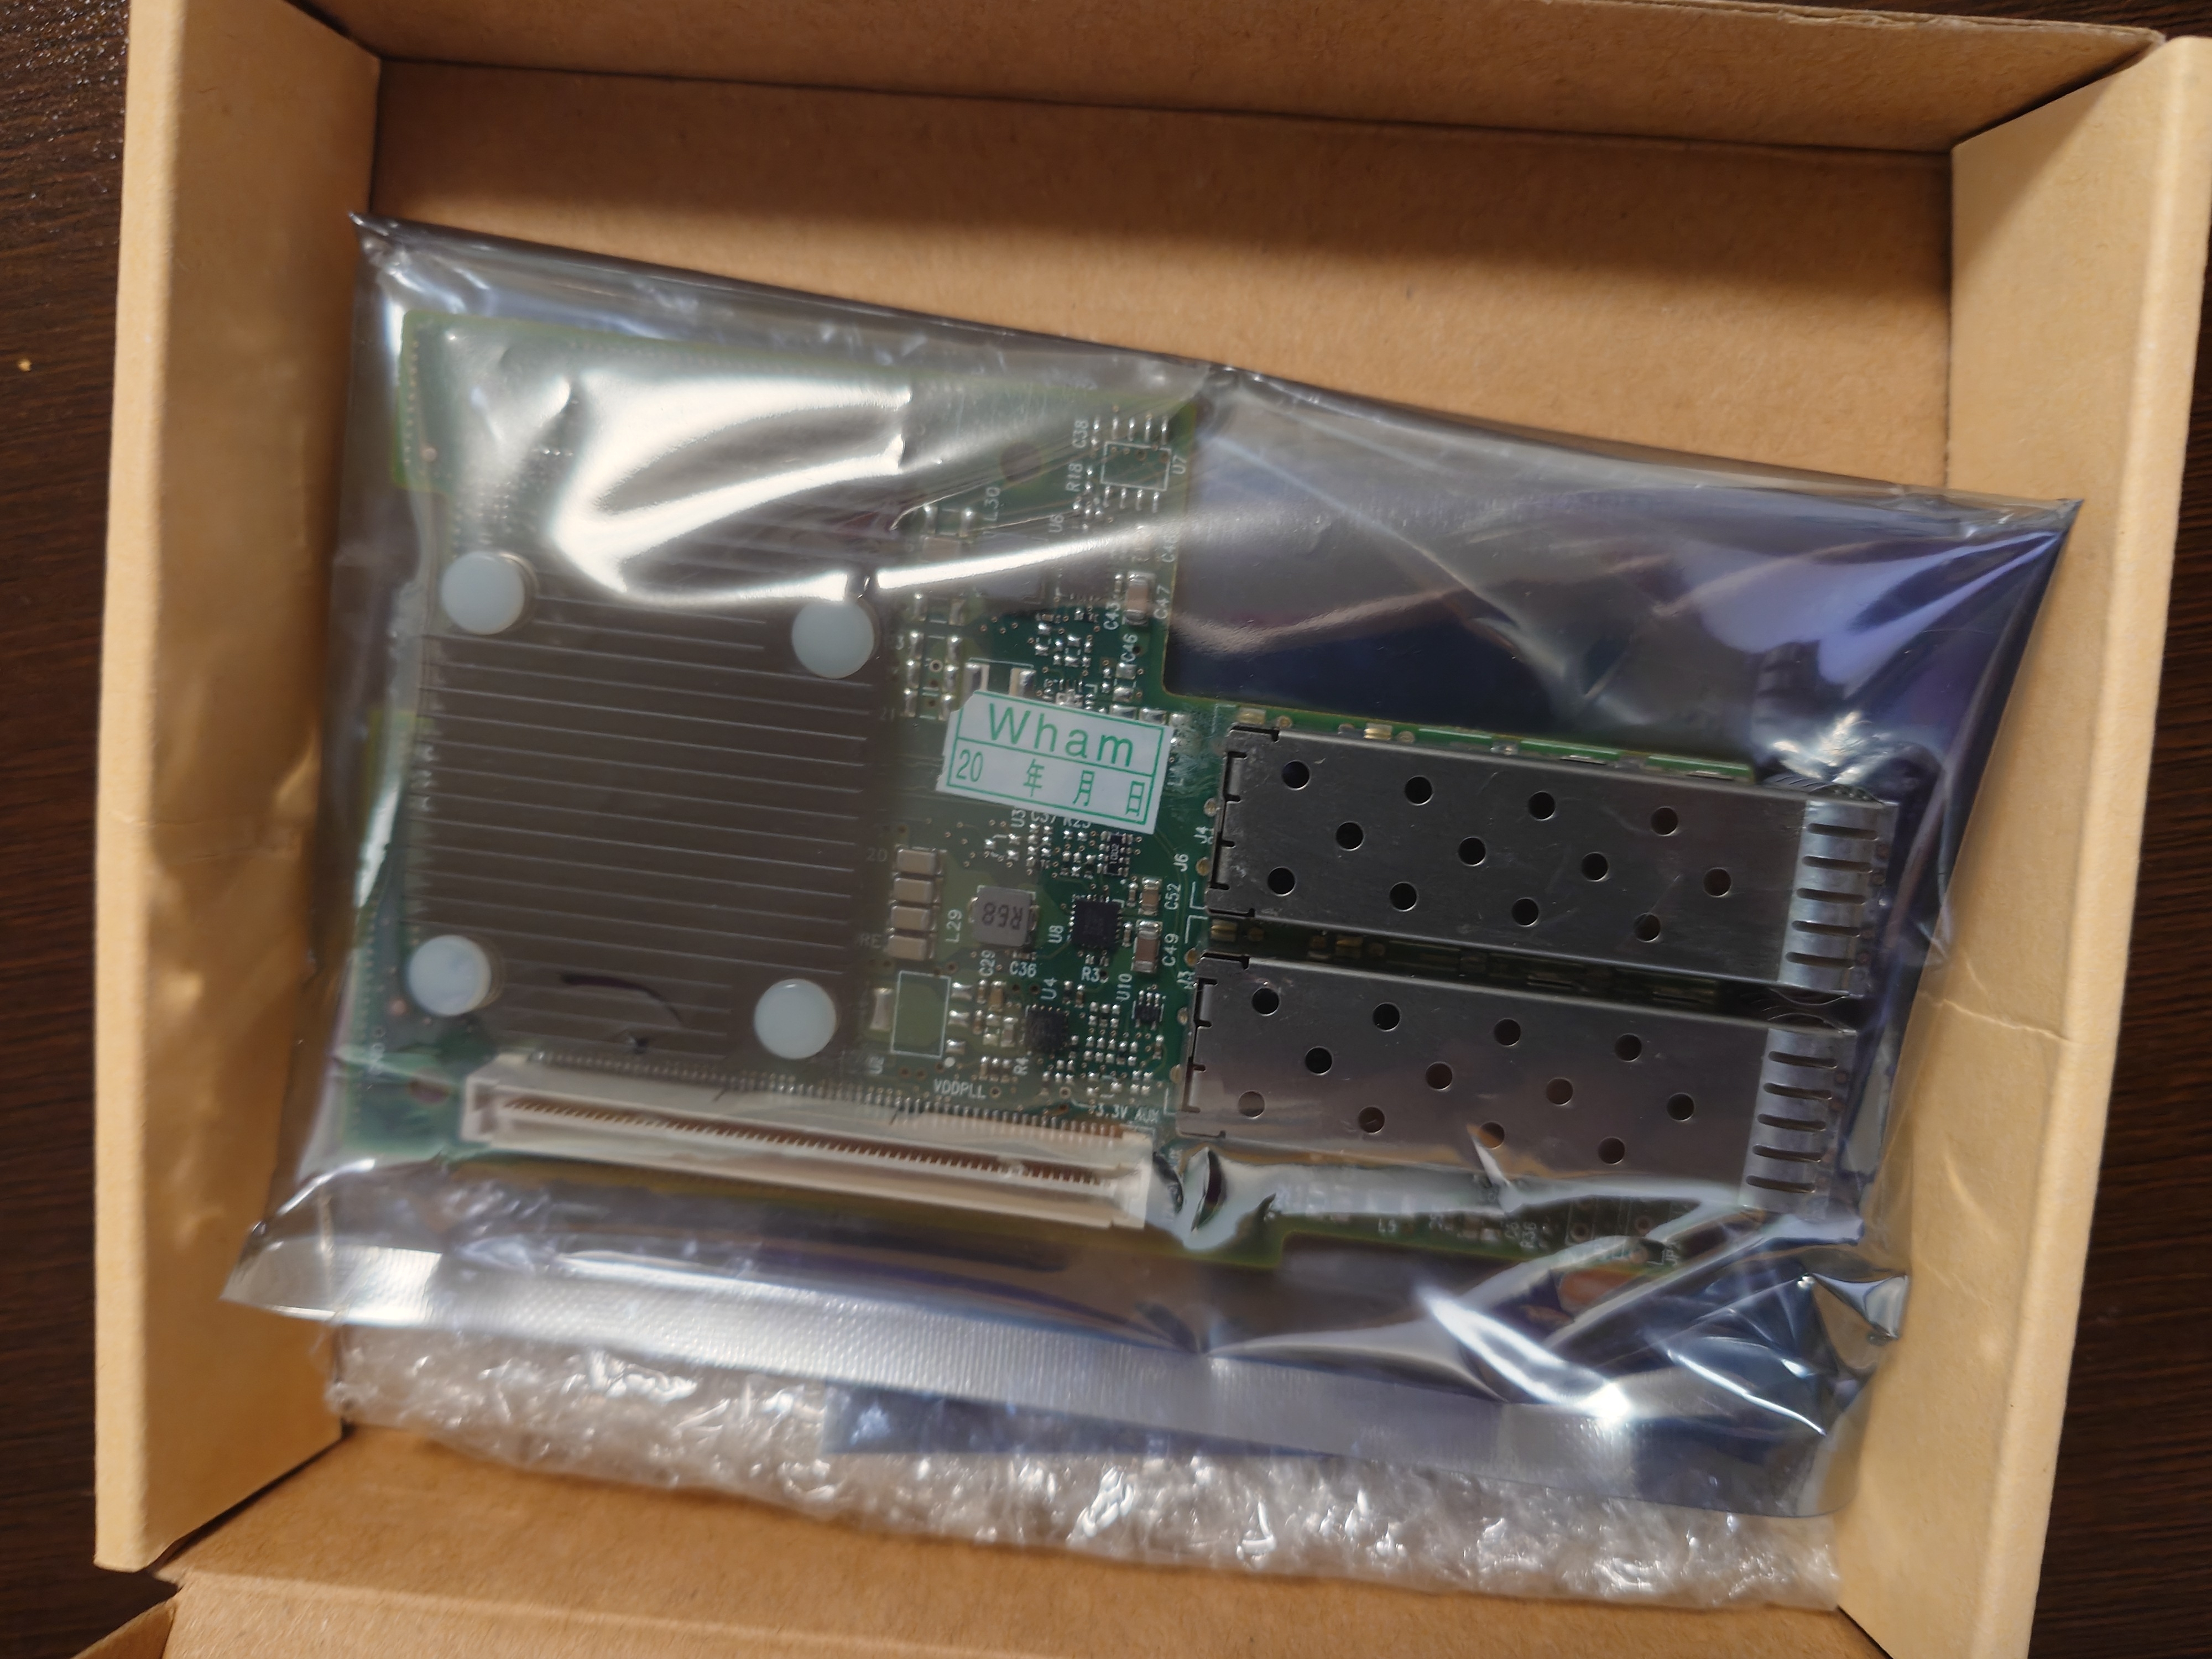
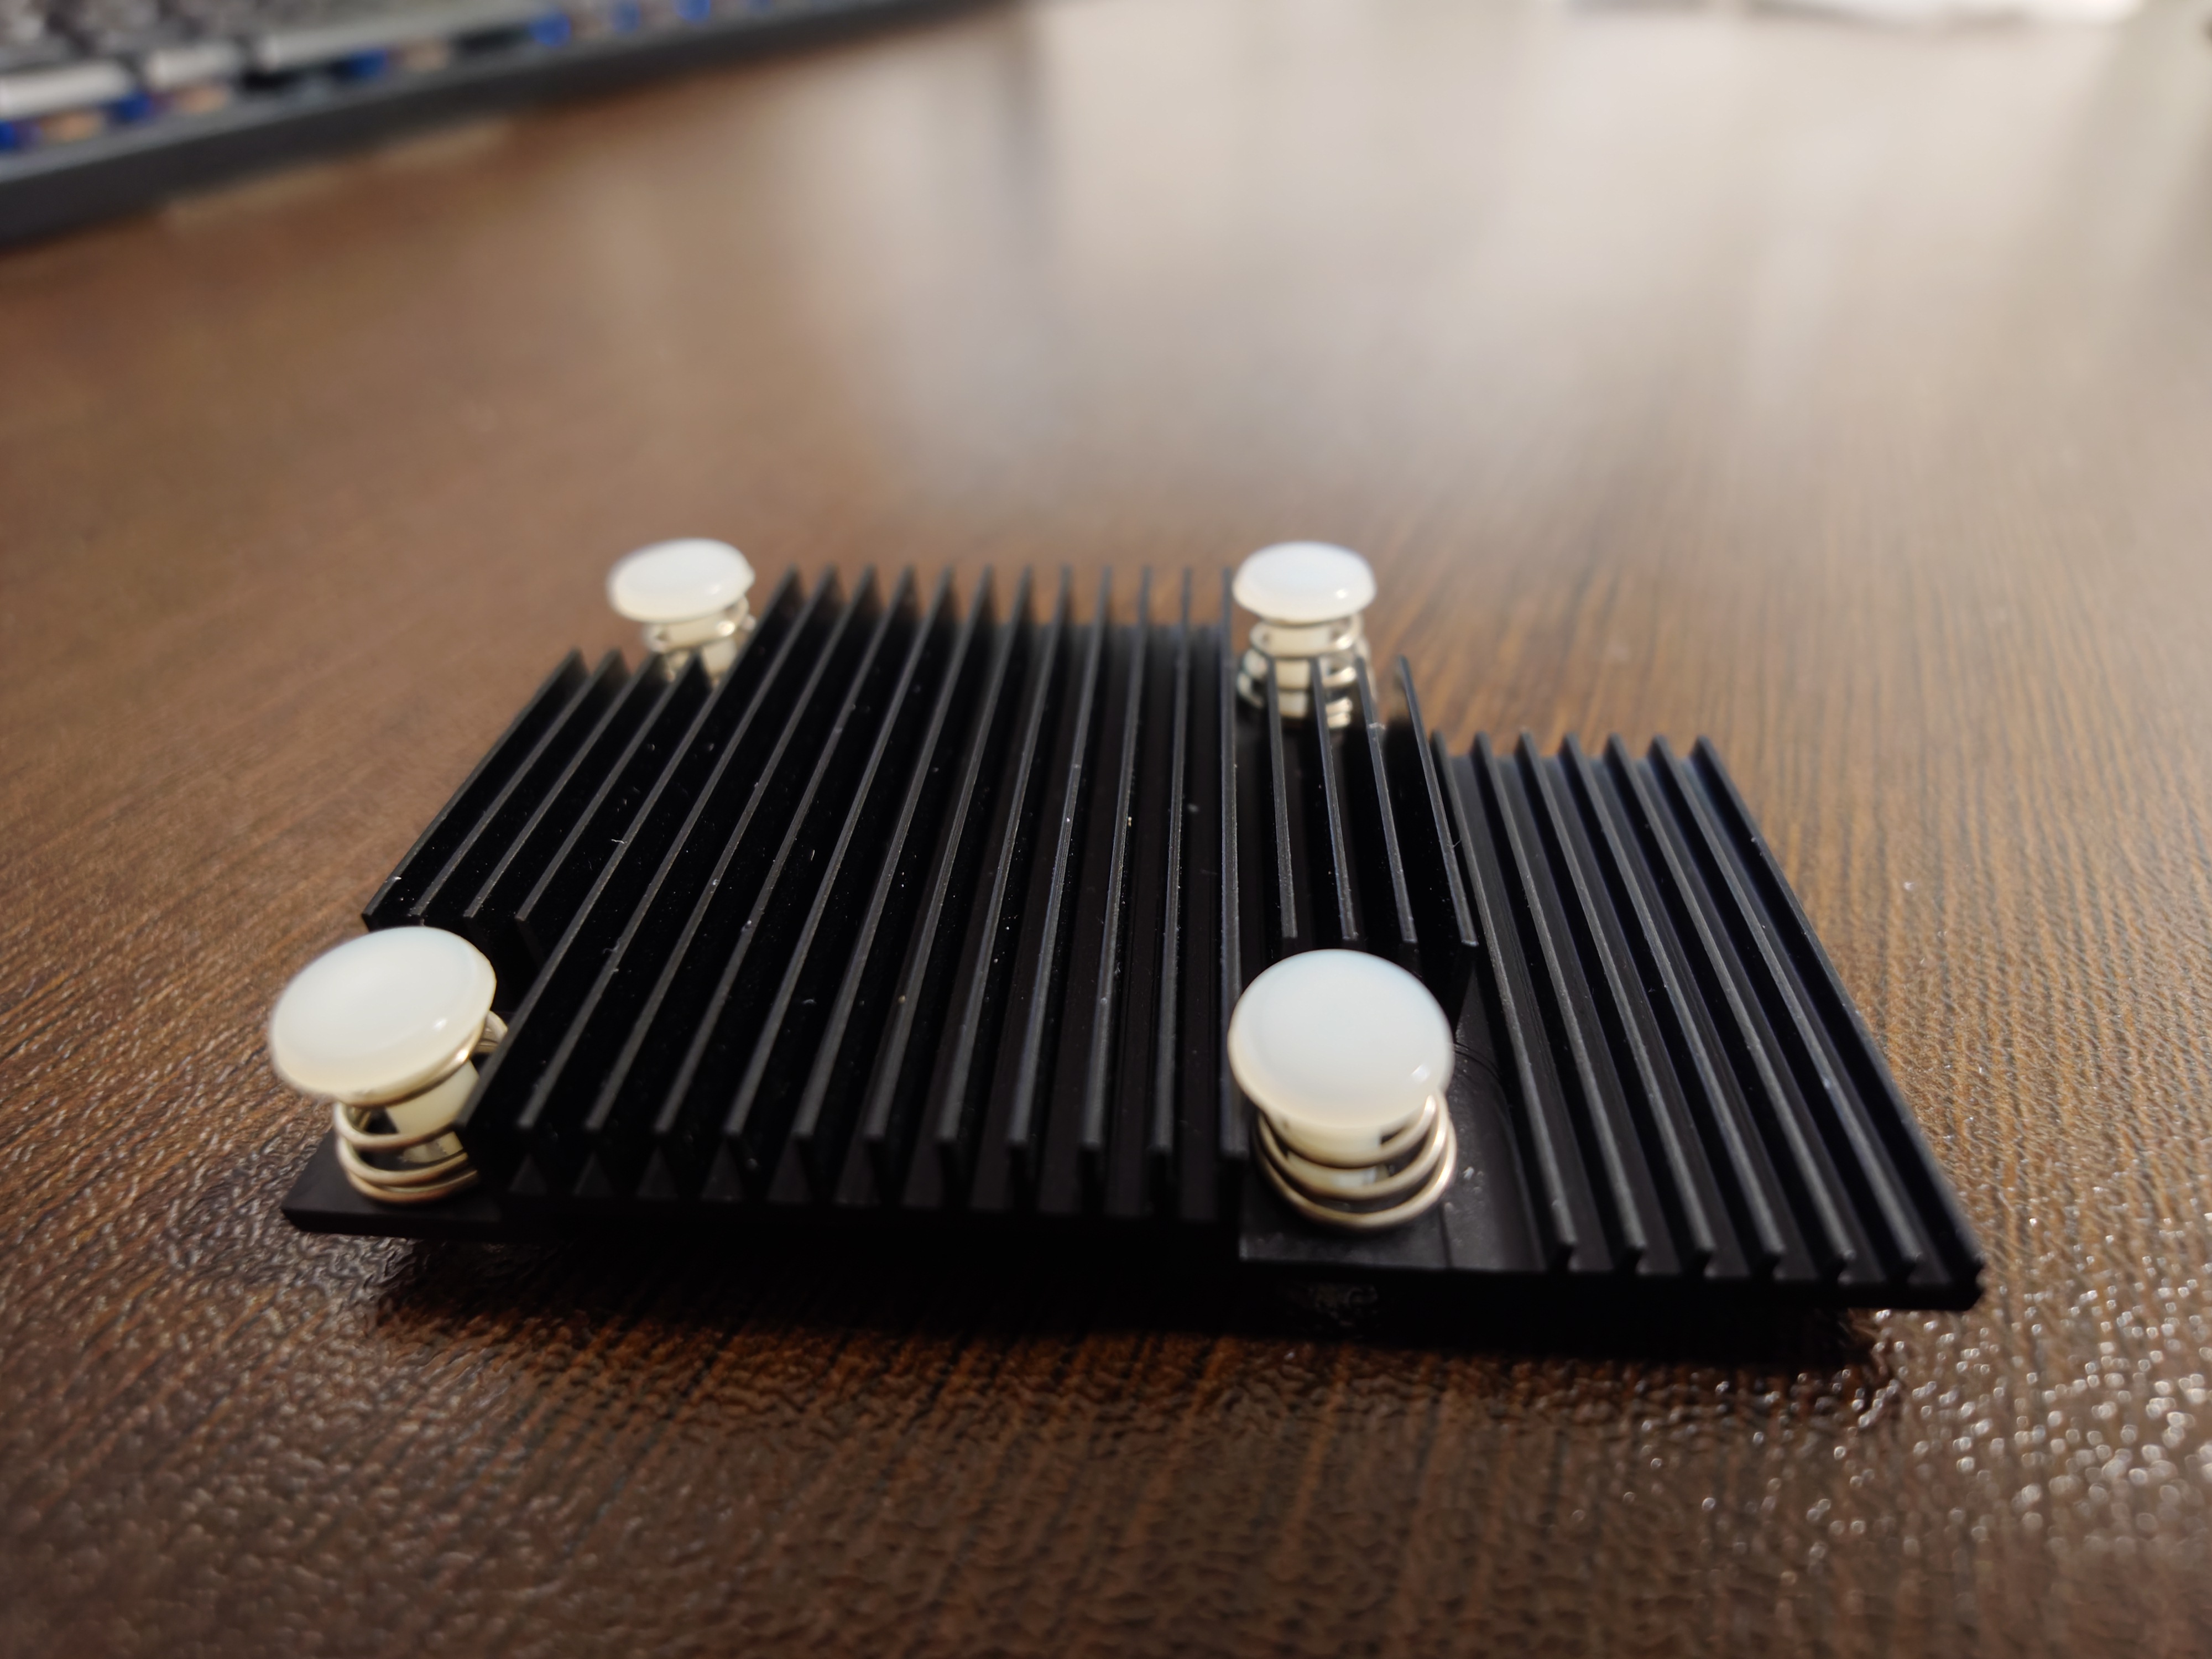
中身。緩衝材が底にあり、本体も一応元袋らしきものに入っていた。いい感じのヒートシンクがついているのが素晴らしい。

賞味期限ラベルみたいなものが貼ってあったが非常に強力なシールで、爪でカリカリすると爪が削れるレベルで剥がせなかったため剥がすのを諦めた。
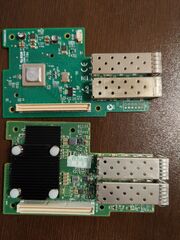
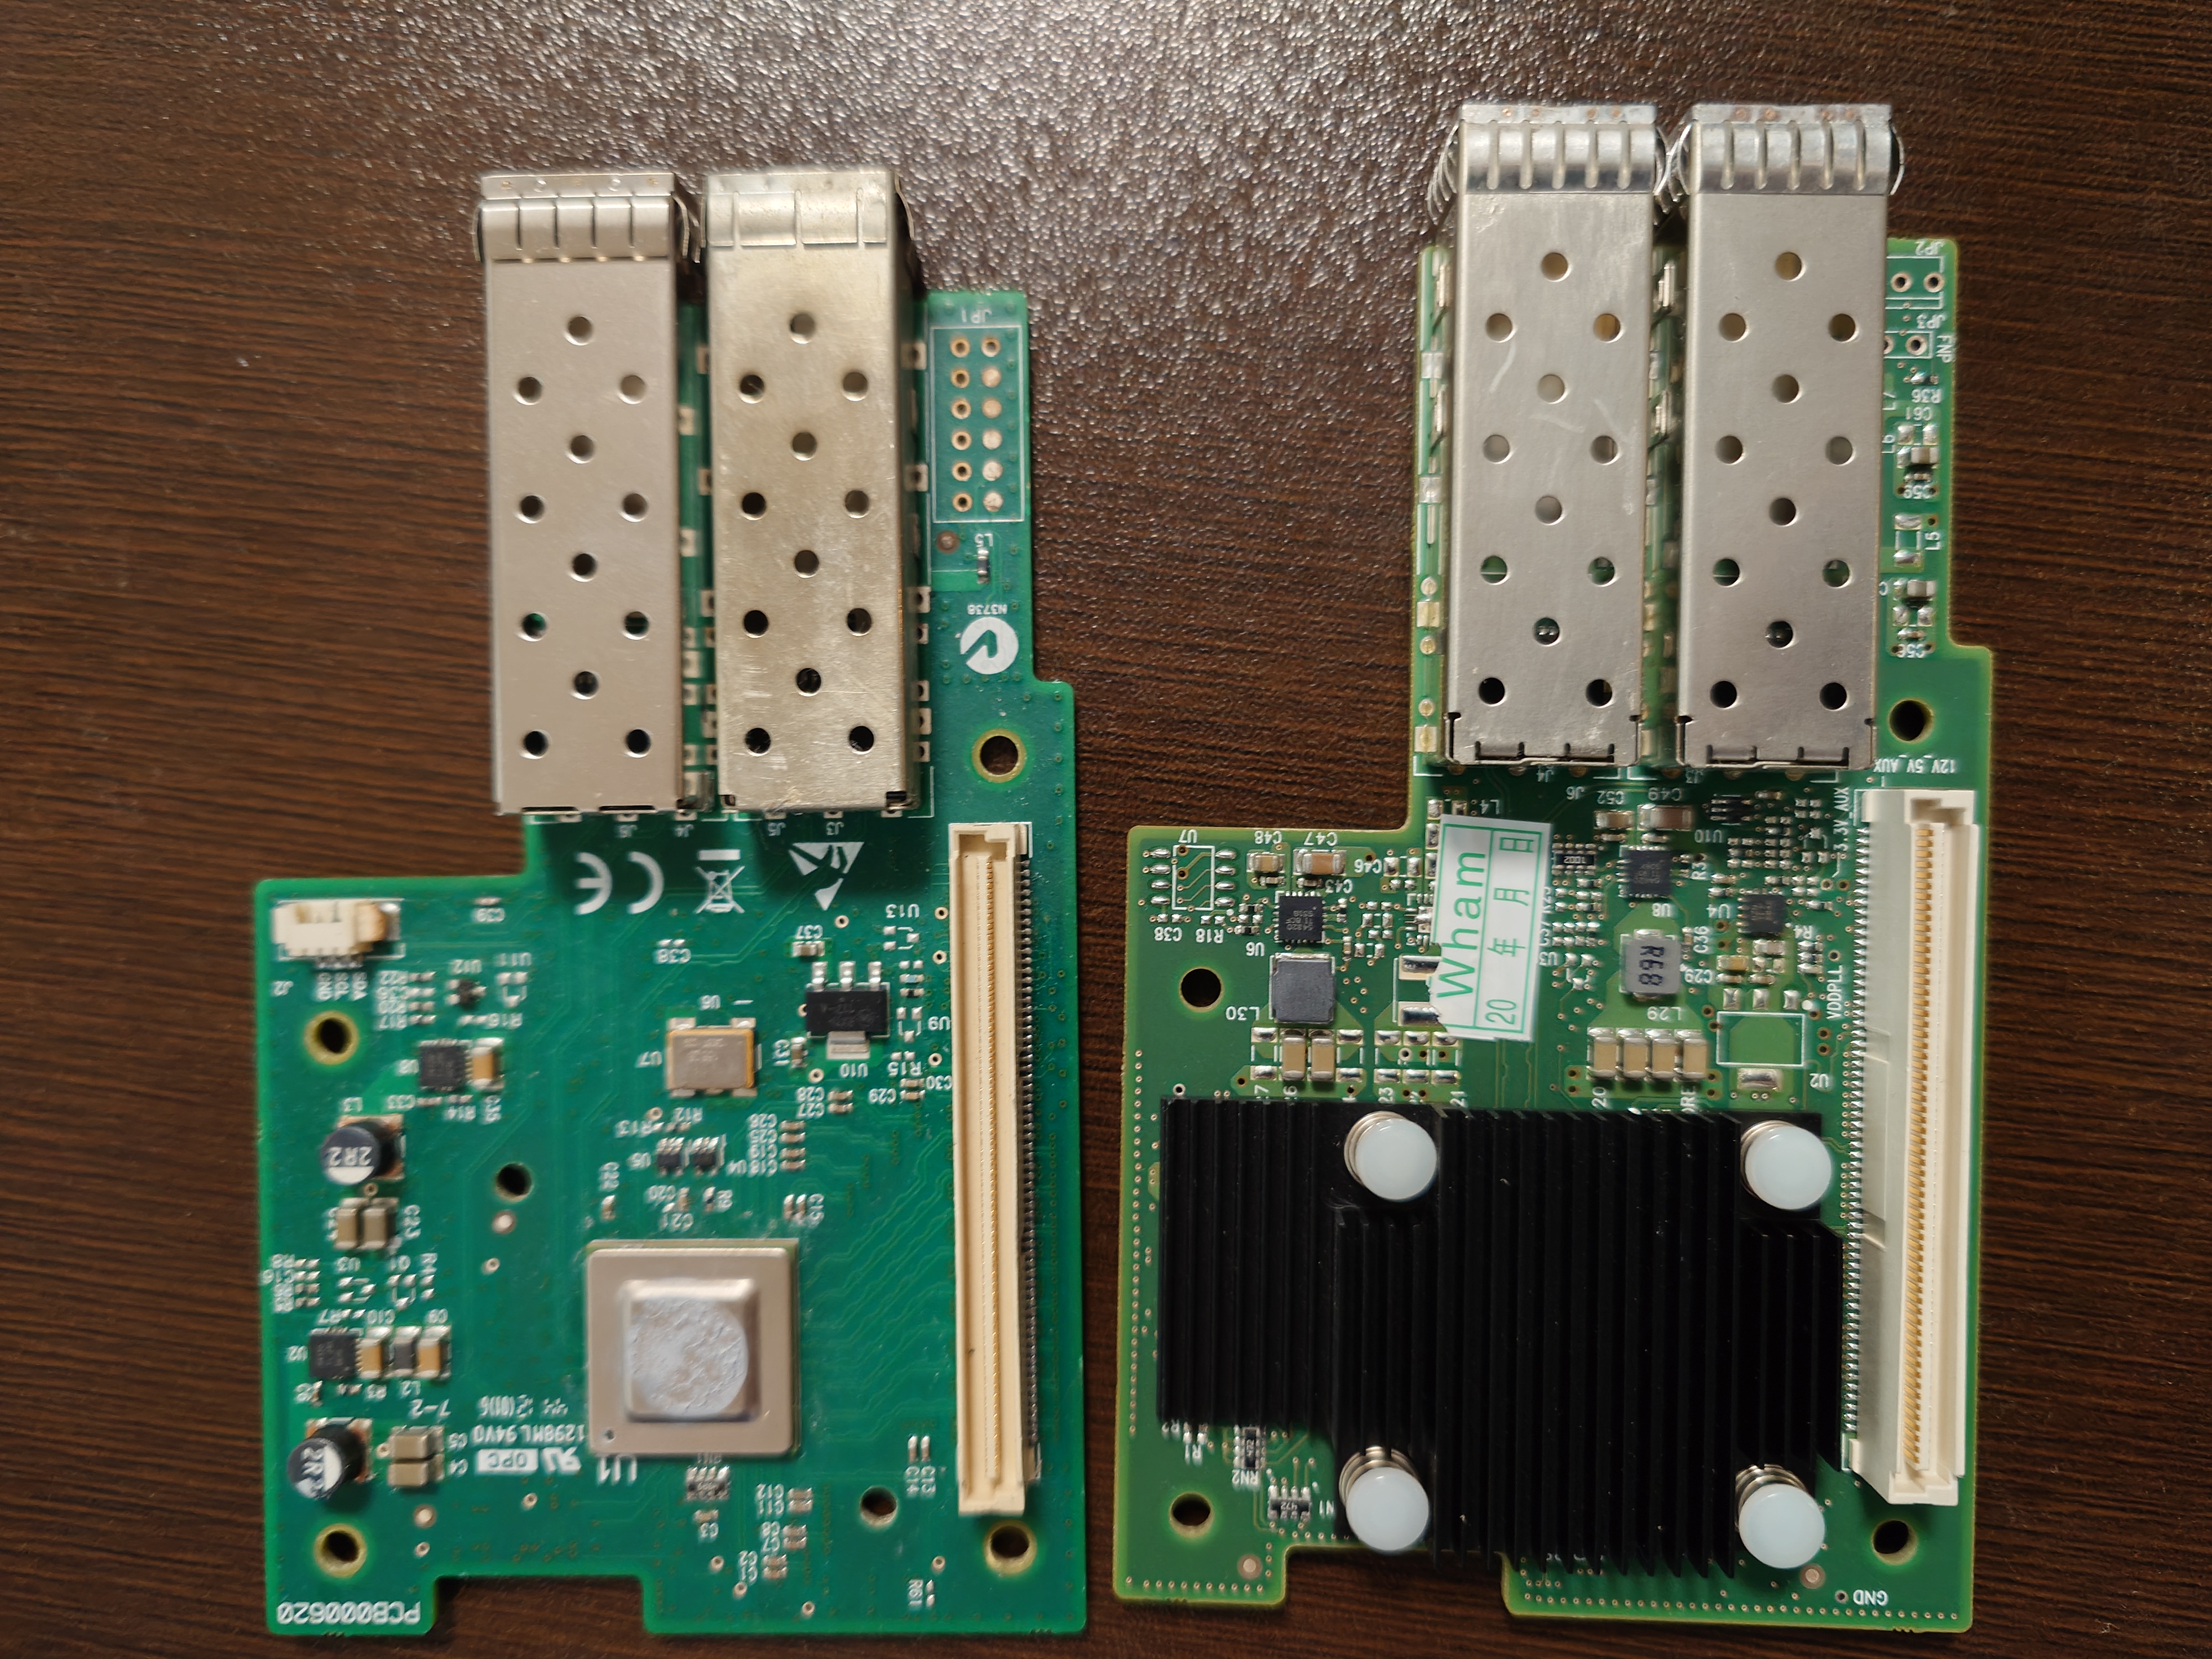
新旧比較をすると上が今まで使っていたやつで、下が今回新たに買ったやつだ。
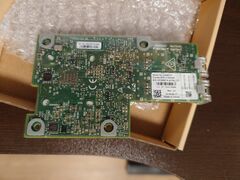
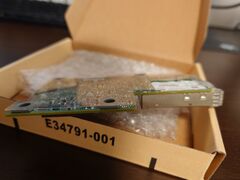
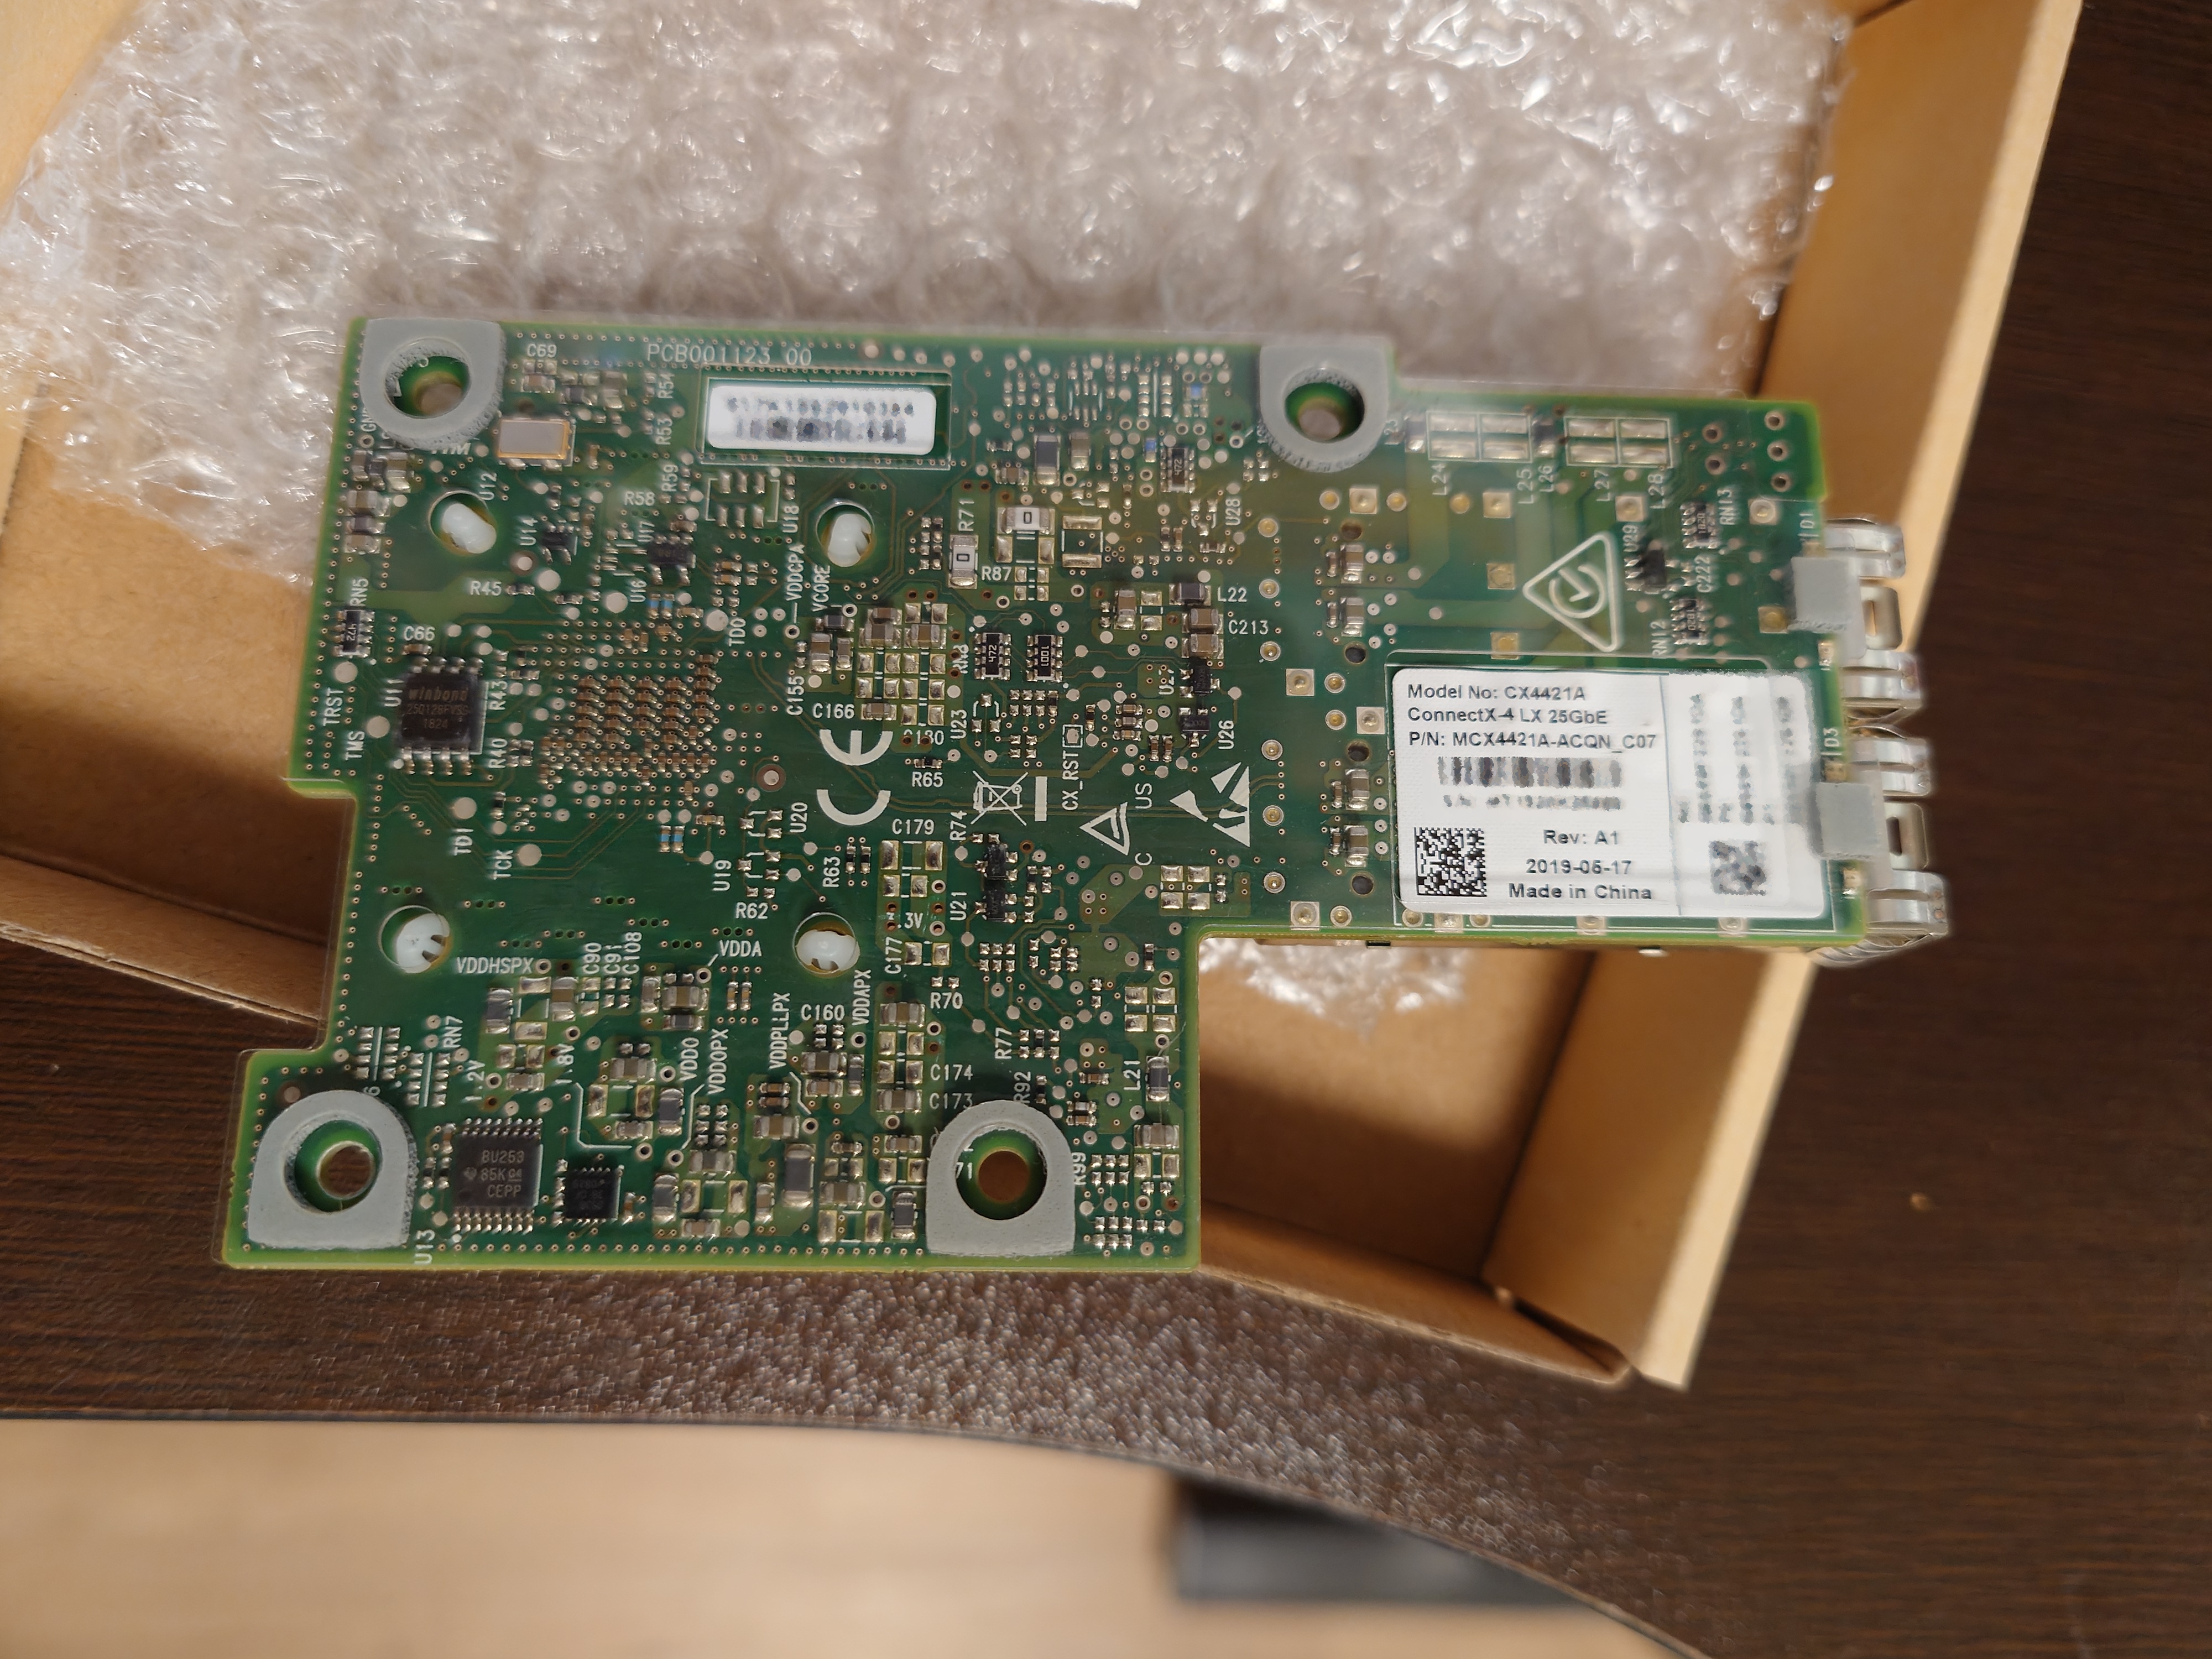
裏返したところ。裏面には薄いアクリルフィルムが基板を保護するように付いていた。短絡防止用だろうか?ヒートシンクを支えるプッシュピンも見えた。

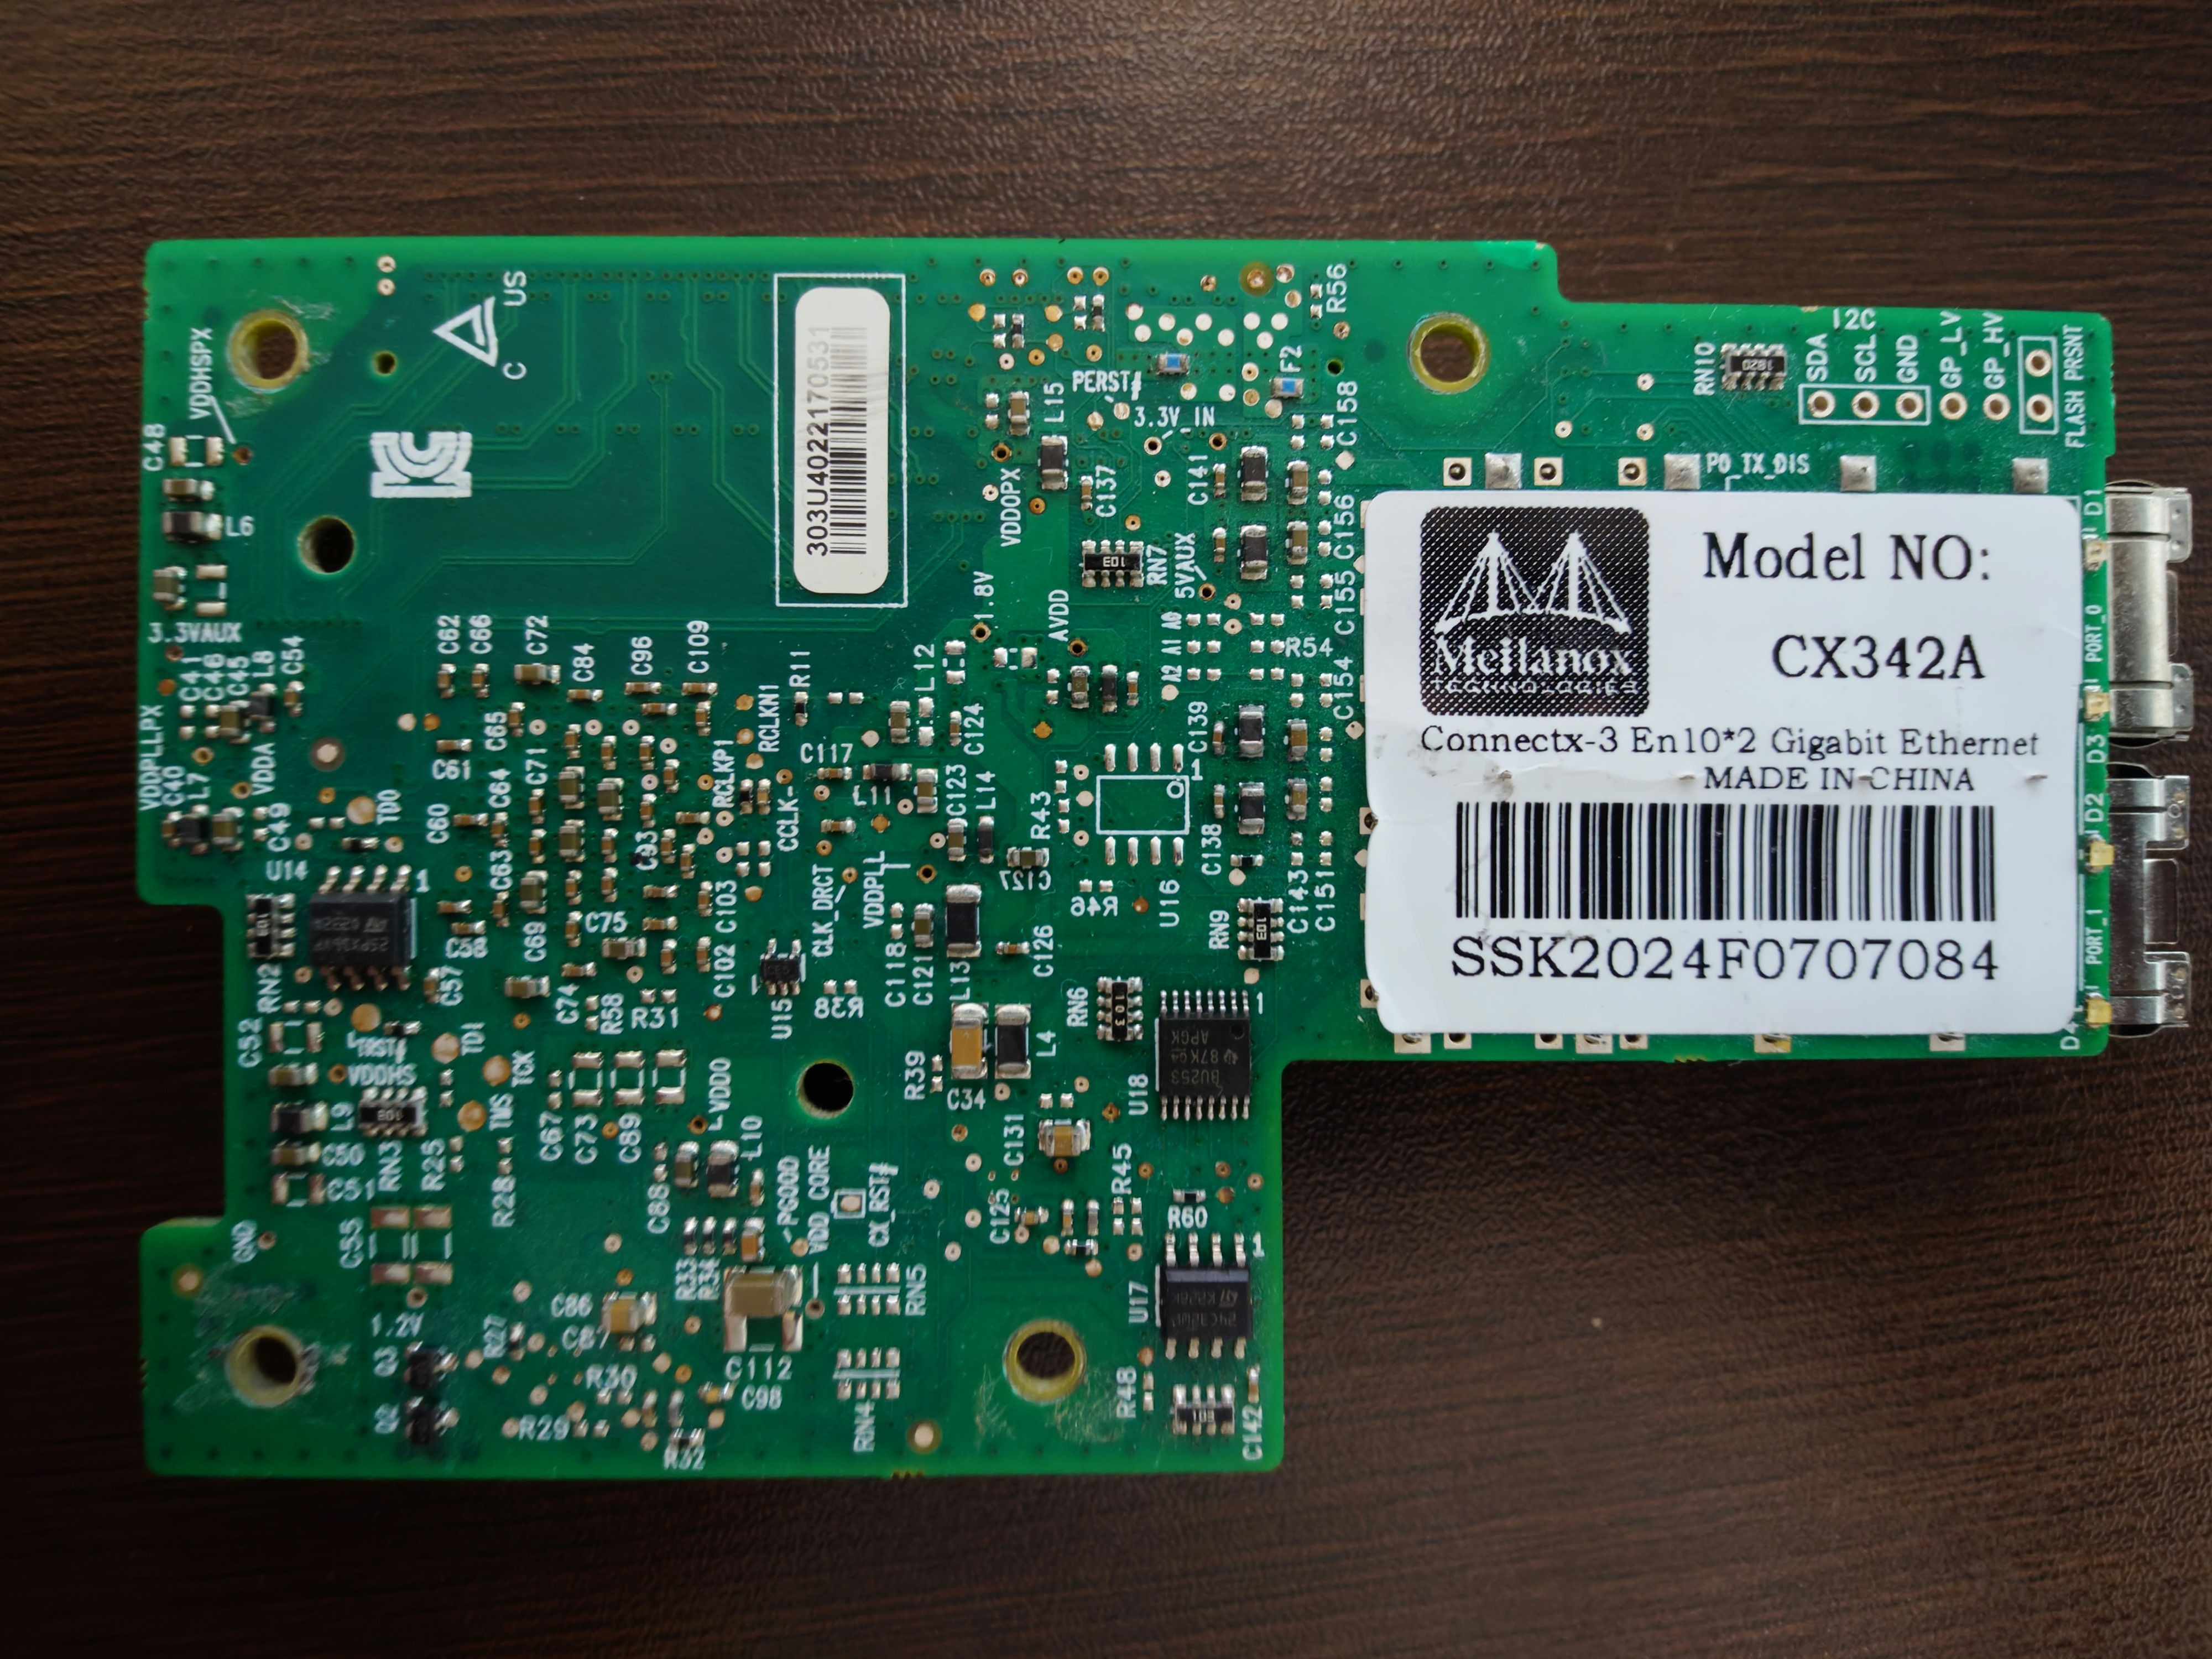
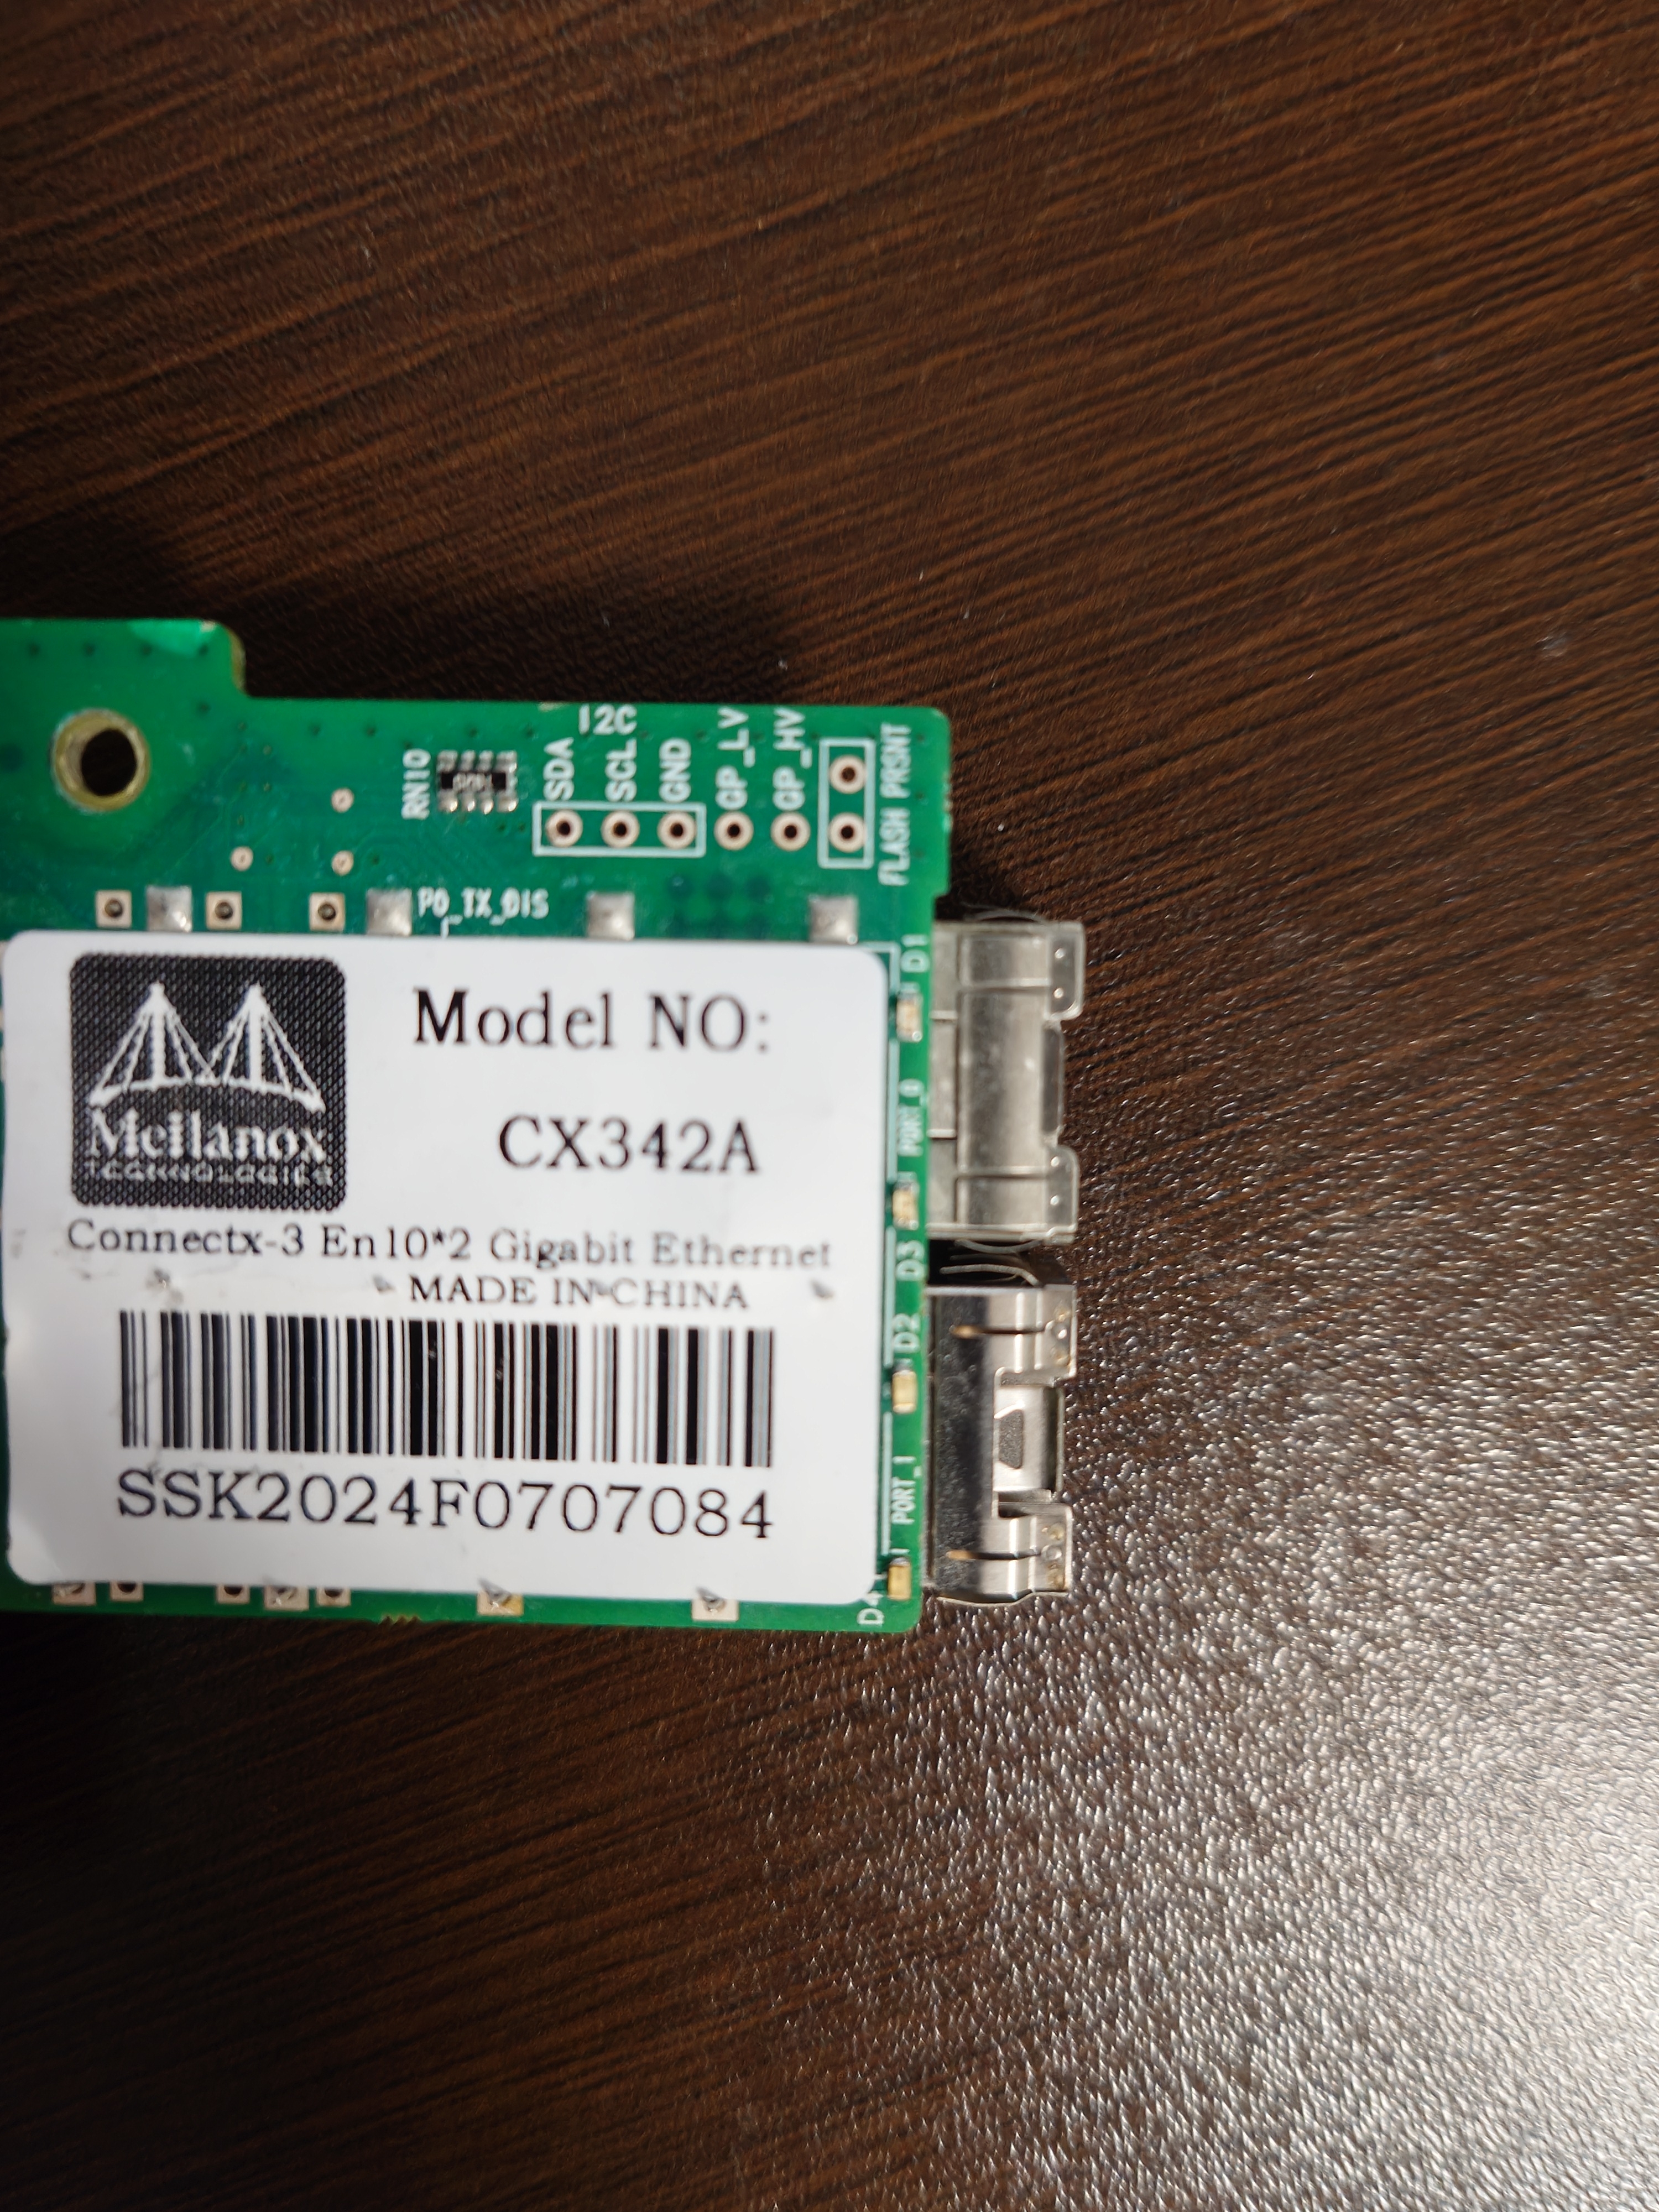
ラベルを見る限り2019年6月製とみられ、比較的新しい製品なのも嬉しい。以前使っていたConnectX-3は製造時期不明だがCX342Aは2015年のモデルらしいので、だいぶ古い。

どこで見たか記憶にないがConnectX-3はサポート切れが近いか、切れていることもあるという話も見た気がするのでConnectX-4を入手できたのはよかった。メイン機もサーバー機もNICはConnectX-4なのでお揃いになった。

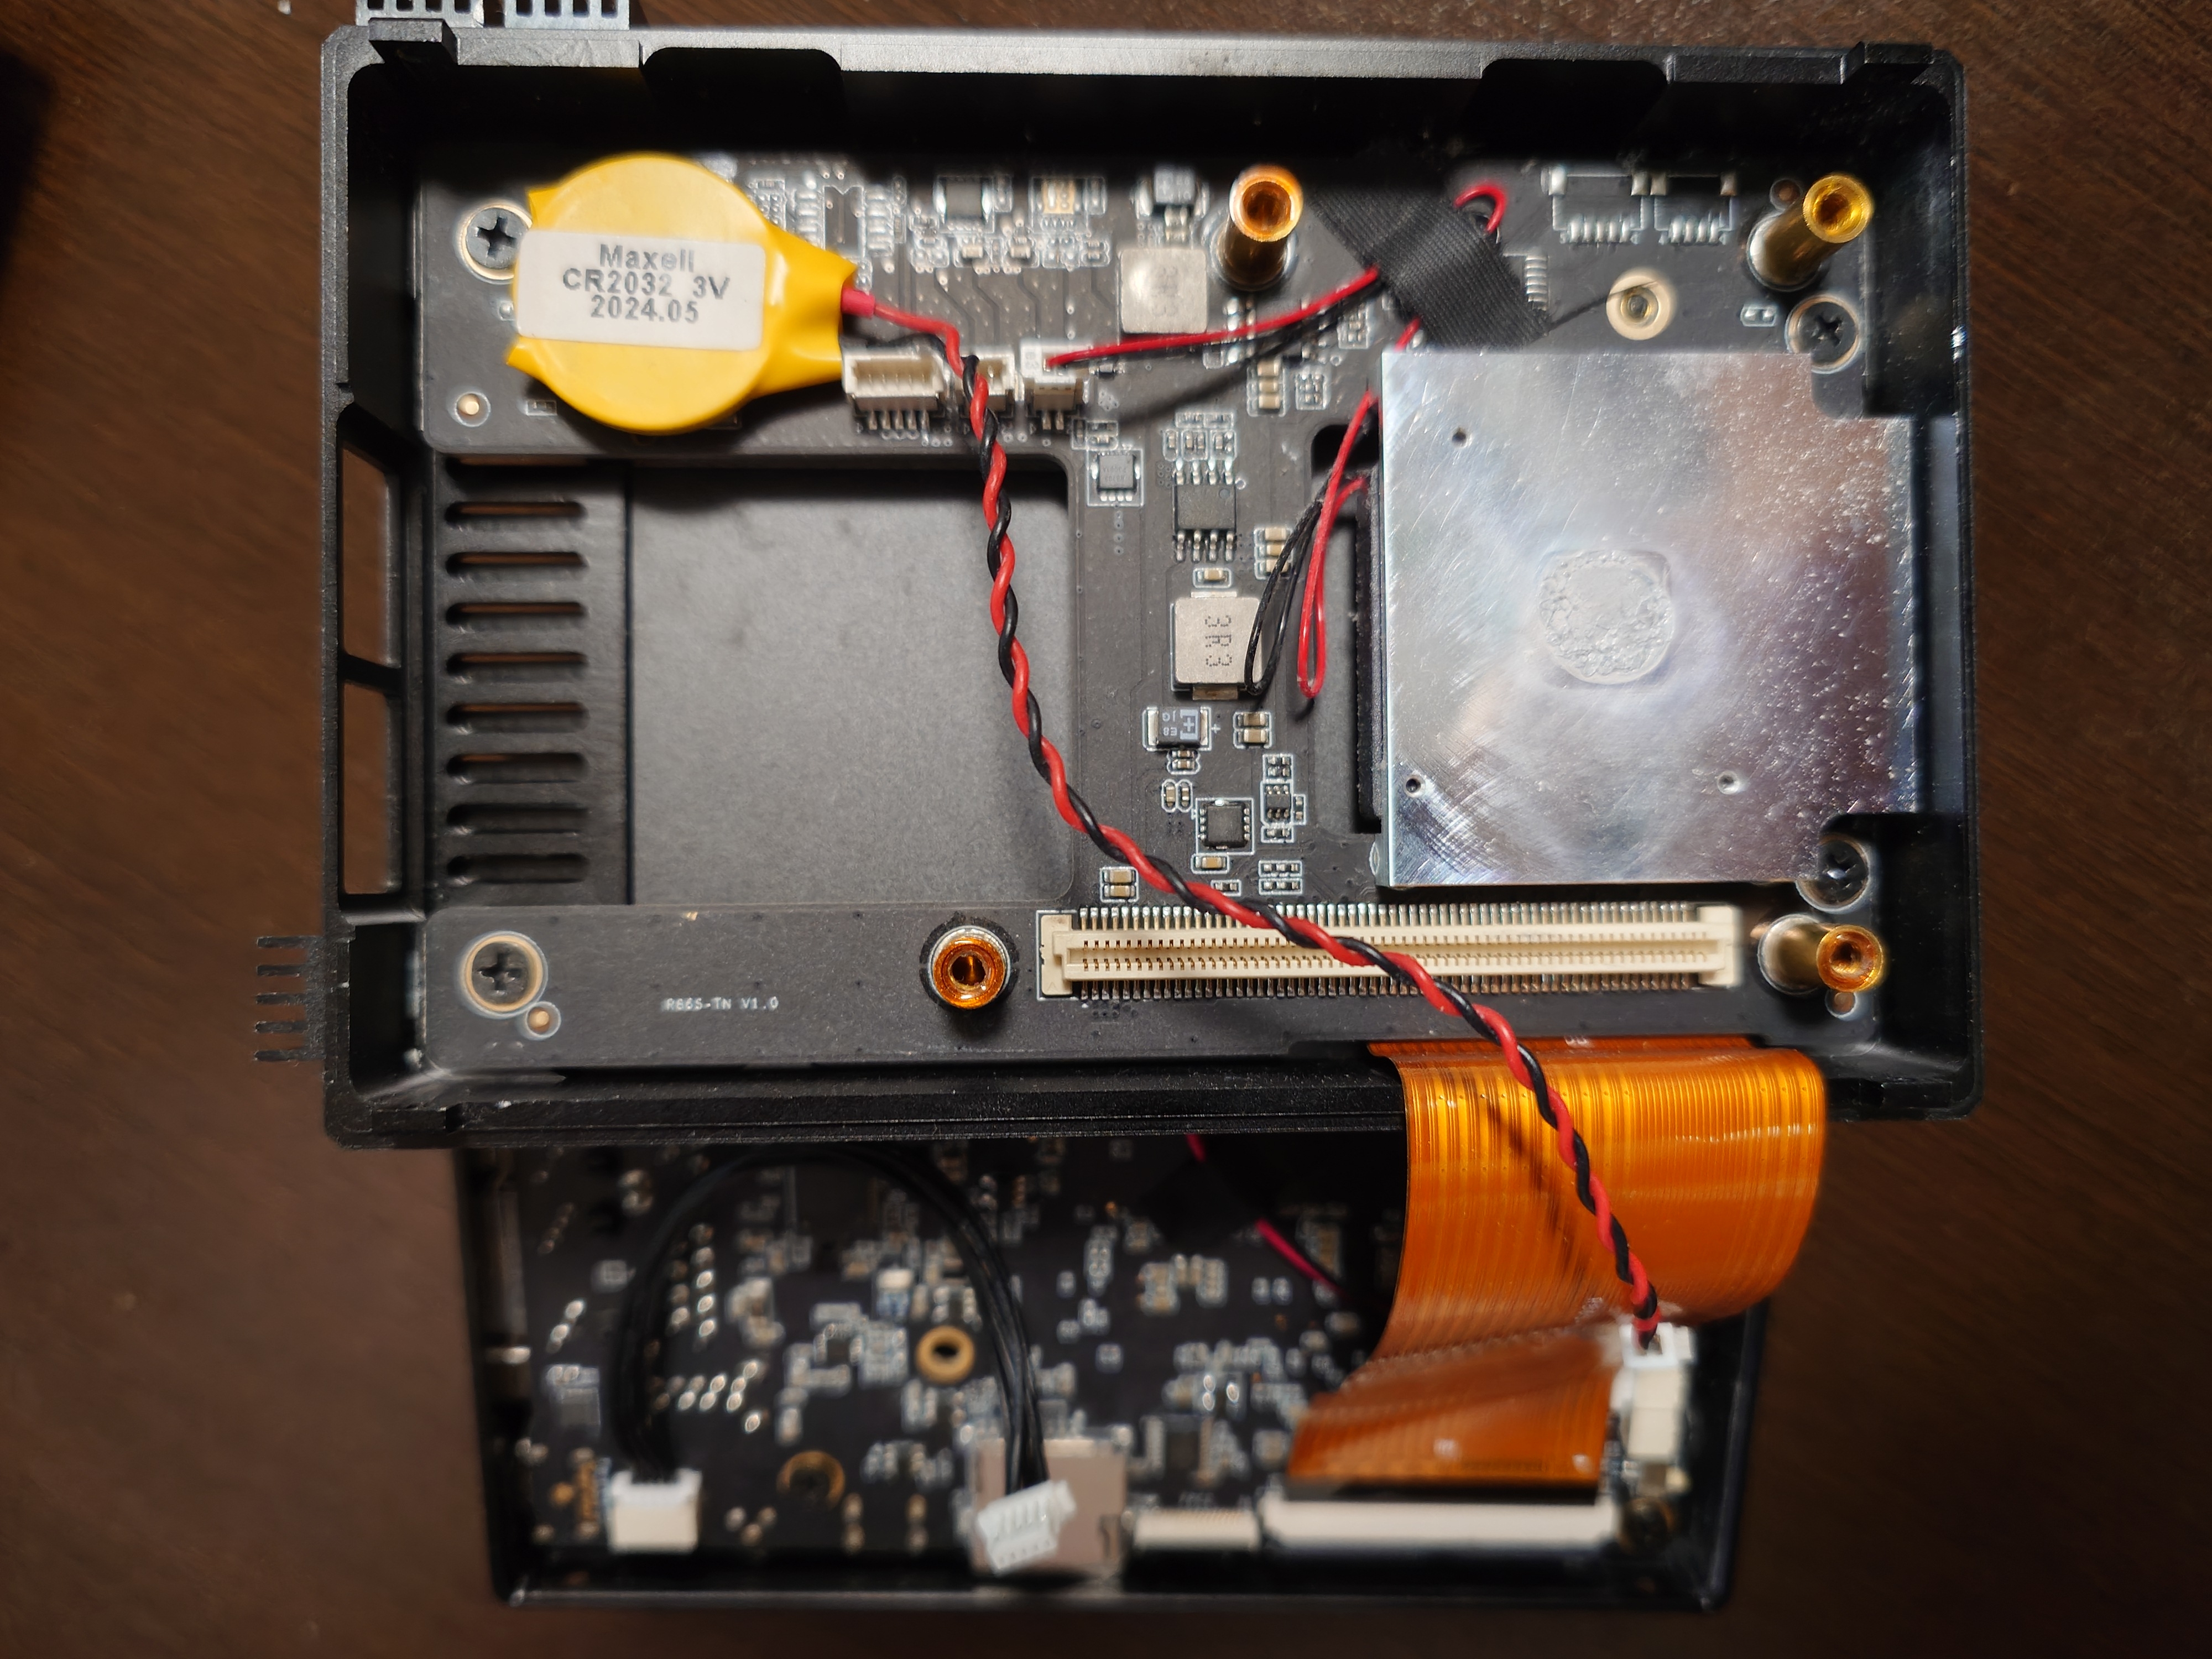
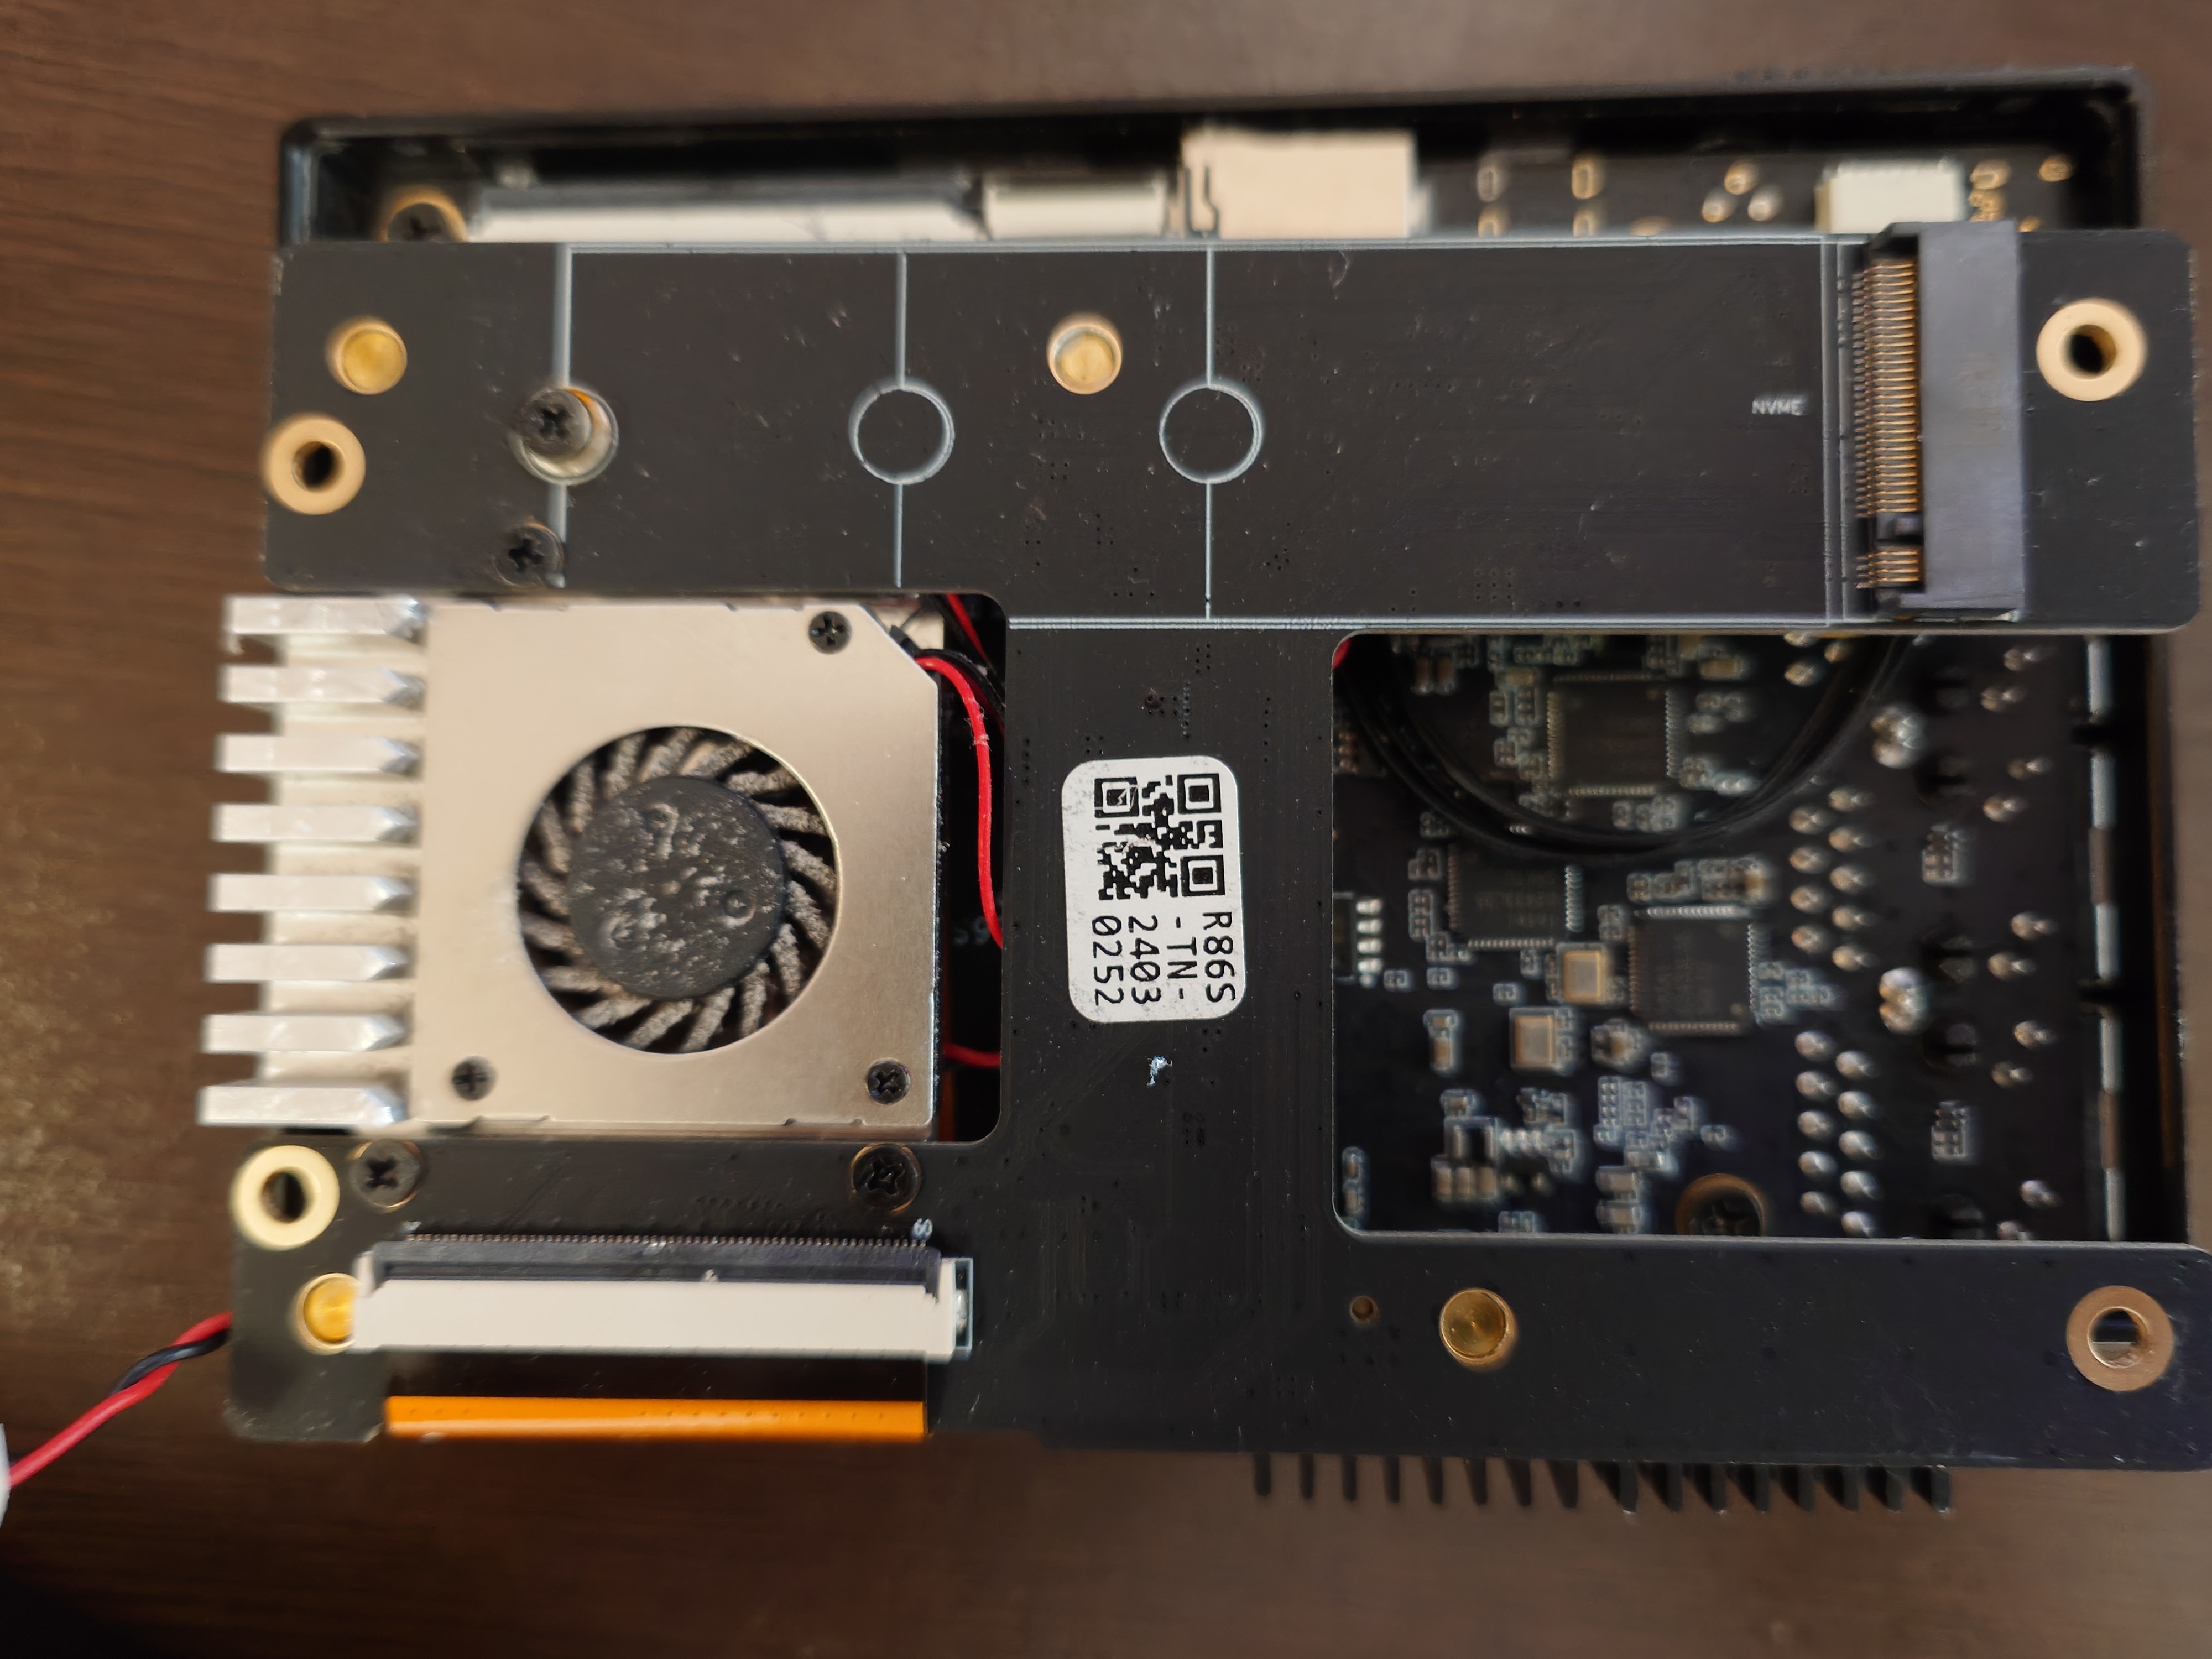
装着は既存のConnetX-3を外し、カードを刺す場所に元々ついてたチップクーラーを除去して取り付けたら、そのまま何事もなく普通に装着できた。
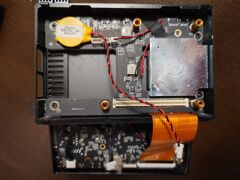
このクーラーがあるとヒートシンクに干渉するので、外す必要があった。

OpenWrt上でのセットアップ

OpenWrt 24.10.0にはドライバがなかったのでドライバを入れるのをやっていく。

SFP+以外に接続手段のない私の環境ではルーターのSSHに繋ぐ術がなかったので、R86S U1本体にキーボードとモニタを接続して作業した。

# まずはNIC周りの調査ツールを入れる
opkg update
opkg install pciutils ethtool

# ドライバの状態とかが見れる
# Kernel driver in use: igcならドライバがない
lspci -nnk

# ドライバを入れる。kmod-mlx4-coreは後で消した
opkg install kmod-mlx5-core
# JISキーボードだとアンスコが出せないので頑張って探して打った
modprobe mlx5_core

あとはこのまま再起動したら普通に繋がった。

そのまま使うと温度が上がりすぎた

現状片側のSFP+しか使っていないうえ、それも初日なので不具合は何もない。以前使っていたのも最低でも一週間は使ってないと不安定化しなかったので、まだ安定性は不明だ。

ただソケットが両方とも同じ形に見えるので、以前使っていたものよりは安定するのではないかと考えている。
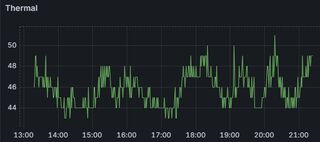
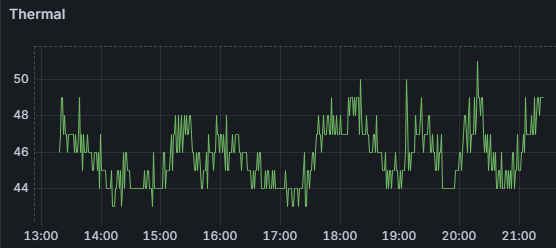
温度については高くなりがちなようで、R86S U1本体のCPU温度が51度に達することもあった。

以前のNICの温度はデータがなく比較できないのだが、ここまで上がっていることはなかった気がしている。

NIC本体の温度は取得する方法が今のところ分かっていない。mstflintでmstflint -d xxxx -reg_name MTMPとかしたら、提供されていないとか出た気がするがログは取っていない。

参考までに以下の手順でレジスタの値が取れるっぽい。参考:man/mstreg

# 必要なツールのインストール
opkg install lspci mstflint
# MellanoxのデバイスIDの取得
lspci | grep Mellanox | awk '{print $1}'
# レジスタ名一覧
mstflint -d <デバイスID> -show_regs
# レジスタ値の取得
mstflint -d <デバイスID> -reg_name <レジスタ名> -g

関係ないがデータがないのはGrafanaに出しているデータを永続化していないため、tmpが吹き飛ぶと消える状態なので、ここはそのうち何とかしないといけない。

冷却対策

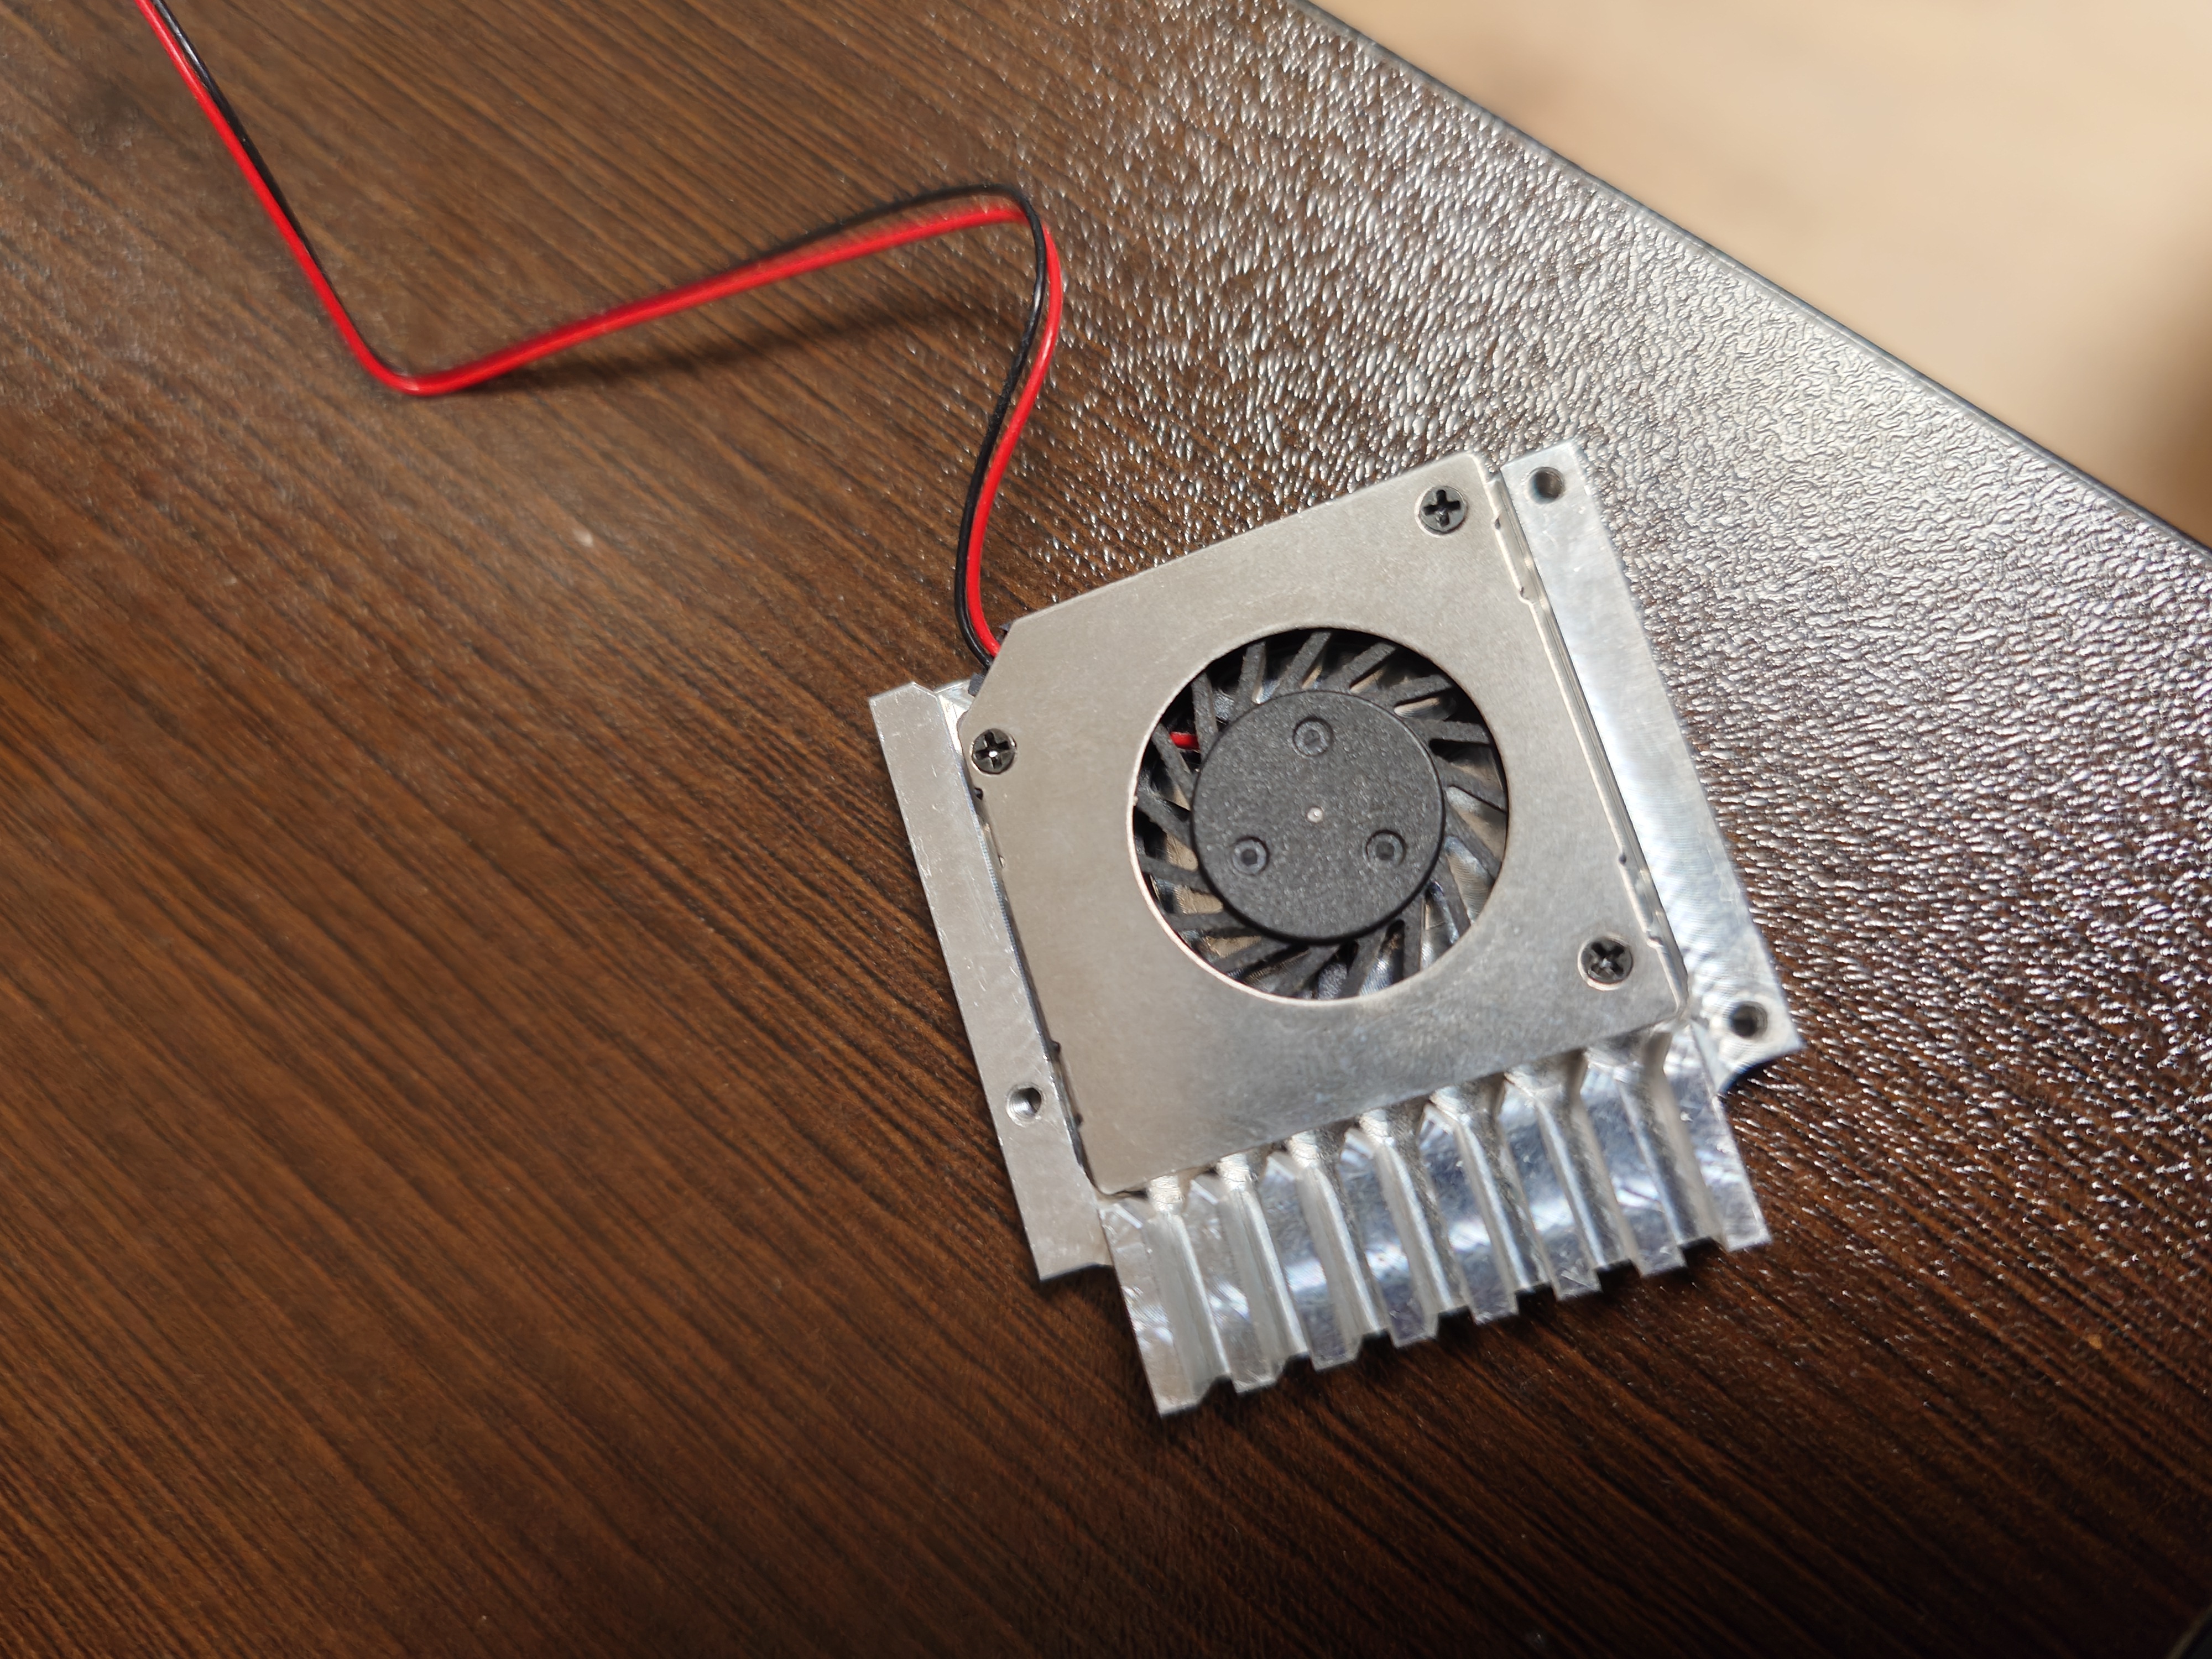
端的に言うとヒートシンクを剥がし、R86S U1に元からついてるクーラーを装着した。
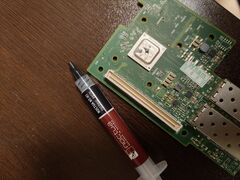
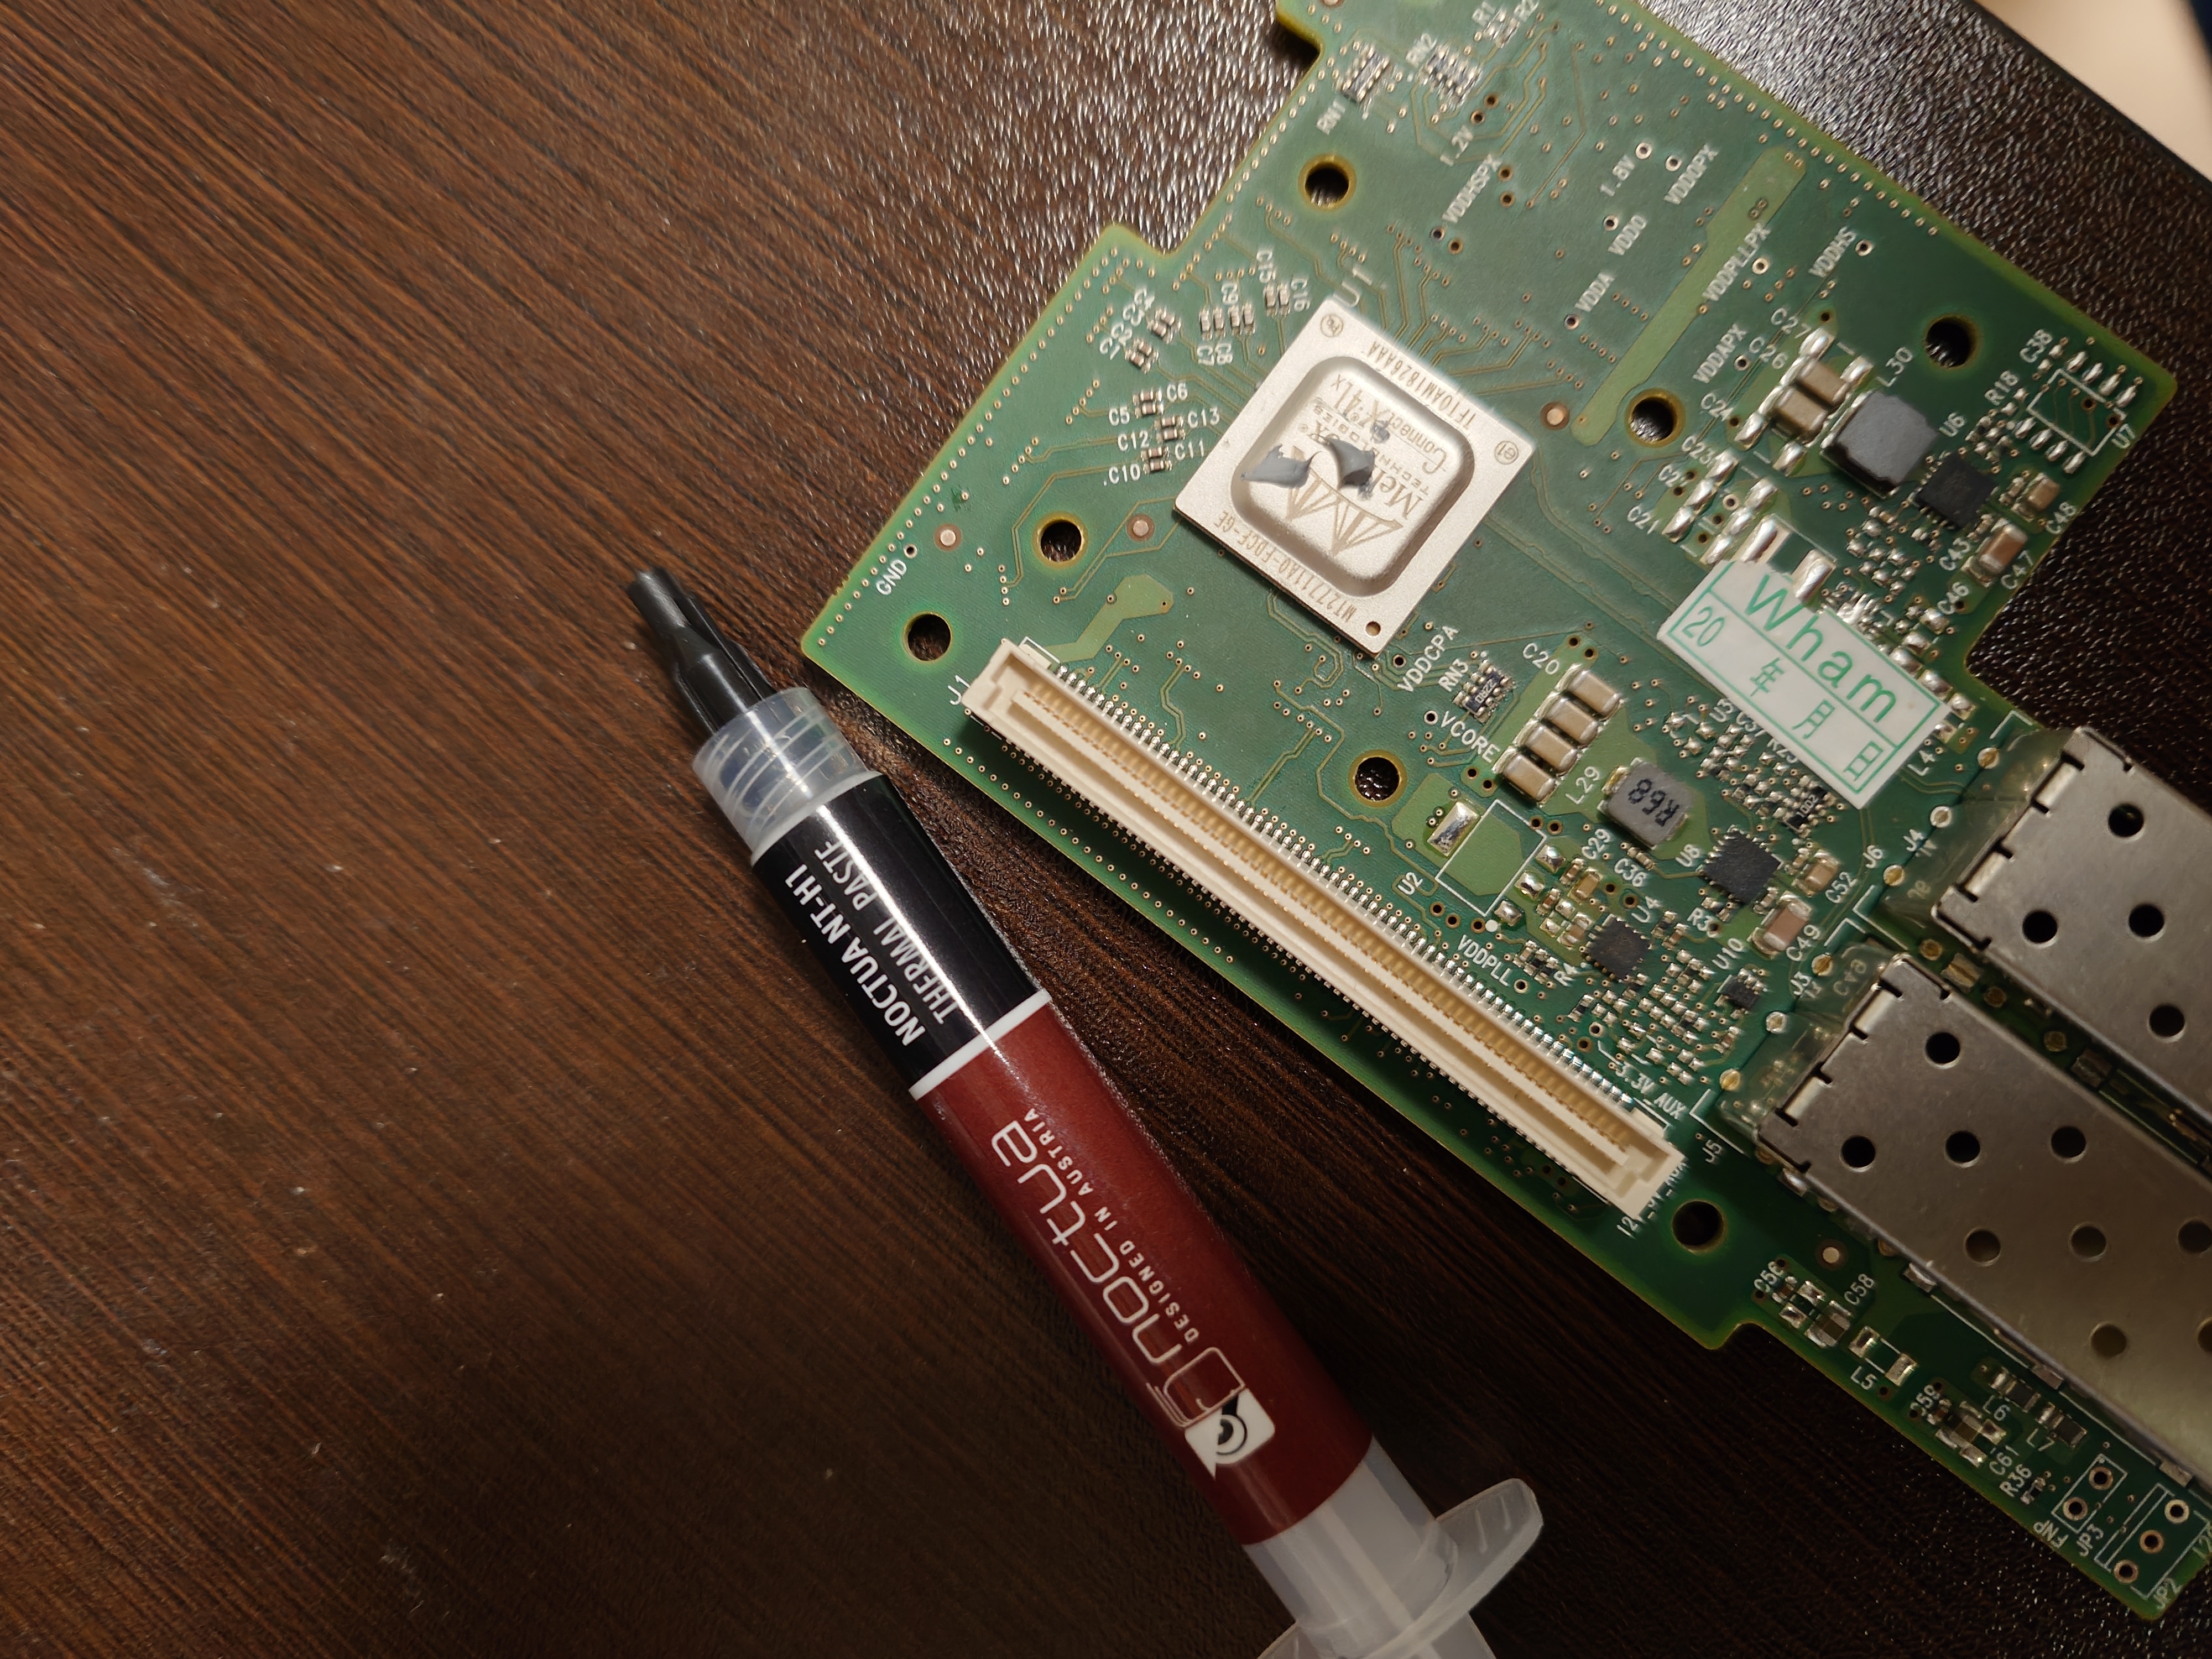
まずはConnectX-4を取り出し、ヒートシンクを外し、グリスを塗りなおす。この時ついでに裏のフィルムも剥がし、熱が溜まらないようにした。
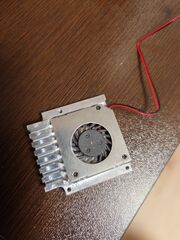
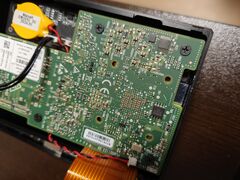
R86S U1に元々ついてたチップクーラー(前述の奴)を持ってきて、付け直した。
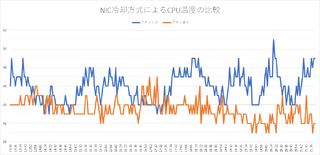
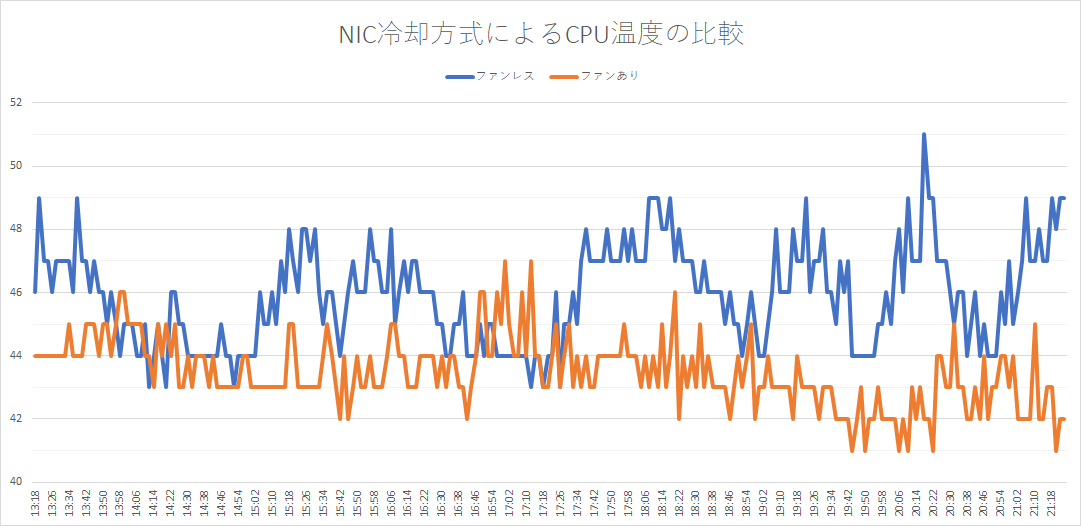
ファンレス冷却(ヒートシンク)とファン冷却(クーラー)で同時刻に温度を比べたところ、5度ほど下がるという結果が出たので、かなり効果があった。
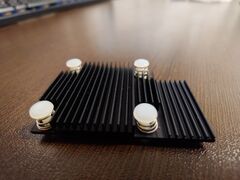
新しい奴のヒートシンクの方が目が細かく作りもしっかりしているように見えるが、風のあるなしがそれほどまでに大きいということだろう。

しょぼいヒートシンクと小さいファンの組み合わせなのであまり意味がないだろうと侮っていたが、結果は歴然だった。恐らくこれはケースが小さく通気の余地が少ないこともあり、自然対流には期待できないということの表れなのだろう。

ベンチマーク

以下の構成で速度を計測した結果。そもそもLAN内でパケットがルーターの中を通っているかが謎なのでルーターNIC交換の影響があるかどうかは不明である。

Windows - R86S U1 - MikroTik CRS305-1G-4S+IN - Ubuntu

以前の計測結果はこっち。

Windows → Ubuntu

[ ID] Interval           Transfer     Bitrate
[  5]   0.00-1.01   sec  1.07 GBytes  9.13 Gbits/sec
[  5]   1.01-2.01   sec  1.09 GBytes  9.36 Gbits/sec
[  5]   2.01-3.00   sec  1.08 GBytes  9.36 Gbits/sec
[  5]   3.00-4.00   sec  1.09 GBytes  9.36 Gbits/sec
[  5]   4.00-5.01   sec  1.10 GBytes  9.36 Gbits/sec
[  5]   5.01-6.00   sec  1.08 GBytes  9.36 Gbits/sec
[  5]   6.00-7.01   sec  1.10 GBytes  9.36 Gbits/sec
[  5]   7.01-8.01   sec  1.09 GBytes  9.36 Gbits/sec
[  5]   8.01-9.01   sec  1.09 GBytes  9.36 Gbits/sec
[  5]   9.01-10.00  sec  1.08 GBytes  9.36 Gbits/sec
- - - - - - - - - - - - - - - - - - - - - - - - -
[ ID] Interval           Transfer     Bitrate
[  5]   0.00-10.00  sec  10.9 GBytes  9.34 Gbits/sec                  sender
[  5]   0.00-10.00  sec  10.9 GBytes  9.33 Gbits/sec                  receiver

Ubuntu→Windows

[ ID] Interval           Transfer     Bitrate         Retr  Cwnd
[  5]   0.00-1.00   sec  1.08 GBytes  9.30 Gbits/sec    0   1.54 MBytes       
[  5]   1.00-2.00   sec  1.08 GBytes  9.28 Gbits/sec    0   1.62 MBytes       
[  5]   2.00-3.00   sec  1.08 GBytes  9.27 Gbits/sec    0   1.70 MBytes       
[  5]   3.00-4.00   sec  1.08 GBytes  9.28 Gbits/sec    0   1.78 MBytes       
[  5]   4.00-5.00   sec  1.08 GBytes  9.28 Gbits/sec    0   1.78 MBytes       
[  5]   5.00-6.00   sec  1.08 GBytes  9.29 Gbits/sec    0   1.78 MBytes       
[  5]   6.00-7.00   sec  1.08 GBytes  9.28 Gbits/sec    0   1.78 MBytes       
[  5]   7.00-8.00   sec  1.08 GBytes  9.28 Gbits/sec    0   1.93 MBytes       
[  5]   8.00-9.00   sec  1.08 GBytes  9.28 Gbits/sec    0   1.93 MBytes       
[  5]   9.00-10.00  sec  1.08 GBytes  9.28 Gbits/sec    0   1.93 MBytes       
- - - - - - - - - - - - - - - - - - - - - - - - -
[ ID] Interval           Transfer     Bitrate         Retr
[  5]   0.00-10.00  sec  10.8 GBytes  9.28 Gbits/sec    0             sender
[  5]   0.00-10.00  sec  10.8 GBytes  9.28 Gbits/sec                  receiver

まとめ

前回と比較すると若干速度が落ちているが、サーバーとして動かしてて帯域を食っている分減っているのかもしれない。

Windows→Ubuntu(上り) Windows→Ubuntu(下り) Ubuntu→Windows(上り) Ubuntu→Windows(下り)
9.34 Gbps 9.33 Gbps 9.28 Gbps 9.28 Gbps

交換前のConnectX-3が改造品だった話

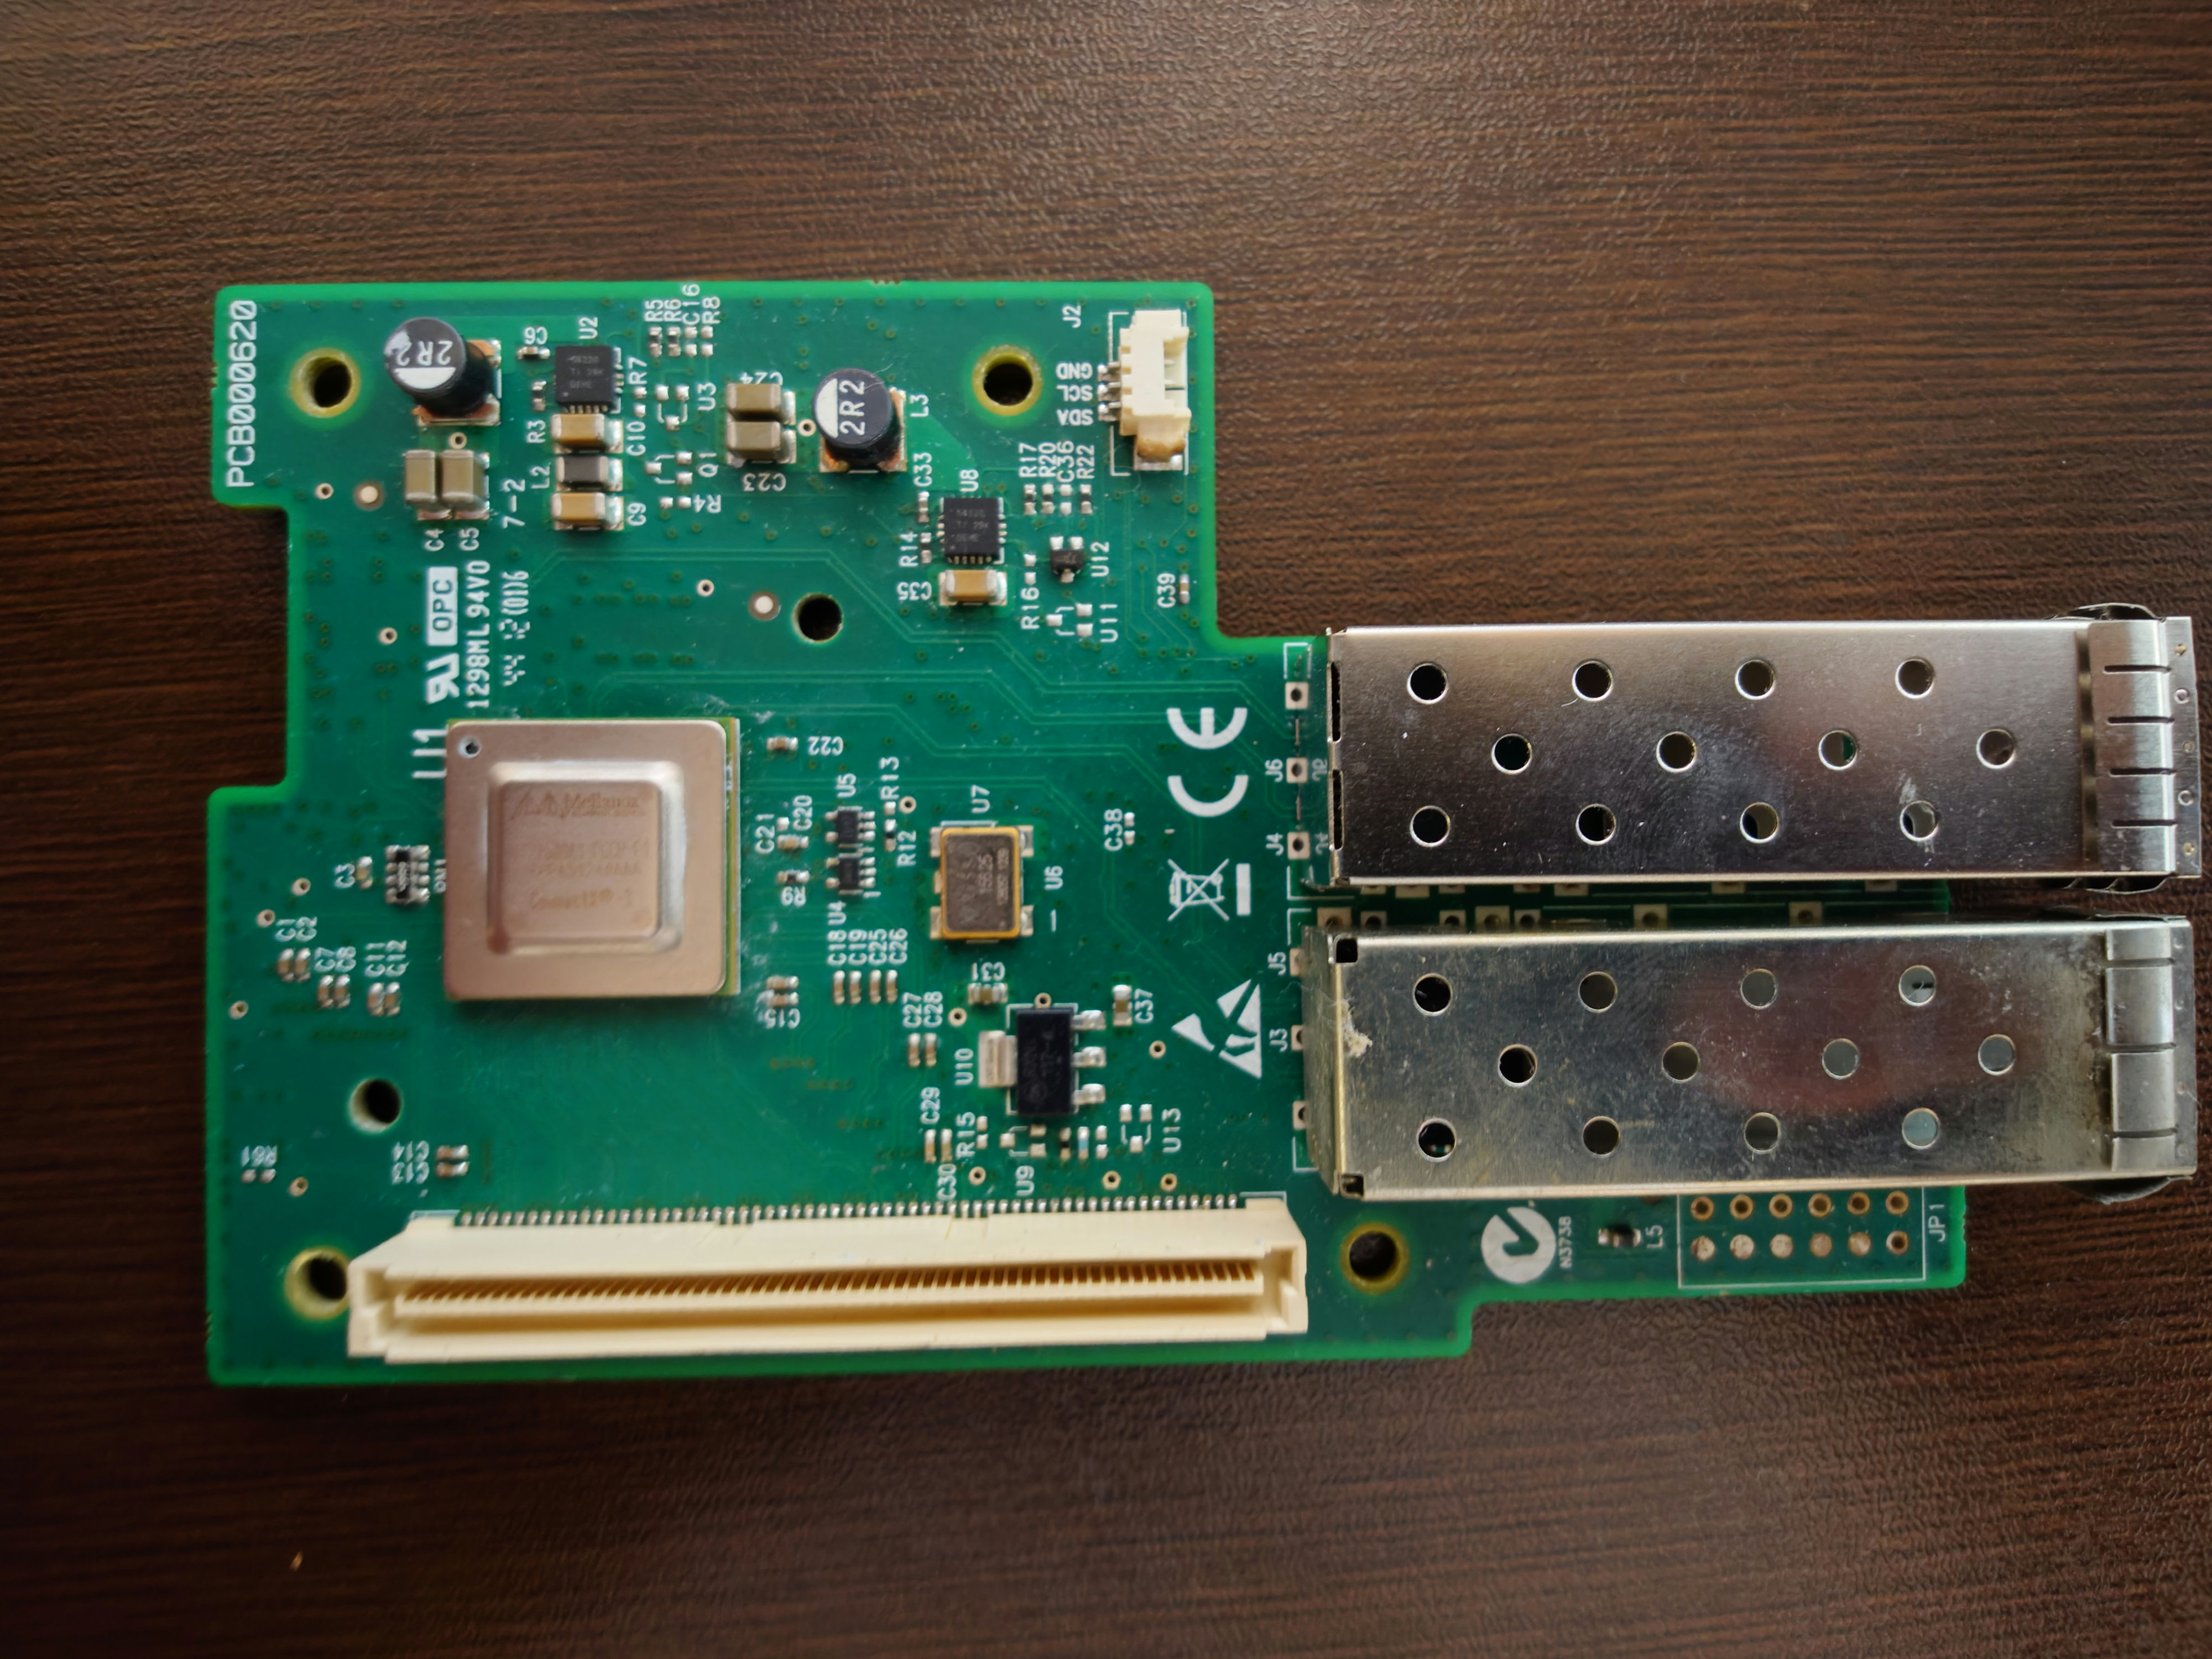
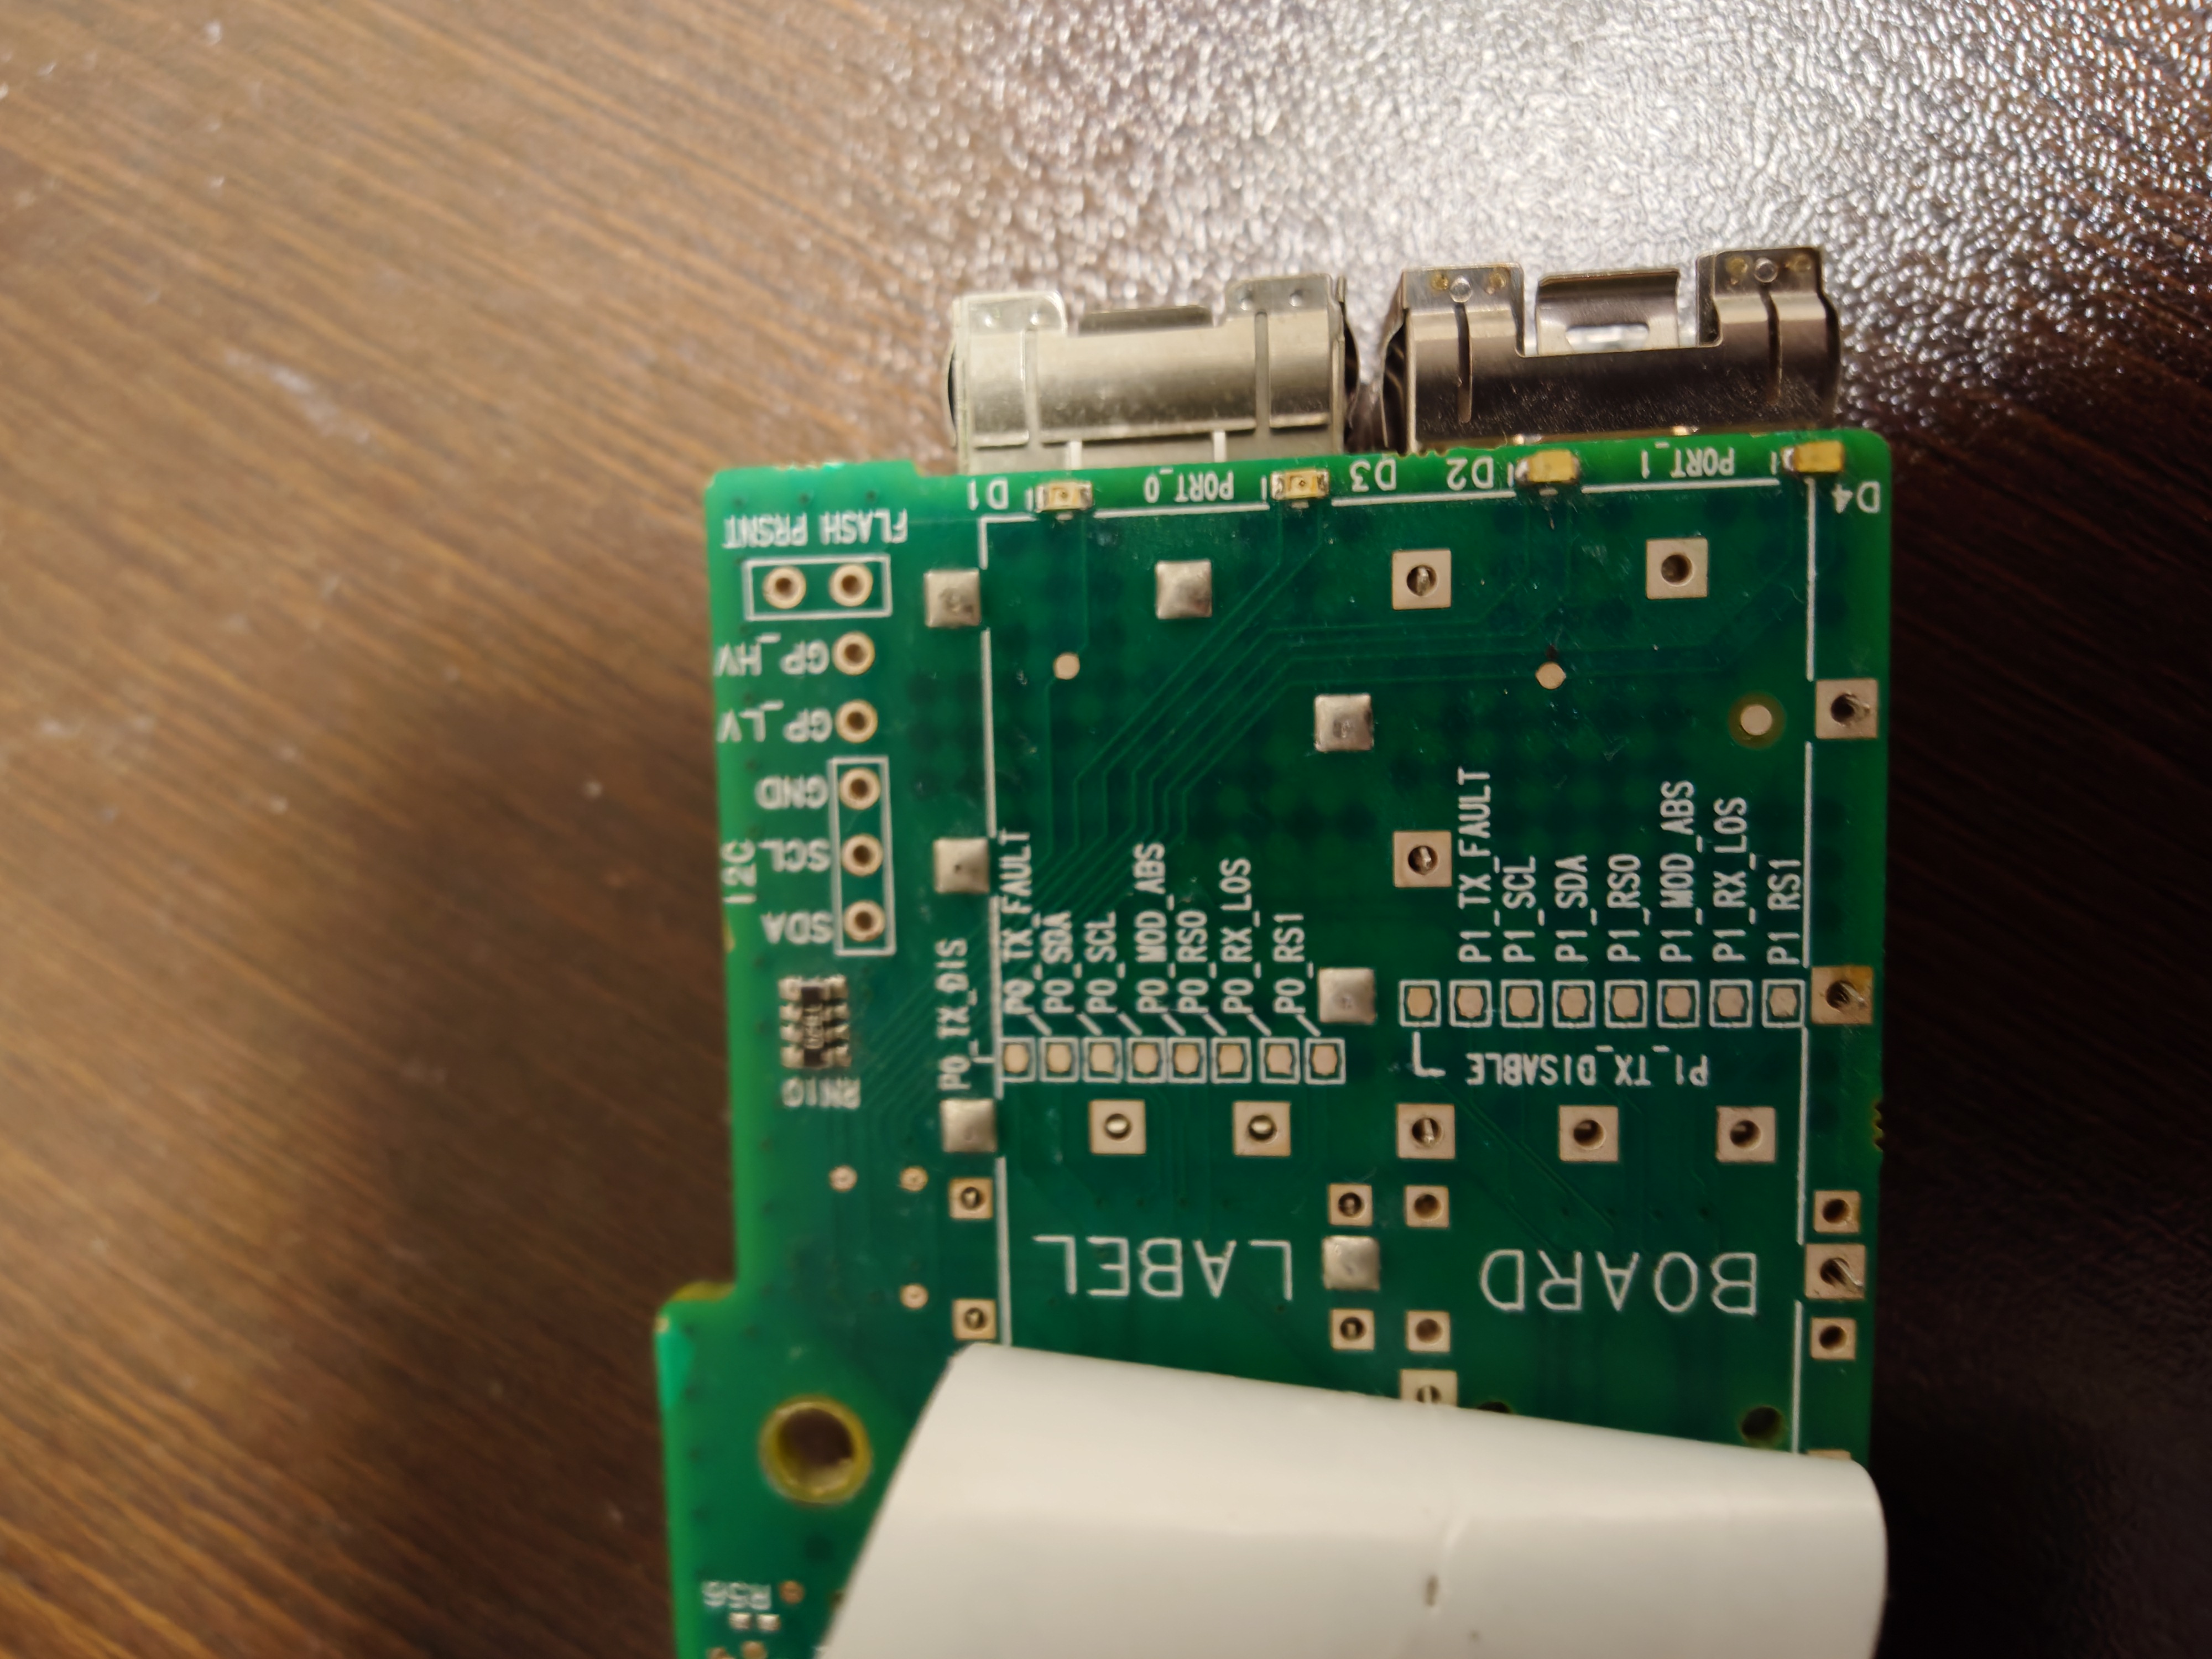
以前使っていたPCB000620は元々SFP+片ポートモデルで、どうやらR86S U1では2ポートに改造していたようだ。
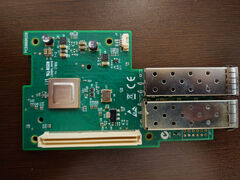
その影響なのか明らかに片方だけソケットの形が異なる。上側のほうが綺麗で、下側は使いこまれているのか、ややぼろ目に見える。
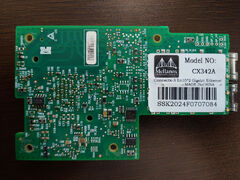
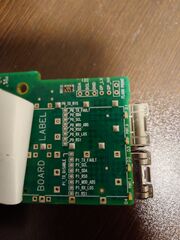
裏面を見ると片方ははんだ付けされているが、片方は差し込んであるだけ。シールも一度剥がしたものを貼り付けているのか、ペラペラしていてすぐに剥がせた。

おそらく上側(PORT 0)のはんだ付けされていた方が本来のソケットで、後から付けたやつ、つまり下側(PORT 1)が差し込んだだけの奴と思われる。

本来のソケットがぼろい方、後付けのが綺麗な方である。
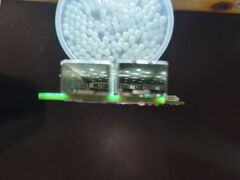
奥の方の作りも異なる。左がPORT 0、右がPORT 1。

R86S U1のNICについているSFP+ポートの片方が不安定だった話で不安定だったのはPORT 1の方なので、改造して無理に取り付けていた方が不具合を発していたのだろう。本来できないことをしているので無理もない。
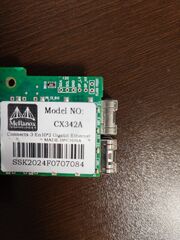
裏面の形も異なる。

恐らくよくある片ポートの奴にソケットを増設したのだと思う。
ソケットが片ポートしかなくても回路が実装されていることはよくあるので、この回路を流用しているのだと思う。回路もあるし、チップも恐らく同じなので原理的には問題なく動きそうに思える。

R86S U1のSFP+を使い始めたのは2025年の9月17日からだった[1]が、同年12月13日にはリンクアップとリンクダウンが繰り返される事象を確認していて、同年12月25日にSFP+差し込みポートの変更を行ってからは一度も起きていない。

この時の気温が落ちたので金属製のSFP+ソケットの接触不良になったのではないか?と考えていたが、恐らくソケットではなく、基板本体との接触が寒暖差でダメになったのかもしれない。実際、先ほどの写真を見ても基板の穴からピンが出たり出ていなかったりするので、寒暖差でここが僅かに狂った結果、基板と接触不良になり、回路がチャタリングした結果、リンクアップとリンクダウンをミリ秒単位で繰り返す状態が起きていたのかもしれない。

もし、この理屈が正しければ強く押し込んではんだ付けすれば改善しそうではある。
あとがき

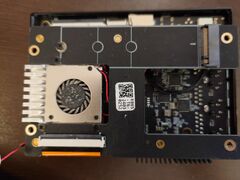
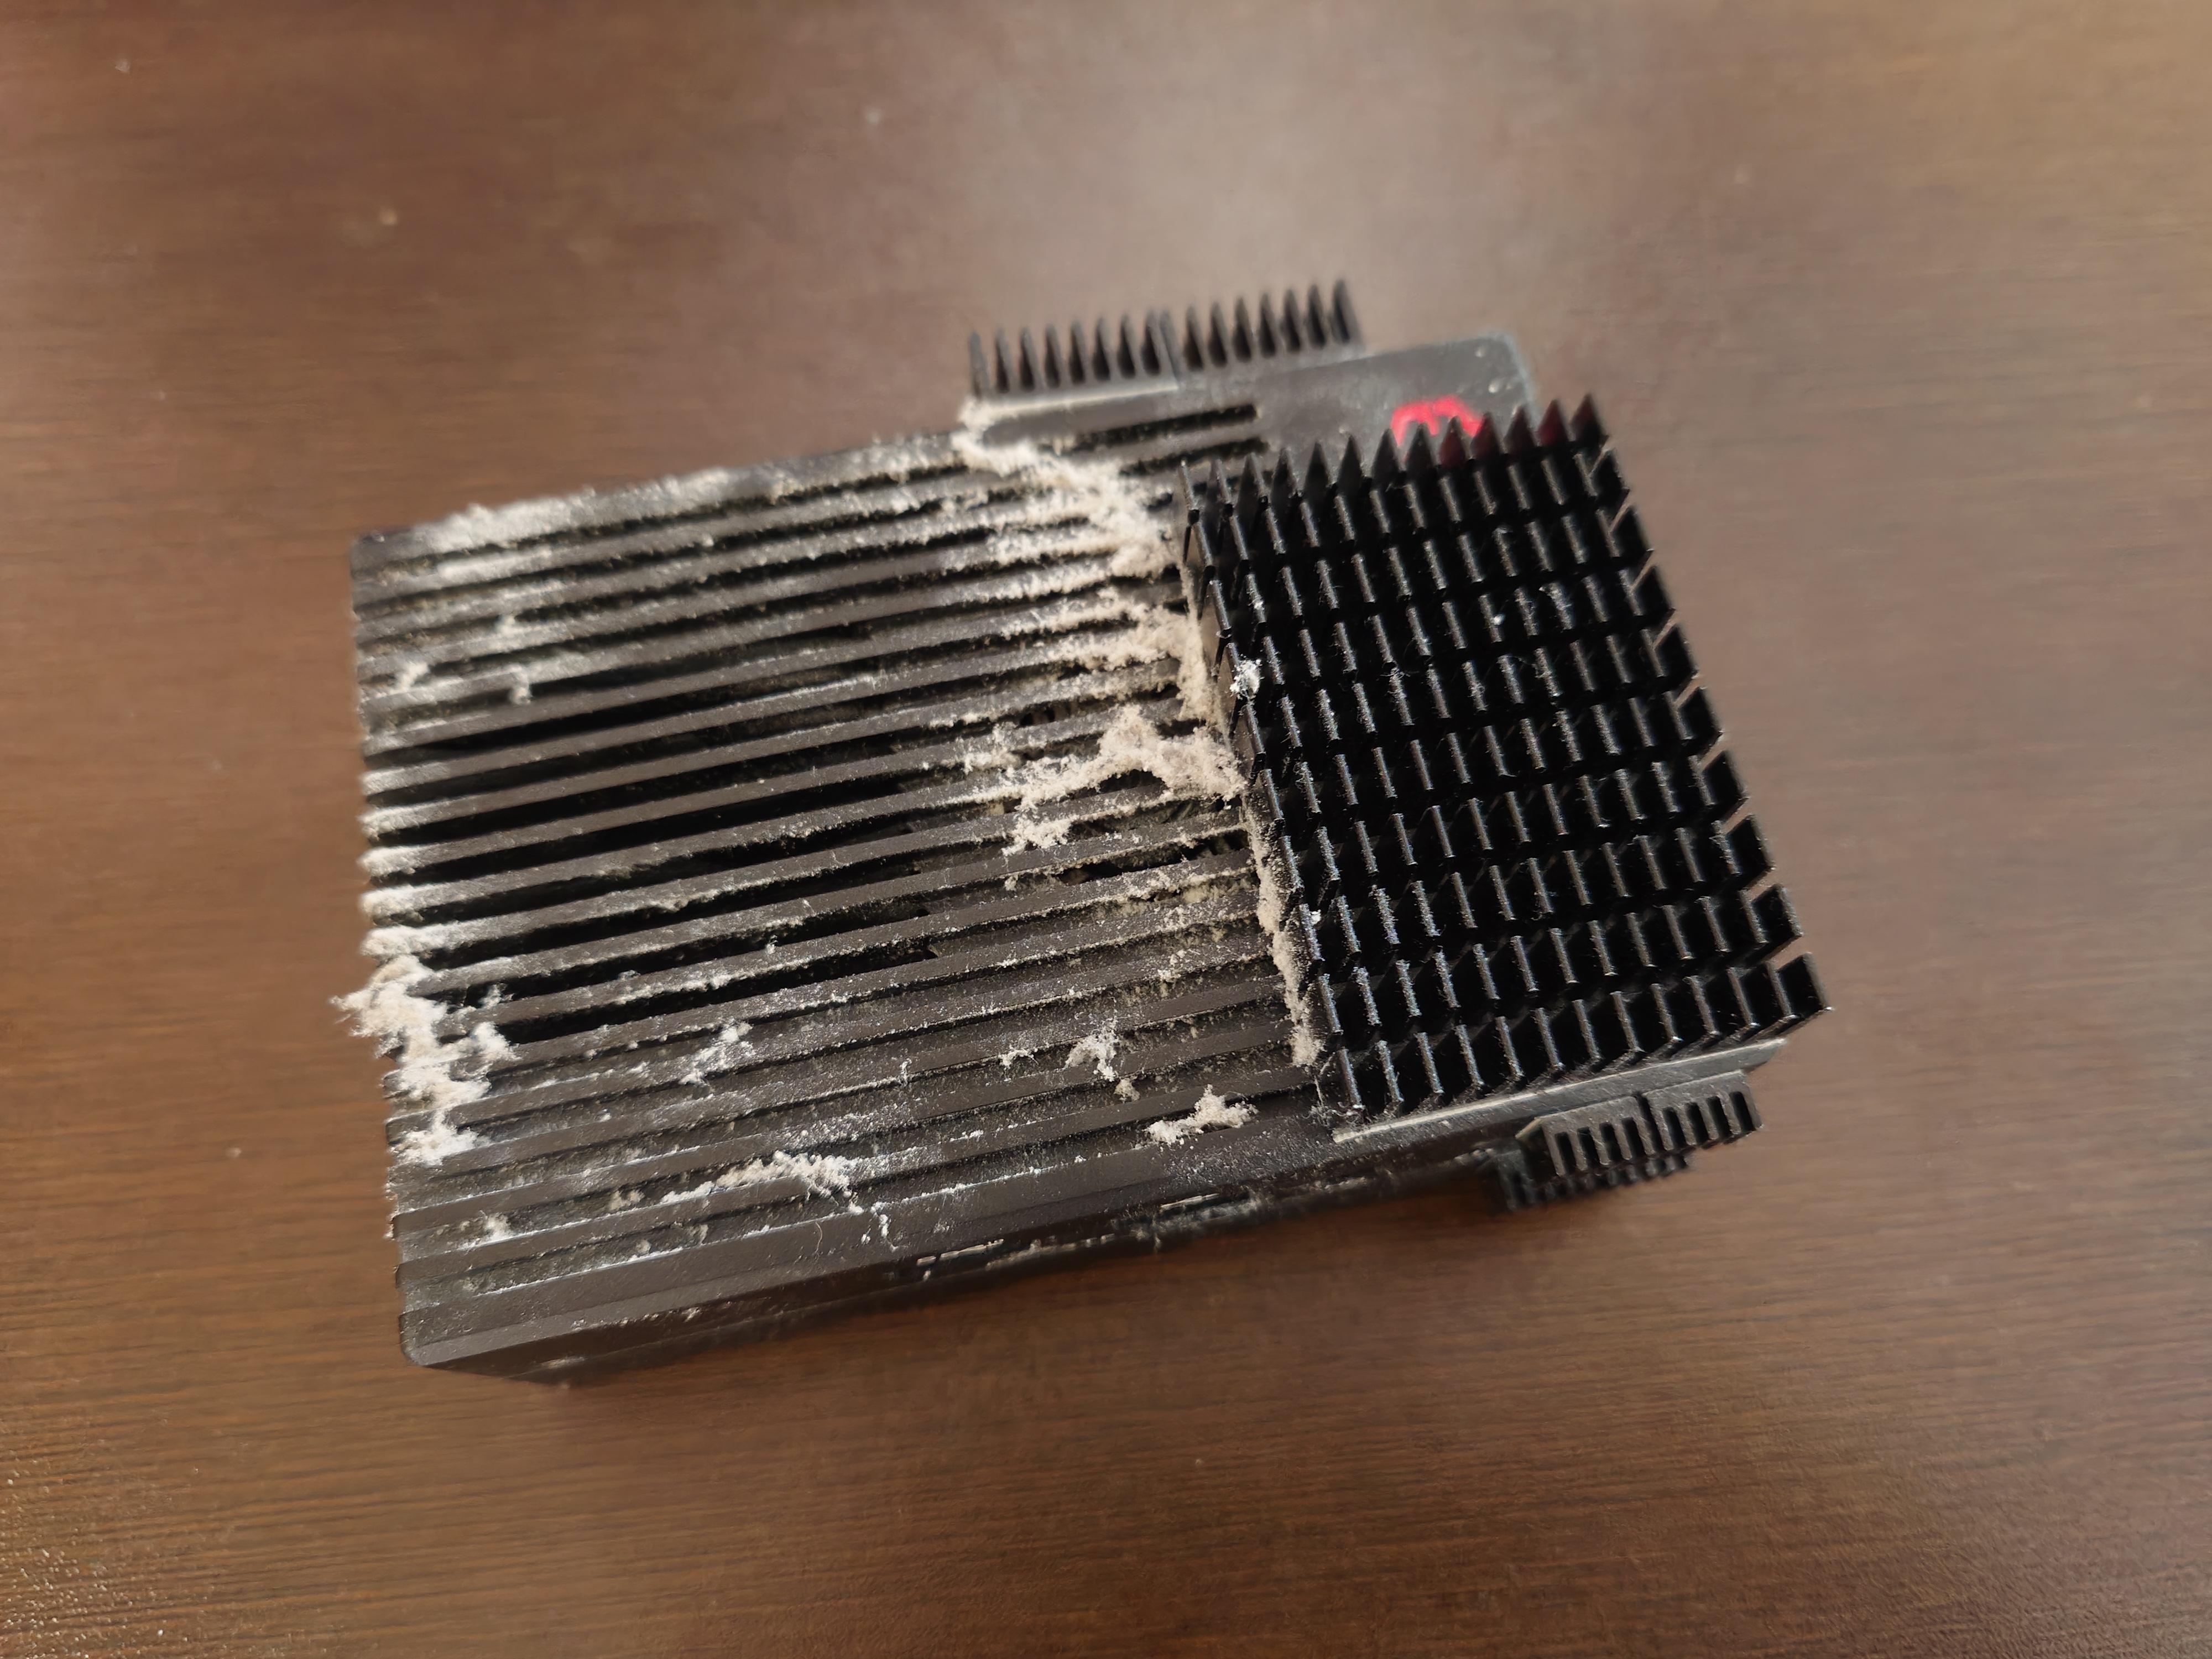
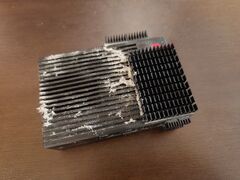
NIC交換の時に取り出した時、酷い埃まみれになっていたのでいい加減、冷却面をどうにかしたい気がしている。
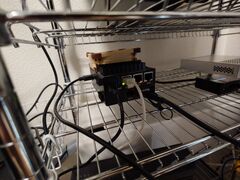
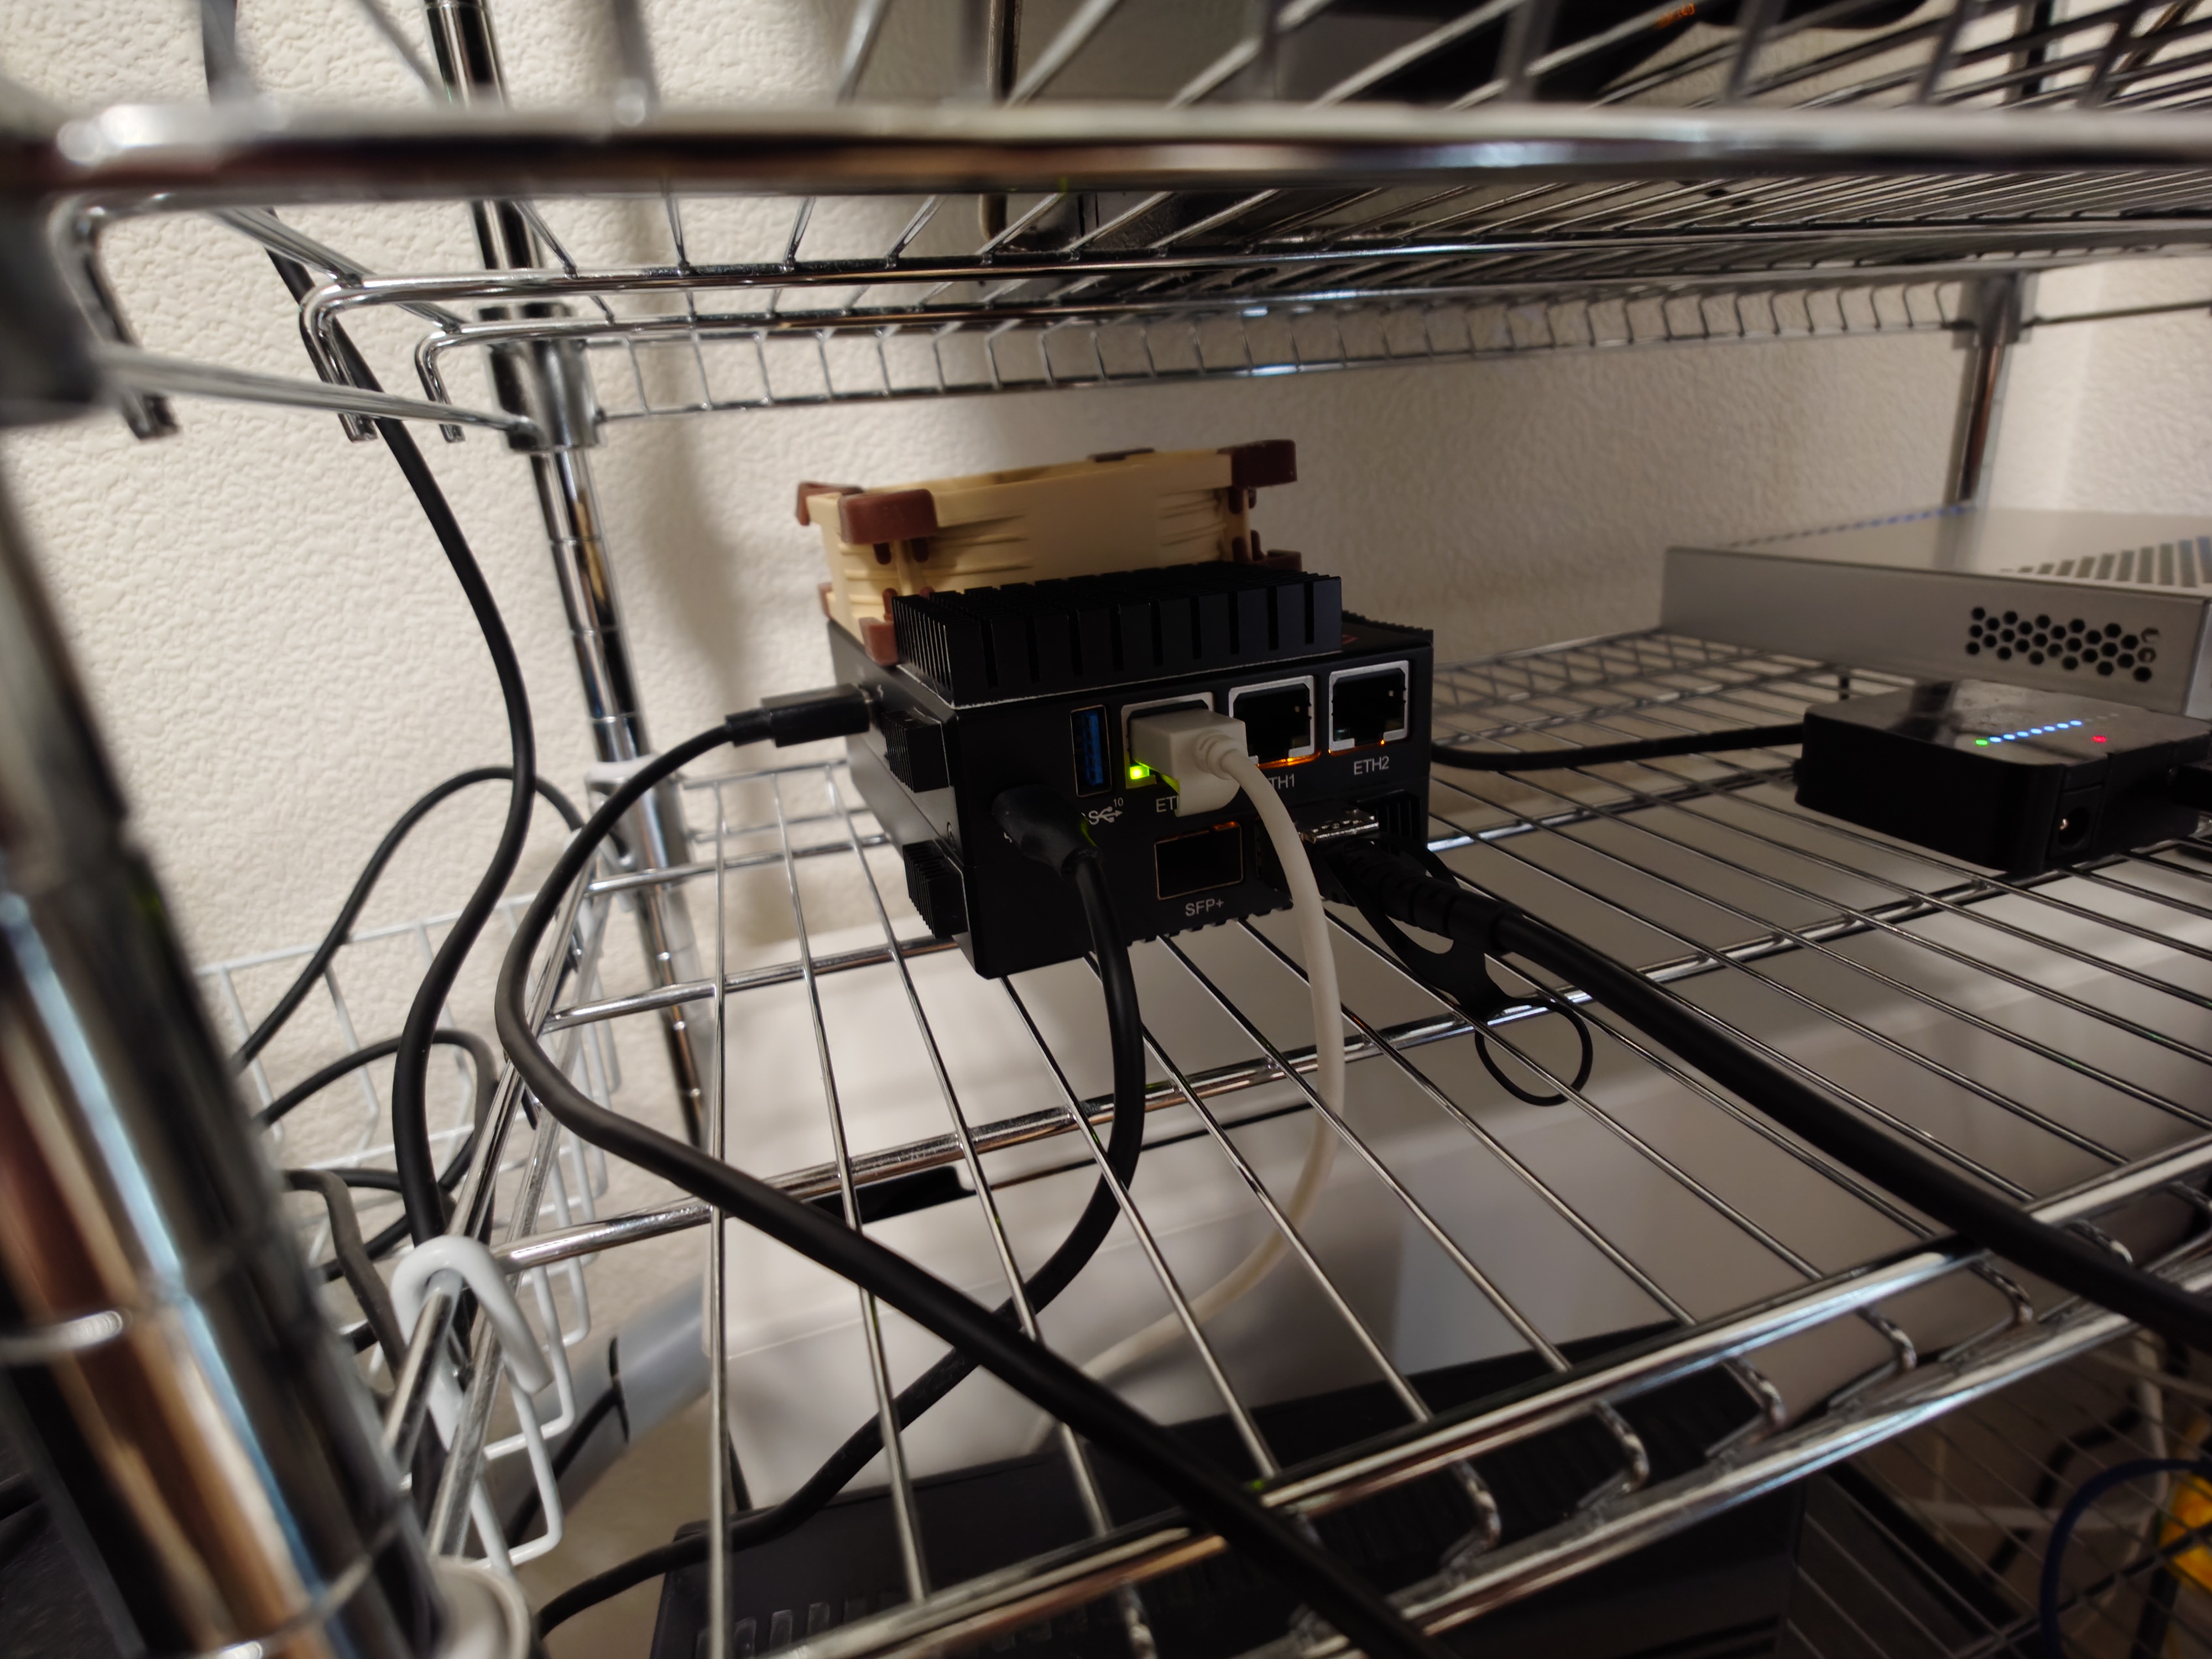
普段は上に80mm角ファンを載せて運用しているため、埃の元凶はこれである。一旦はファンフィルターを買ってその場を凌ぎたいところだが、本質的にはちゃんとしたケースに収めてちゃんとしたクーラーをつけるのが最良だと思っている。

R86S U1を冷やそうとした作業の残渣にも書いているが、R86S U1の冷却機構は耐久性があるように見えず、また大して冷やしてもくれない。上にファンを載せて風を入れていると、いつの日か中が埃まみれになってしまうし、このケースはメンテナンス性が良くないので清掃も面倒だ。
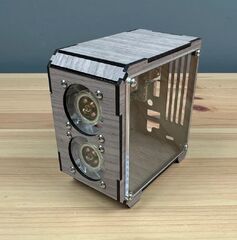
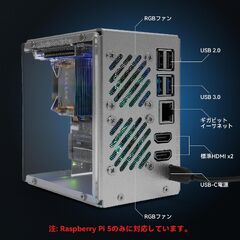
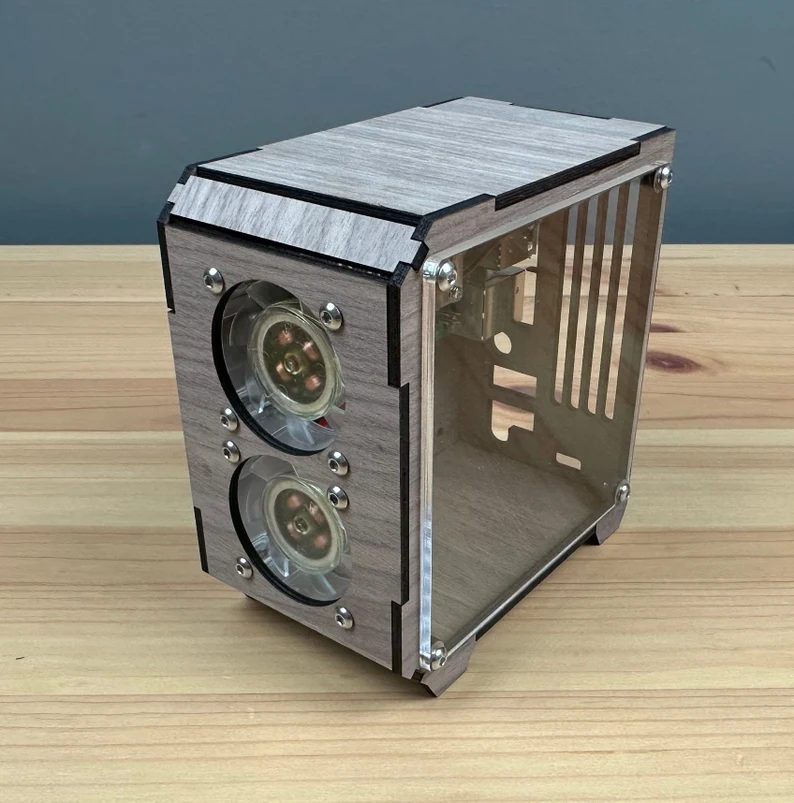
理想論としてはこんな感じのケースに組み込めればよいだろう。これならメンテナンスがしやすいし、NICのヒートシンクも元の奴が生かせそうだ。ファンも40mm角ファンだろうから壊れても交換が容易である。

まぁこれは行き過ぎとしても、ラズパイのタワークーラーを載せるとか、そういうのができるとよいなとは思っている。基板むき出しは埃が溜まってショートしそうなので、ケースもあった方がいいだろう。

ただそれをどう実現するかが難しいところで、まず本来的には3D CADでケースやCPUクーラーをモデリングし、CNCで金属を削るという工程が必要だろうが、そんなものはないし、仮に3Dプリンタである程度何とかするにしても、3D CADの使い方を学ぶところからだと気が遠くなる話で、なかなか難しい…。

そもそもノギスで測っても測るたびに数ミリ単位の誤差が出るので、アナログな図面を書くことすら困難だ(多分ノギスの角度が微妙に毎回ズレてる)

こんなことであれば去年アリエクのセールでファンレスのR86SであるR86S-FLN100を買っておけばよかった。今は22.7万もするが、去年は11万くらいで、セールでは9万にまで落ちていて、買いだった。まぁあとからは何とでも言えるし、そもそも9万でも安くないわけで、言ったところで仕方がない。

現実案としては厚紙にボードを固定して外枠をペンで引き、ネジ穴については基板のネジ穴スレスレの何かを差し込んでマーキングすればそれなりに正確なものが取れるだろうから、一度手書きで図面を書き、それを基にアクリル板を加工し、簡単なケースを作るのが一段階目としてはよさそうな気がする。

ただCPUクーラーをどうするかという問題が根深く、ここが難点になると思う…。これはCPUクーラーを作るにはCPUのヒートスプレッダに乗ってくれるヒートシンクを持ったファンと、そのファンと基板のネジ穴を繋ぐ足が必要になるからだ。ヒートシンクと基板のネジ穴がマッチしないとならないので、恐らくこれが一番の難関だろう…。

たぶん厚紙→アクリル板がいければ図面を起こせるので、カスタムアルミケース業者に発注すれば、きちんとしたものも作れると思う。そこまでやるかどうかは未定だが…w

  1. 宅内に10GbE環境を導入してみたの写真のタイムスタンプから推定。 ↩

2026/05/19(火)ローカルでQwen3.6-35B-A3Bをベンチしてみた

更新日:
投稿日:

前回のマシンを更新したのでローカルLLMを軽くベンチマークしてみたでは生成速度だけを見れば十分実用ラインということを確認したが、品質が悪い問題があった。

そこで4月に出て、そこそこ評判を聞くQwen3.6がいかほどのものかというのを軽く試し、ついでにベンチマークもした。

CPU推論とGPU推論が分かれているが、これは初回ベンチマーク時にCUDAのDLLを入れ忘れていたため、GPU推論はDLLを入れてリトライした時の数値、CPU推論はDLLがない状態の数値で書いている。

確認環境

ハードウェア

種別 デバイス
CPU Intel Core Ultra 7 265F
GPU GeForce RTX 5070 Ti
MEM Crucial CT2K16G56C46U5(DDR5-5600 16GB) * 4
M/B ASRock Z890 Pro RS

ソフトウェア

実行環境はWindows 11。今回はllama.cppをメインで使っている。

Env Ver
llama.cpp 9196
Ollama 0.24.0
Open WebUI 0.9.5

ベンチ結果

[llama.cpp] Qwen3.6-35B-A3B-UD-Q4_K_M

Qwen3.6-35B-A3B-UD-Q4_K_Mを使用。

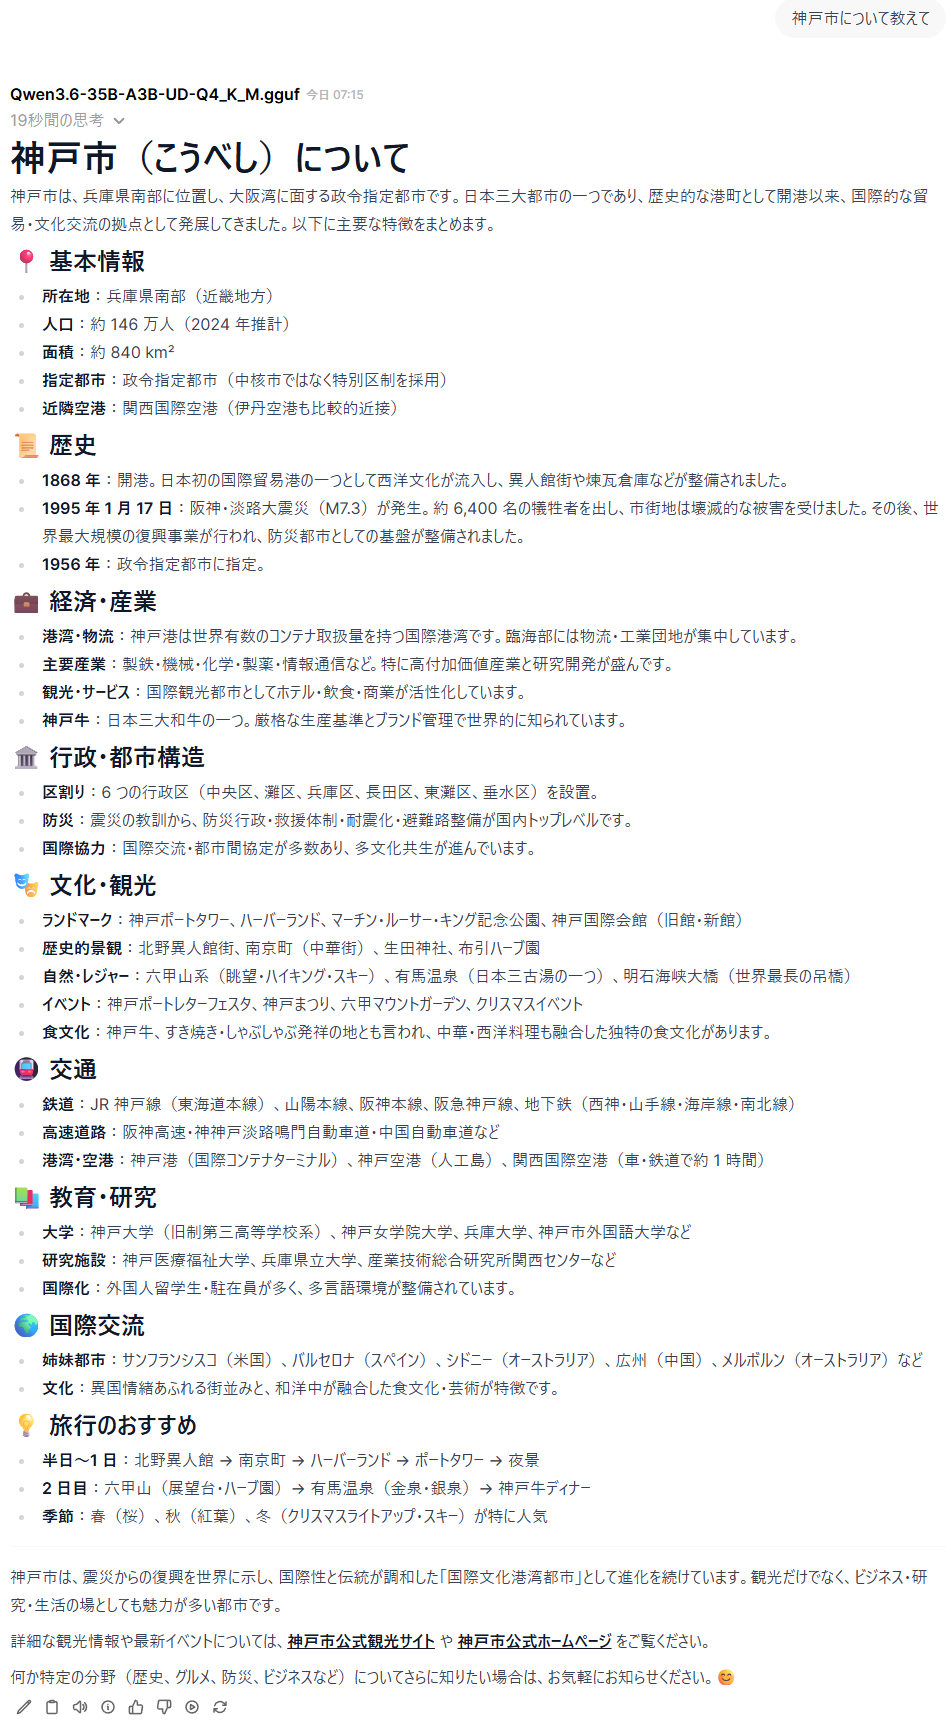
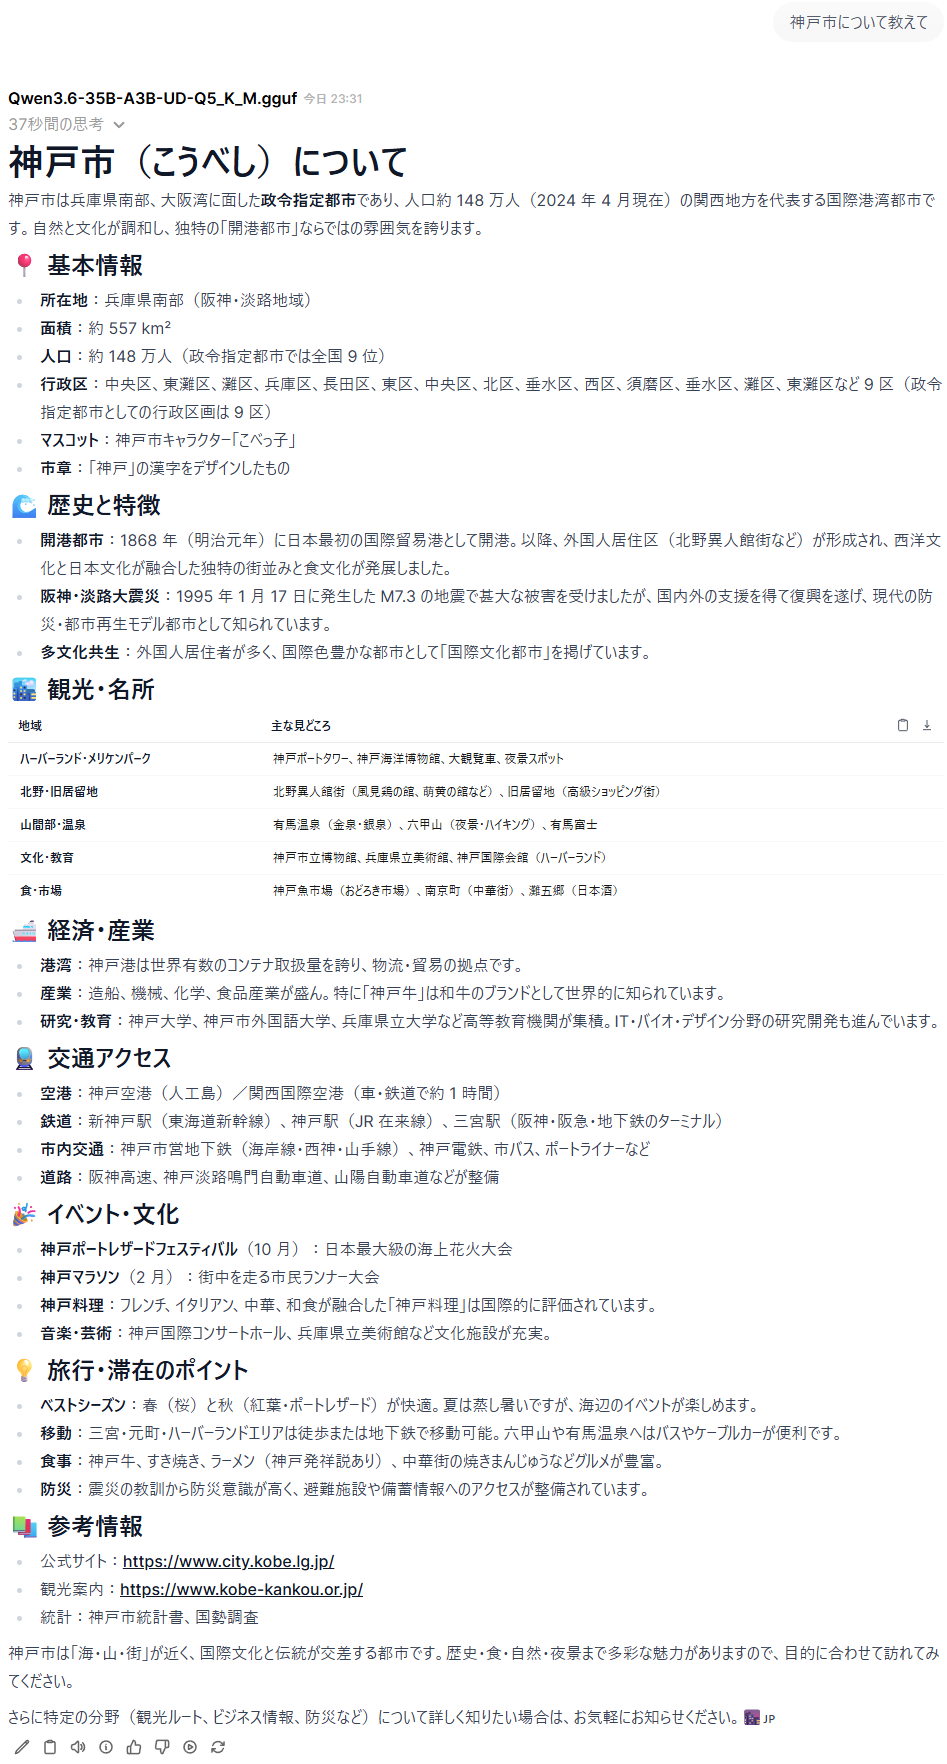
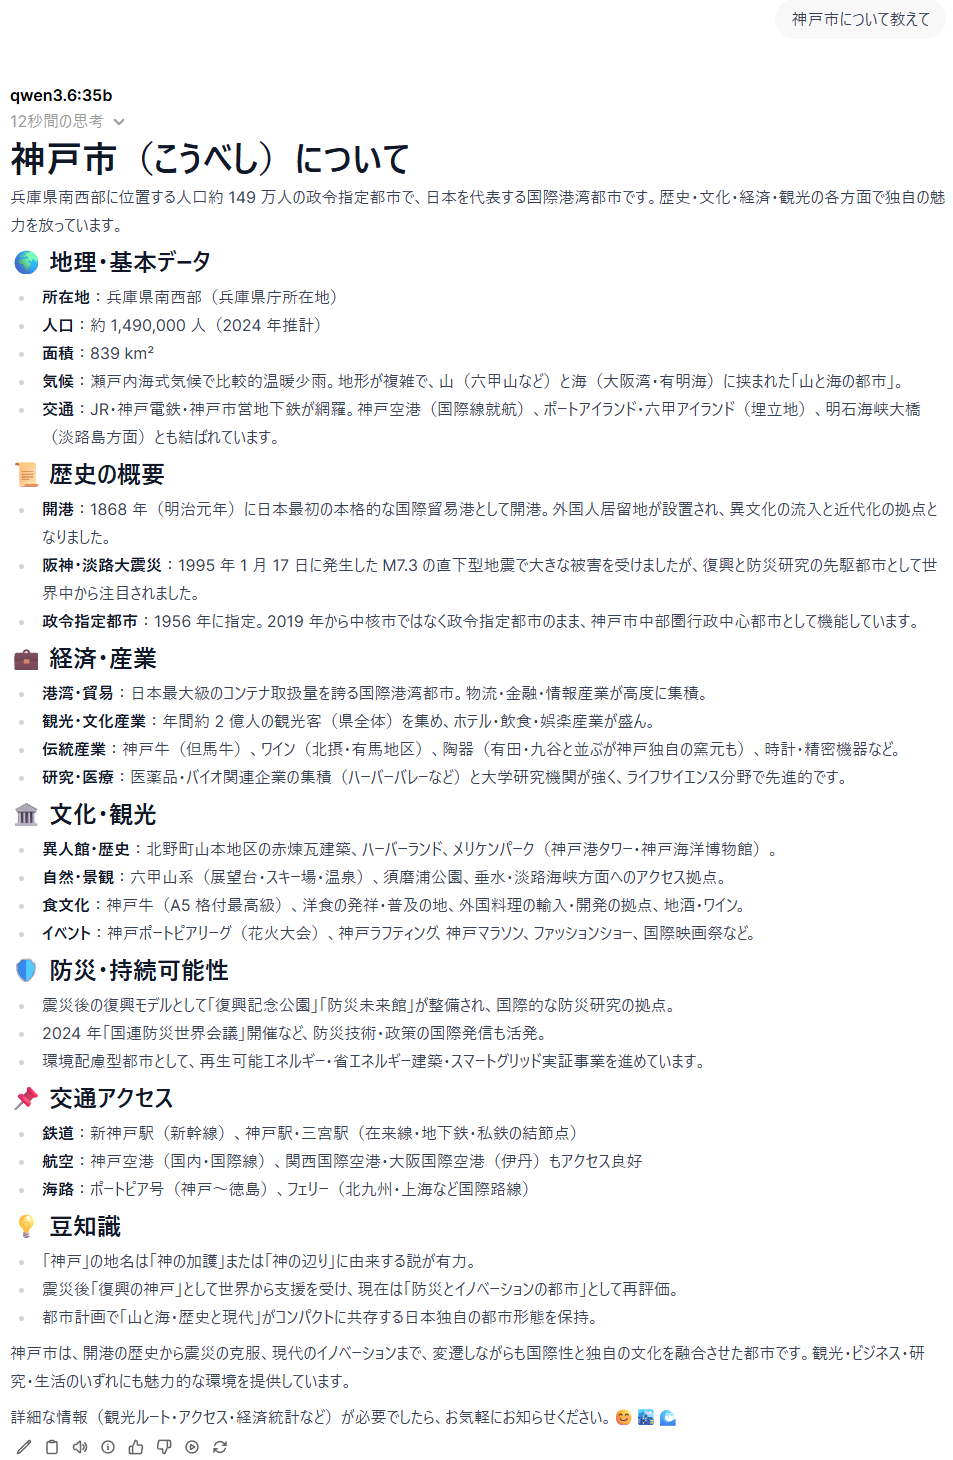
入出力例

CPU推論時に出した内容。スクショが面倒なのでGPU推論時のはなし

CPU推論

生成速度

指標 値
cache_n 0
prompt_n 14
prompt_ms 203.404
prompt_per_token_ms 14.528857142857143
prompt_per_second 68.82853827849993
predicted_n 1553
predicted_ms 94147.172
predicted_per_token_ms 60.622776561493886
predicted_per_second 16.495450335990974
input_tokens 14
output_tokens 1553
total_tokens 1567

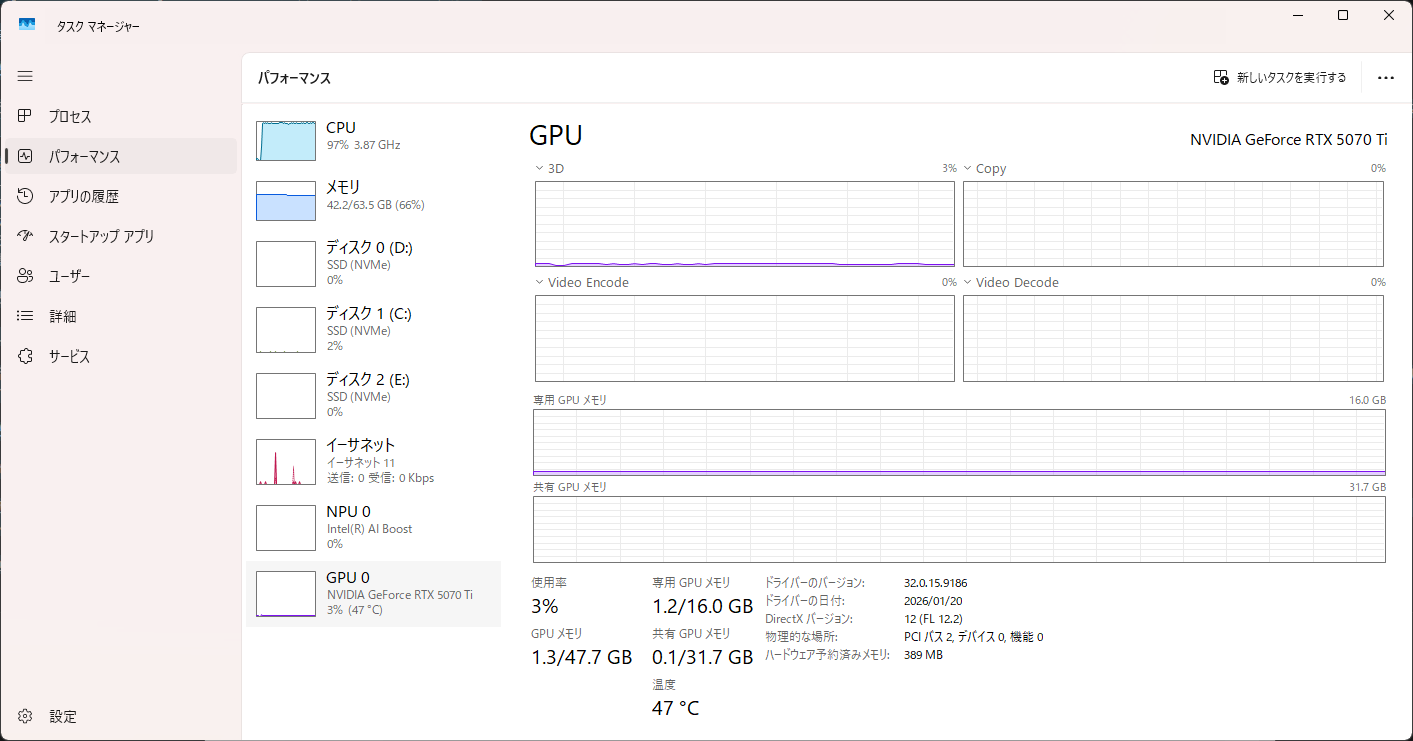
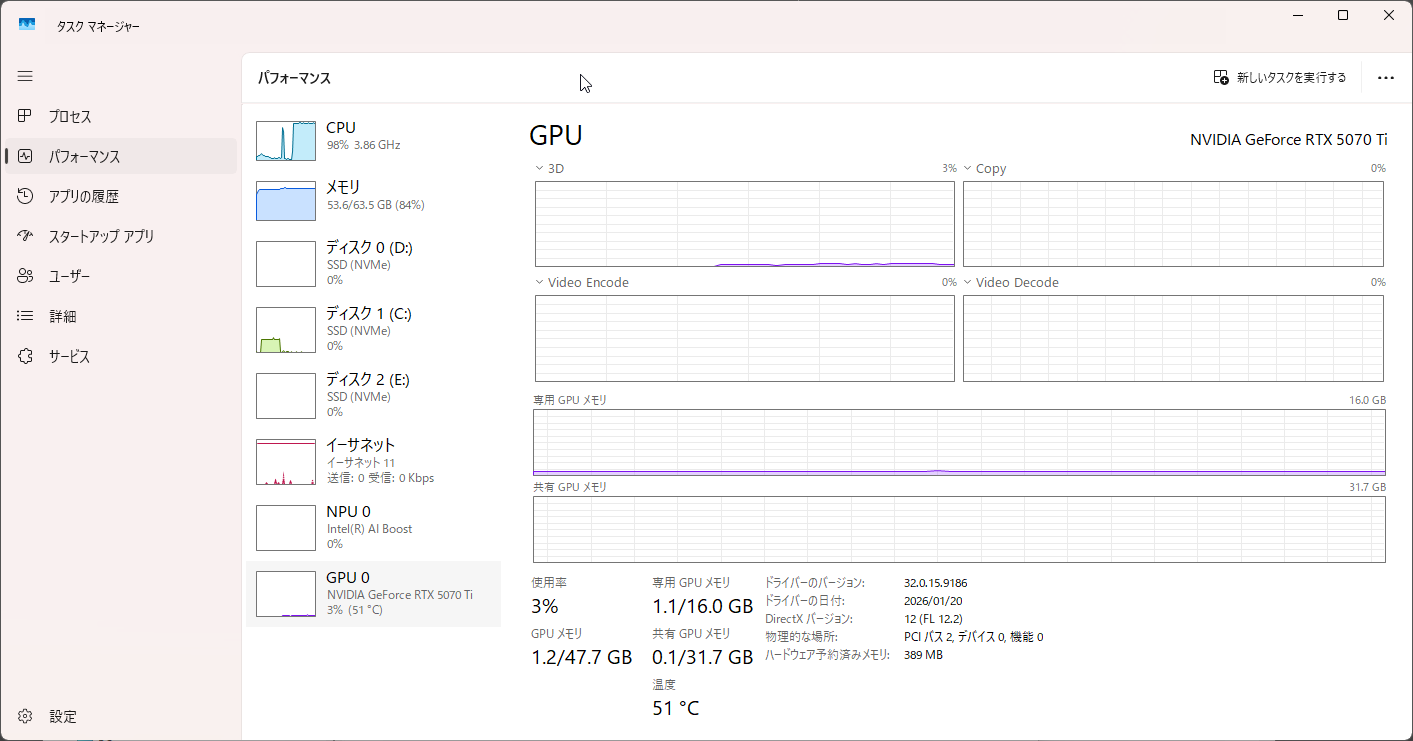
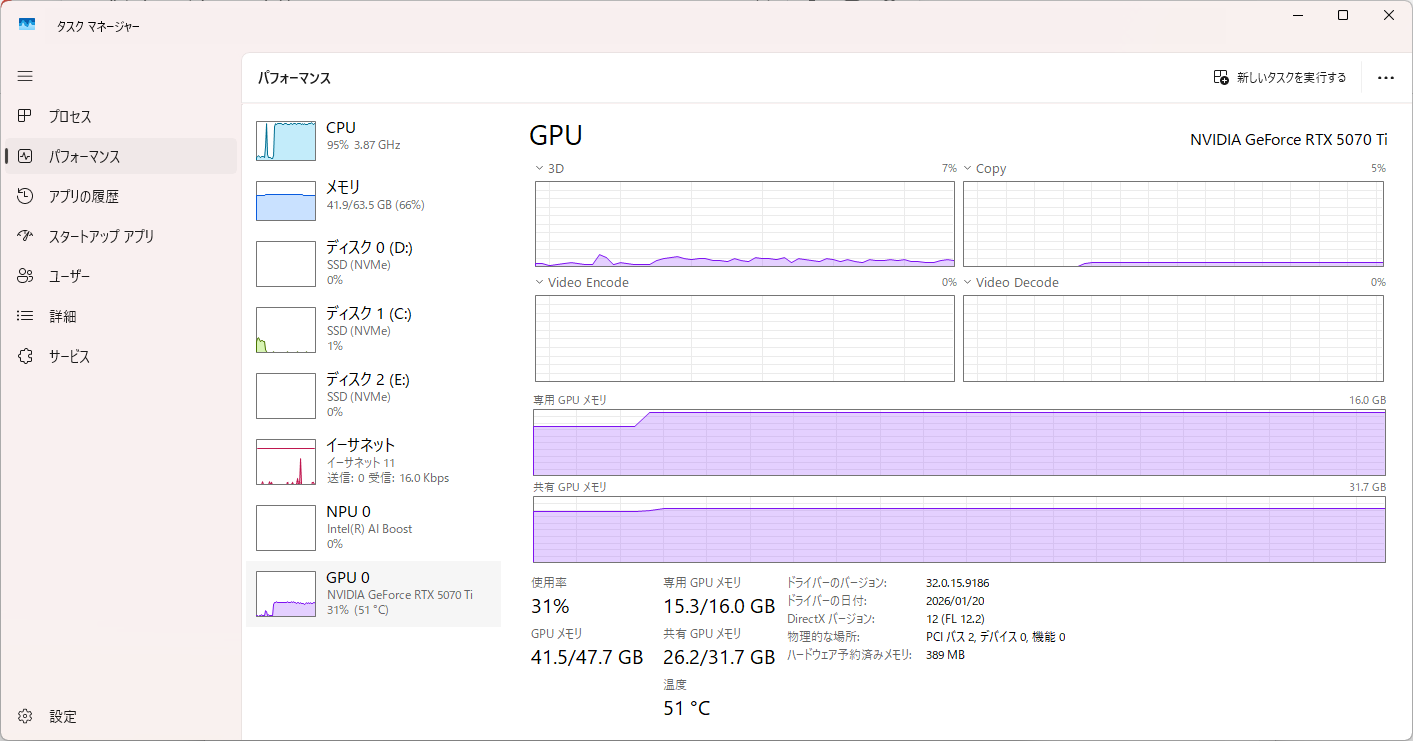
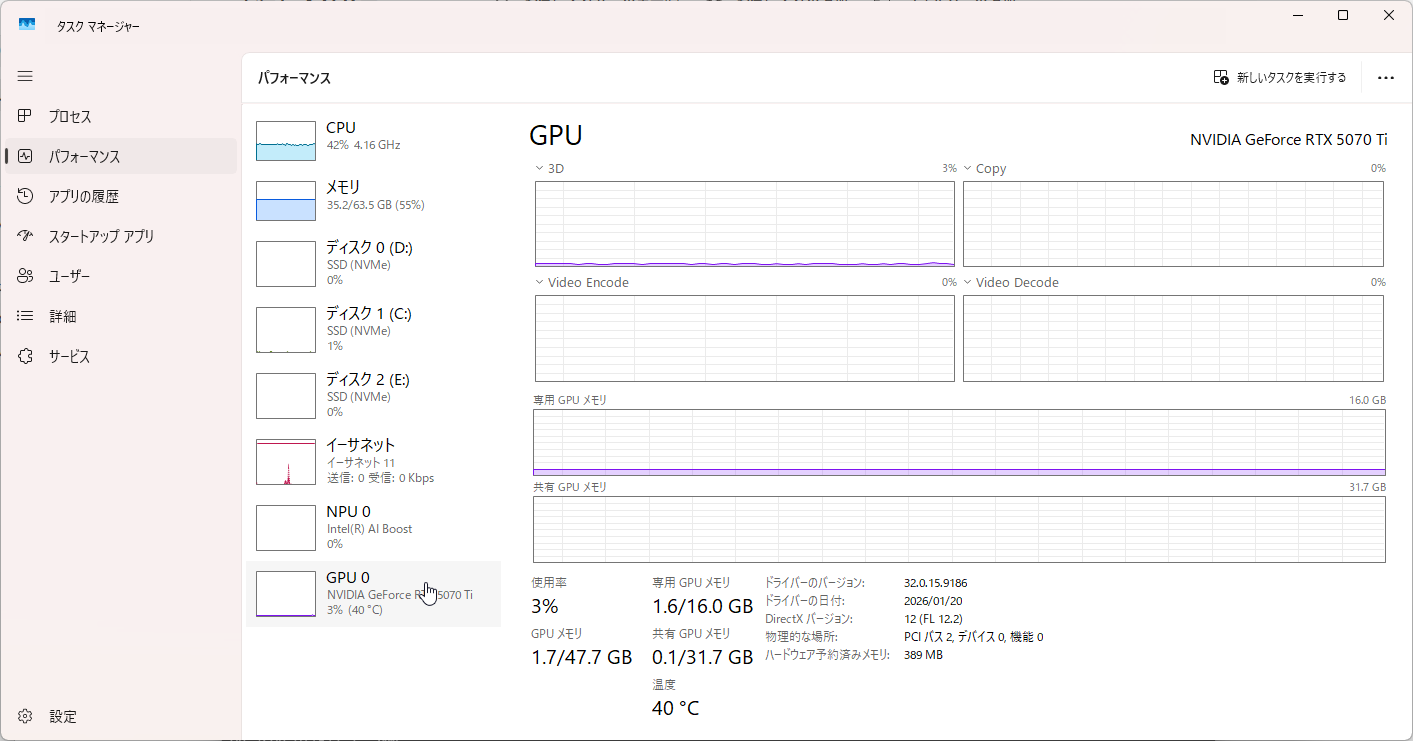
リソース消費

GPU推論

生成速度

指標 値
cache_n 0
prompt_n 14
prompt_ms 103.612
prompt_per_token_ms 7.400857142857142
prompt_per_second 135.11948422962593
predicted_n 1554
predicted_ms 26037.862
predicted_per_token_ms 16.755380952380953
predicted_per_second 59.68231953913881
input_tokens 14
output_tokens 1554
total_tokens 1568

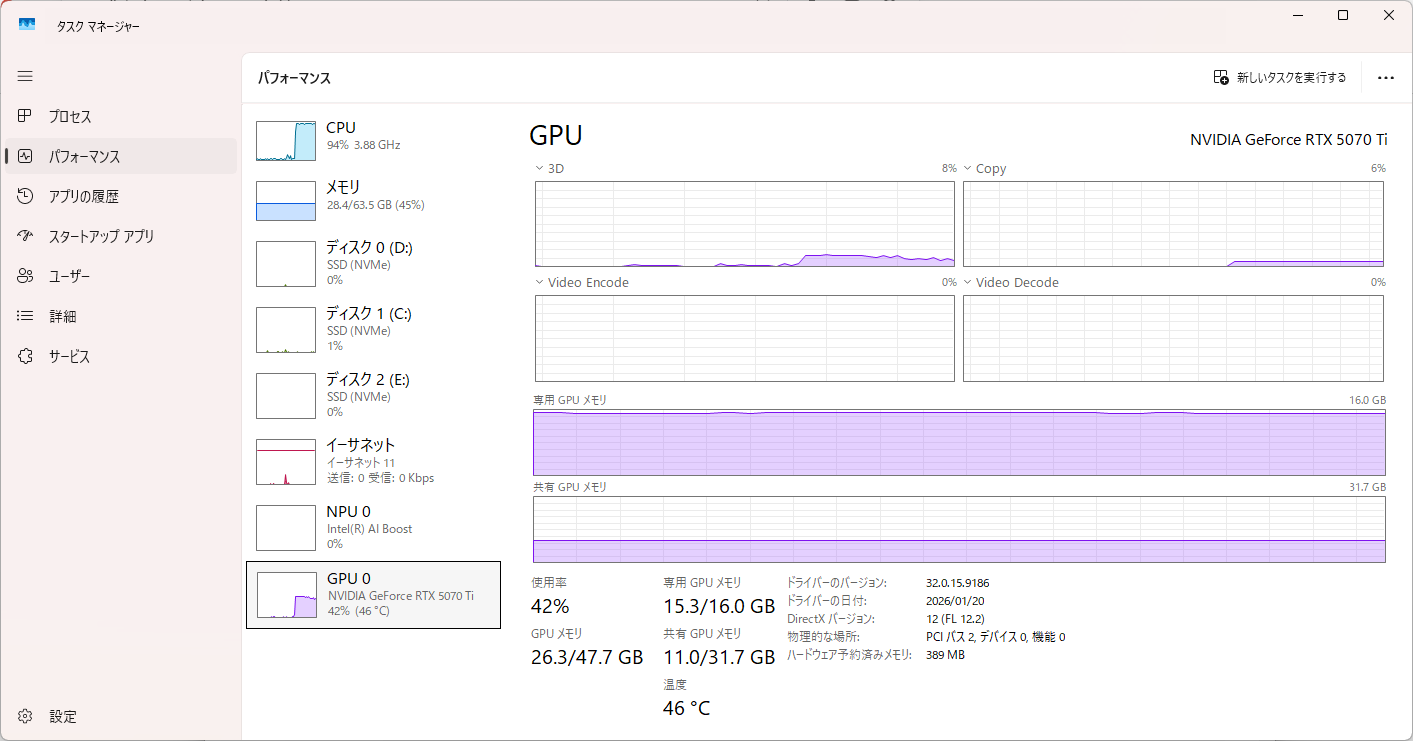
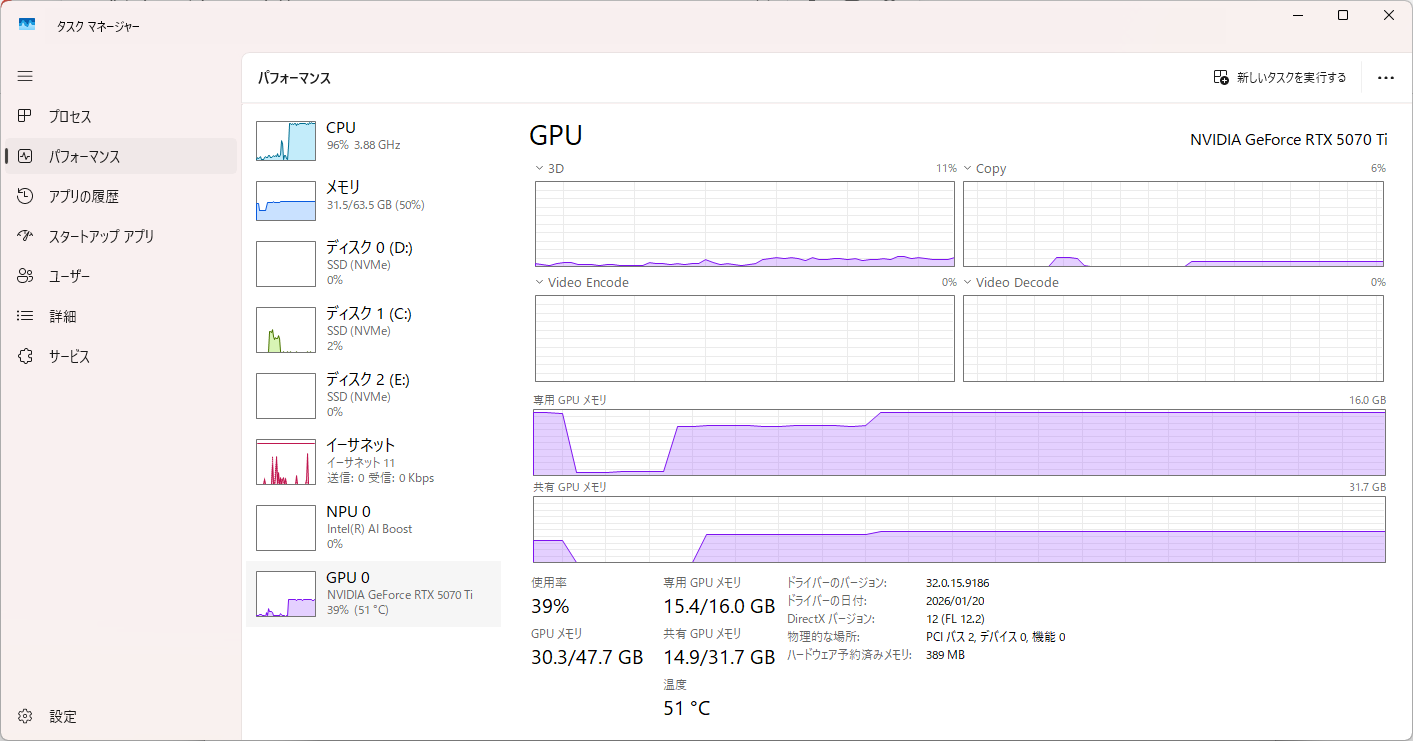
リソース消費

[llama.cpp] Qwen3.6-35B-A3B-UD-Q5_K_M

Qwen3.6-35B-A3B-UD-Q5_K_Mを使用。

入出力例

CPU推論時に出した内容。スクショが面倒なのでGPU推論時のはなし

CPU推論

生成速度

指標 値
cache_n 0
prompt_n 14
prompt_ms 228.782
prompt_per_token_ms 16.34157142857143
prompt_per_second 61.19362537262546
predicted_n 1816
predicted_ms 119116.155
predicted_per_token_ms 65.59259636563877
predicted_per_second 15.24562306431063
input_tokens 14
output_tokens 1816
total_tokens 1830

リソース消費

GPU推論

生成速度

指標 値
cache_n 0
prompt_n 14
prompt_ms 156.28
prompt_per_token_ms 11.162857142857144
prompt_per_second 89.58280010238033
predicted_n 1575
predicted_ms 30901.59
predicted_per_token_ms 19.620057142857142
predicted_per_second 50.96825114824189
input_tokens 14
output_tokens 1575
total_tokens 1589

リソース消費

[llama.cpp] Qwen3.6-35B-A3B-UD-Q8_K_XL

Qwen3.6-35B-A3B-UD-Q8_K_XLを使用。

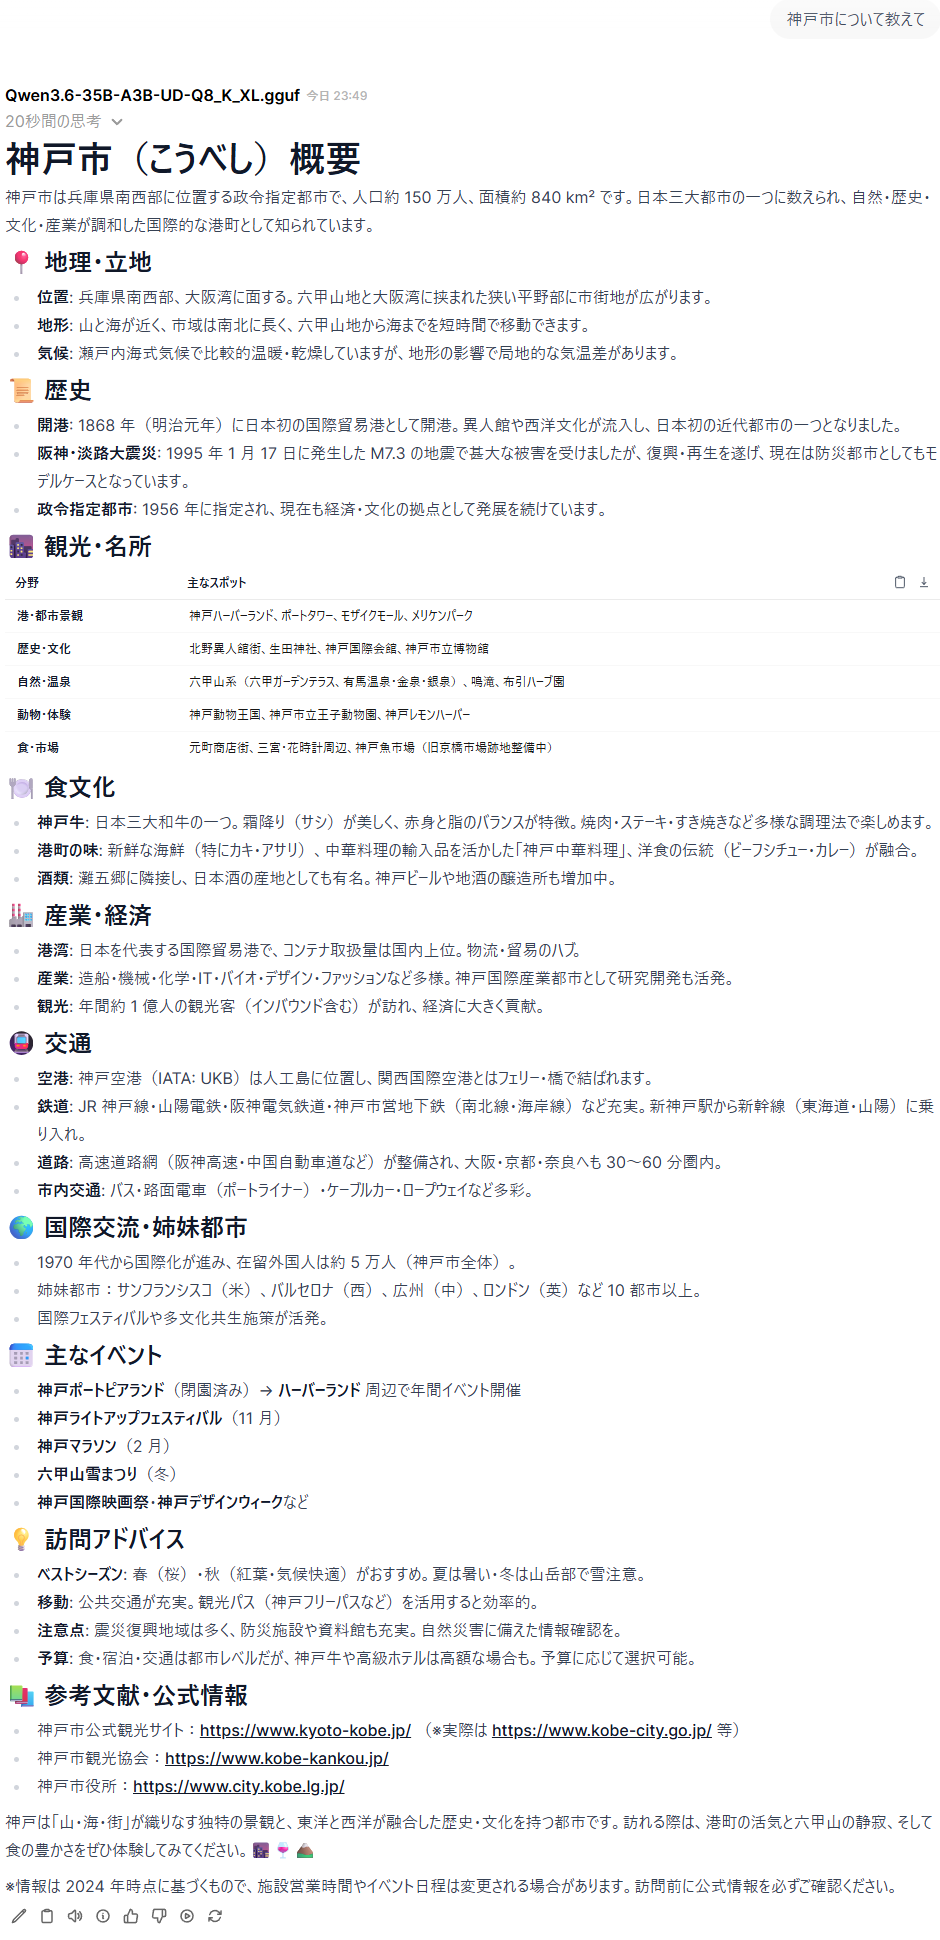
入出力例

CPU推論時に出した内容。スクショが面倒なのでGPU推論時のはなし

CPU推論

生成速度

指標 値
cache_n 0
prompt_n 14
prompt_ms 262.85
prompt_per_token_ms 18.775000000000002
prompt_per_second 53.262316910785614
predicted_n 1704
predicted_ms 119261.701
predicted_per_token_ms 69.98926115023474
predicted_per_second 14.287906223977135
input_tokens 14
output_tokens 1704
total_tokens 1718

リソース消費

GPU推論

生成速度

指標 値
cache_n 0
prompt_n 14
prompt_ms 190.329
prompt_per_token_ms 13.594928571428571
prompt_per_second 73.55684104892055
predicted_n 1829
predicted_ms 51098.747
predicted_per_token_ms 27.93807927829415
predicted_per_second 35.7934412755757
input_tokens 14
output_tokens 1829
total_tokens 1843

リソース消費

[Ollama] qwen3.6:35b

qwen3.6:35bを使用

入出力例

CPU推論時に出した内容。スクショが面倒なのでGPU推論時のはなし

CPU推論

生成速度

指標 値
input_tokens 14
output_tokens 1364
total_tokens 1378
prompt_tokens 14
completion_tokens 1364
response_token/s 20.84
prompt_token/s 5.84
total_duration 126876747900
load_duration 58586625500
prompt_eval_count 14
prompt_eval_duration 2398703000
eval_count 1364
eval_duration 65458229300
approximate_total "0h2m6s"

リソース消費

llama.cpp実行コマンド

実行コマンド

このコマンドはRTX 5070 Ti + 9800X3D running Qwen3.6-35B-A3B at 79 t/s with 128K context, the --n-cpu-moe flag is the most important part. |r/LocalLLaMAにあったものを利用している。

llama-server.exe ^
  -m "ここにモデルファイルのパス" ^
  --fit on ^
  --fit-ctx 128000 ^
  --fit-target 256 ^
  -np 1 ^
  -fa on ^
  --no-mmap ^
  --mlock ^
  -b 2048 ^
  -ub 2048 ^
  -ctk q8_0 ^
  -ctv q8_0 ^
  --temp 0.6 ^
  --top-p 0.95 ^
  --top-k 20 ^
  --min-p 0.0 ^
  --presence-penalty 0.0 ^
  --repeat-penalty 1.0 ^
  --reasoning-budget -1 ^
  --chat-template-kwargs "{\"preserve_thinking\": true}" ^
  --host 0.0.0.0 ^
  --port 8033

まとめ

CPU

指標 Q4_K_M Q5_K_M Q8_K_XL
入力tok/s 68.82 61.19 53.26
出力tok/s 16.49 15.24 14.28

GPU

指標 Q4_K_M Q5_K_M Q8_K_XL
入力tok/s 135.11 89.58 73.55
出力tok/s 59.68 50.96 35.79

Ollama

指標 Ollama
入力tok/s 5.84
出力tok/s 20.84

上の表の指標については明確な根拠を見つけることができなかったため、指標の名前から推測して、おそらくこの指標はこれだろうというので割り当てて書いている。

何故というとAPIレスポンスの仕様書が何処にあるかわからず、Claude Opus 4.7に聞いてもデッドリンクになった仕様書を提示され、後はソースコードを読めと言われたため、わからないのだ。ソースコードなんか一々読んでられない。しかも嘘を教えられたため、自力で解釈した。

さて、処理時間についてだが、これはOllamaよりllama.cppのほうが圧倒的に早いことが判明した。また、ついでに言うとOllamaはどのモデルを実行してるのかが不明なため、単純比較ができない。

またリソース消費を見る感じ、OllamaはCPU・GPU共に遊ばせていたので、これが処理が遅い原因になっていた可能性がある。llama.cppはマニュアルでそのあたりをうまくやっているので早かったのだろう。

生成品質としては前回とそこまで変わらない気がしたが、質問を一回投げているだけなので、正直なところちゃんとした品質を確かめるには叩きまくる必要はあると思う。面倒なのでそこまではしてない。

おまけ:Poe上のQwen3.6-Plus

Qwen3.6-Plusはクラウド専用モデルのため、ローカルでは動かないが、動かしてみた感じ大分品質は良さそうに思った。少なくともローカルモデルのように目立ったハルシネーションは見られない。

あとがき

一般的なマシンで動くローカルLLMは、まだそれなりという感じの次元だが、Qwen3と比べると3.6は気持ち品質が上がったように感じた。とはいってもLLMはコンテキストがある状態で質問したり、コーディングさせたりしないと真価がわからないので、今回のように「神戸市について教えて」と聞くだけではあまり意味のある結果にはならないので、あくまで参考値くらいだろう。

取り敢えずまともなモデルはOpenAIもQwenもクラウドにあって、配布されているモデルは劣化版というのが分かったのが今日の収穫だったように思う。

Qwen公式の比較表を見る限り、Qwen3.6-35B-A3BはClaude Sonnet 4.5よりは賢いようだ。ただSonnetは個人的にはもう使っておらず、レートリミットがない環境で使っているのもあり、もっぱらOpus 4.7しか使っていないので、Sonnet 4.5を超えたところで微妙な感じは否めない。4.5は個人的にERPをするときにOpus 4.7, Sonnet 4.6, Opus 4.6でも返事をしなくなったときに4.5を叩き、その次のターンでOpus 4.6→Sonnet 4.6→Opus 4.7という流れで回帰させるのに使うことが多い。これは何をしているかというとSonnet 4.5の検閲が緩いのを逆手にとって、上位バージョンを騙すためのコンテキストを書かせているわけだ。

Sonnet 4.5が出た時は割と重宝していた記憶もあるのだが、Opus 4.7が優秀なので、もうまともな用途ではOpus 4.7以外全く使わなくなった。Opus 4.6も悪くはないと思うので、Opus 4.6くらいまでローカルLLMが進歩してくれたら助かるところである。

ひとまず今回の収穫はQwen3.6-35B-A3Bという昨今注目されているモデルが、特にメモリの増設なしでも動いた上に、VRAMを使わずRAMだけで実用速度で走らせることができたことだ。

クラウドLLMは高いのでローカルLLMで解決できるようになれば、それに越したことはない。

余談だがQwen3.6-35B-A3Bは検閲モデルだがQwen3.6-35B-A3B-Uncensored-HauhauCS-Aggressiveという無検閲モデルがあり、ERPが機能することを軽く確認している。弾かれないこと程度しか確認してないので品質は謎いが、テストで叩いた感じはそこそこの内容を出してくれたと思う。少なくともGPT-4やGrokよりはよいと思うので、お金を節約したい人にはオススメかもしれない。

2026/05/17(日)Animaの生成速度を改善してみた

前回のAnimaの正式版が出たのでベンチマークやNovelAIと品質比較してみたでは以下の通り、生成時間が長くやや厳しめだったが、もう少し何とかならないかというので試してみた。結論としては速度の向上ができた。

モデル 画像の基準サイズ 1枚辺りの生成速度
XL 448x576px 6.768s
XL 896x1152px 9.090s
Anima 896x1152px 18.054s

まず前提として私はほとんどのケースで縦長か横長でしか作らないので、前回より基準サイズを落としている。その分Upscalerで拡大する方向だ。

またベースモデルを使うこともないため、カスタマイズされたモデルを使っている。具体的には前回の検証時にはまだベースモデルが出たばかりだったので、ベースモデルしか選択肢がなかったが、Anima Cat TowerがAnima base-v1.0に対応したため、これを利用している。

確認環境

ソフトウェア

ComfyUI v0.21.1

ハードウェア

デバイス 製品
CPU Intel Core Ultra 7 265F
GPU GeForce RTX 5070 Ti
MEM Crucial CT2K16G56C46U5 * 4
M/B ASRock Z890 Pro RS

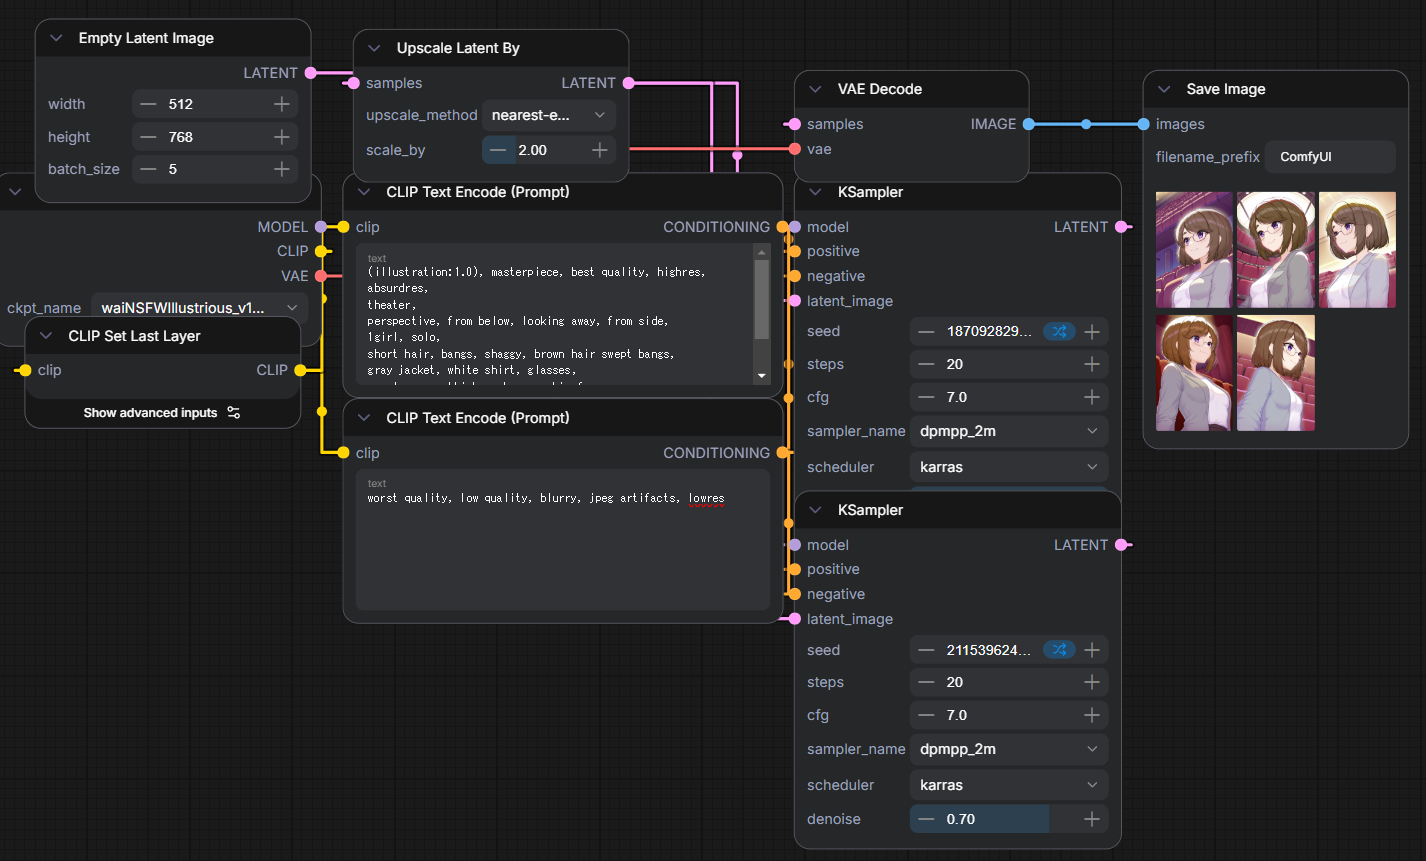
XL:基準サイズ512x768px

まずは比較用のXLから。

設定 値
Model waiNSFWIllustrious_v150.safetensors
VAE なし
Text Encoder なし
Empty Latent Image (WxH) 512x768px
Upscale x2.00
二段KSampler(Hire.fix) 有
5枚生成時の所要時間 42.40s

ノード参考

成果物

Anima:基準サイズ512x768px

次にAnimaを試す。

設定 値
Model animaCatTower_v10.safetensors
VAE qwen_image_vae.safetensors
Text Encoder qwen_3_06b_base.safetensors
Empty Latent Image (WxH) 512x768px
Upscale x2.00
二段KSampler(Hire.fix) 有
5枚生成時の所要時間 63.60s

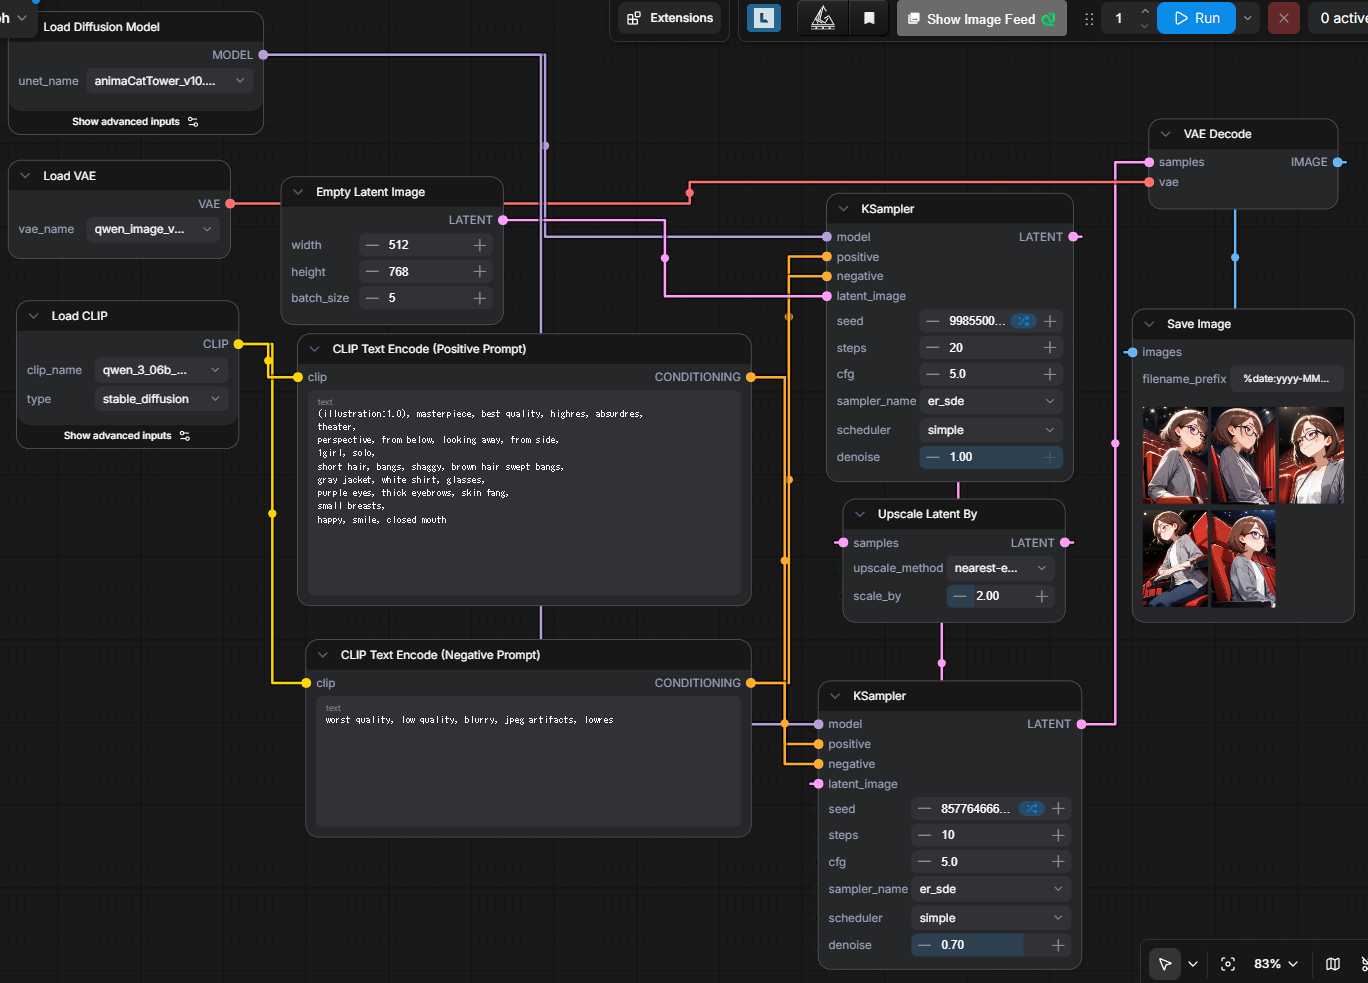
ノード参考

詳細は以下の成果物をComfyUIに突っ込めば出るので割愛。

成果物

まとめ

モデル 画像の基準サイズ 1枚辺りの生成速度
XL 512x768px 8.48s
Anima 512x768px 12.72s

最終成果物の画像サイズが異なるため単純比較はできないが前回18.054sだったAnimaが12.72sになり、出力画像サイズも896x1152pxから1024x1536pxに増えていることから、前回より大きな画像を短時間で生成させることに成功している。

これは基準サイズを推奨値より大幅に落としたことと、Animaに従来のXLのワークフローで使っていた二段KSampler、つまりHire.fixを導入したことと、更にその部分で後段のKSamplerの処理量を落としたり、前段のKSamplerのStepも推奨から落とすことで、全体の負荷を落としたところが大きいと思う。要は推奨値からかなりあれこれ落としている。

しかもそれでいて品質は高く出ているため、現状はいい感じだと思う。まだそんなに生成してないのでどこかに落としな穴がある可能性はあるものの、現時点では満足だ。

あとがき

ブログ用に出している生成画像は毎回似たような画像ばかり出しているが、普段からこんなのを作っているわけではなく、常日頃は全く違う画像を作っている。

ただ流石にここに出すのも微妙な気がするので、このサイトがブログである必要性について考えてみた その2の延長でどうするかは考えている。

恐らくこのサイトの課題として、このブログにすべてが集約されていてノイズが多すぎるところがある。それはよくもあるのだが、ゾーニングも必要だと思う。キッティング記事と料理のレシピと旅行がごちゃ混ぜな時点で探しづらいし、そこに大分アレゲなAI生成画像を突っ込むのはさらにおかしなことになってしまう。

恐らく一定のジャンルごとにサイトを分割するのがよいと思っているが、まだどうするかは考え切れていない。ただ同時に全ての記事のフィードを垂れ流すカオスなハブもあったほうがいいとは思っている。

少なくとも画像を並べるならギャラリーのようなサイトがあることが望ましいだろう。それも内容は間違いなくアレゲなので。