2025/09/10(水)マシンを更新したのでローカルLLMを軽くベンチマークしてみた

更新日:
投稿日:

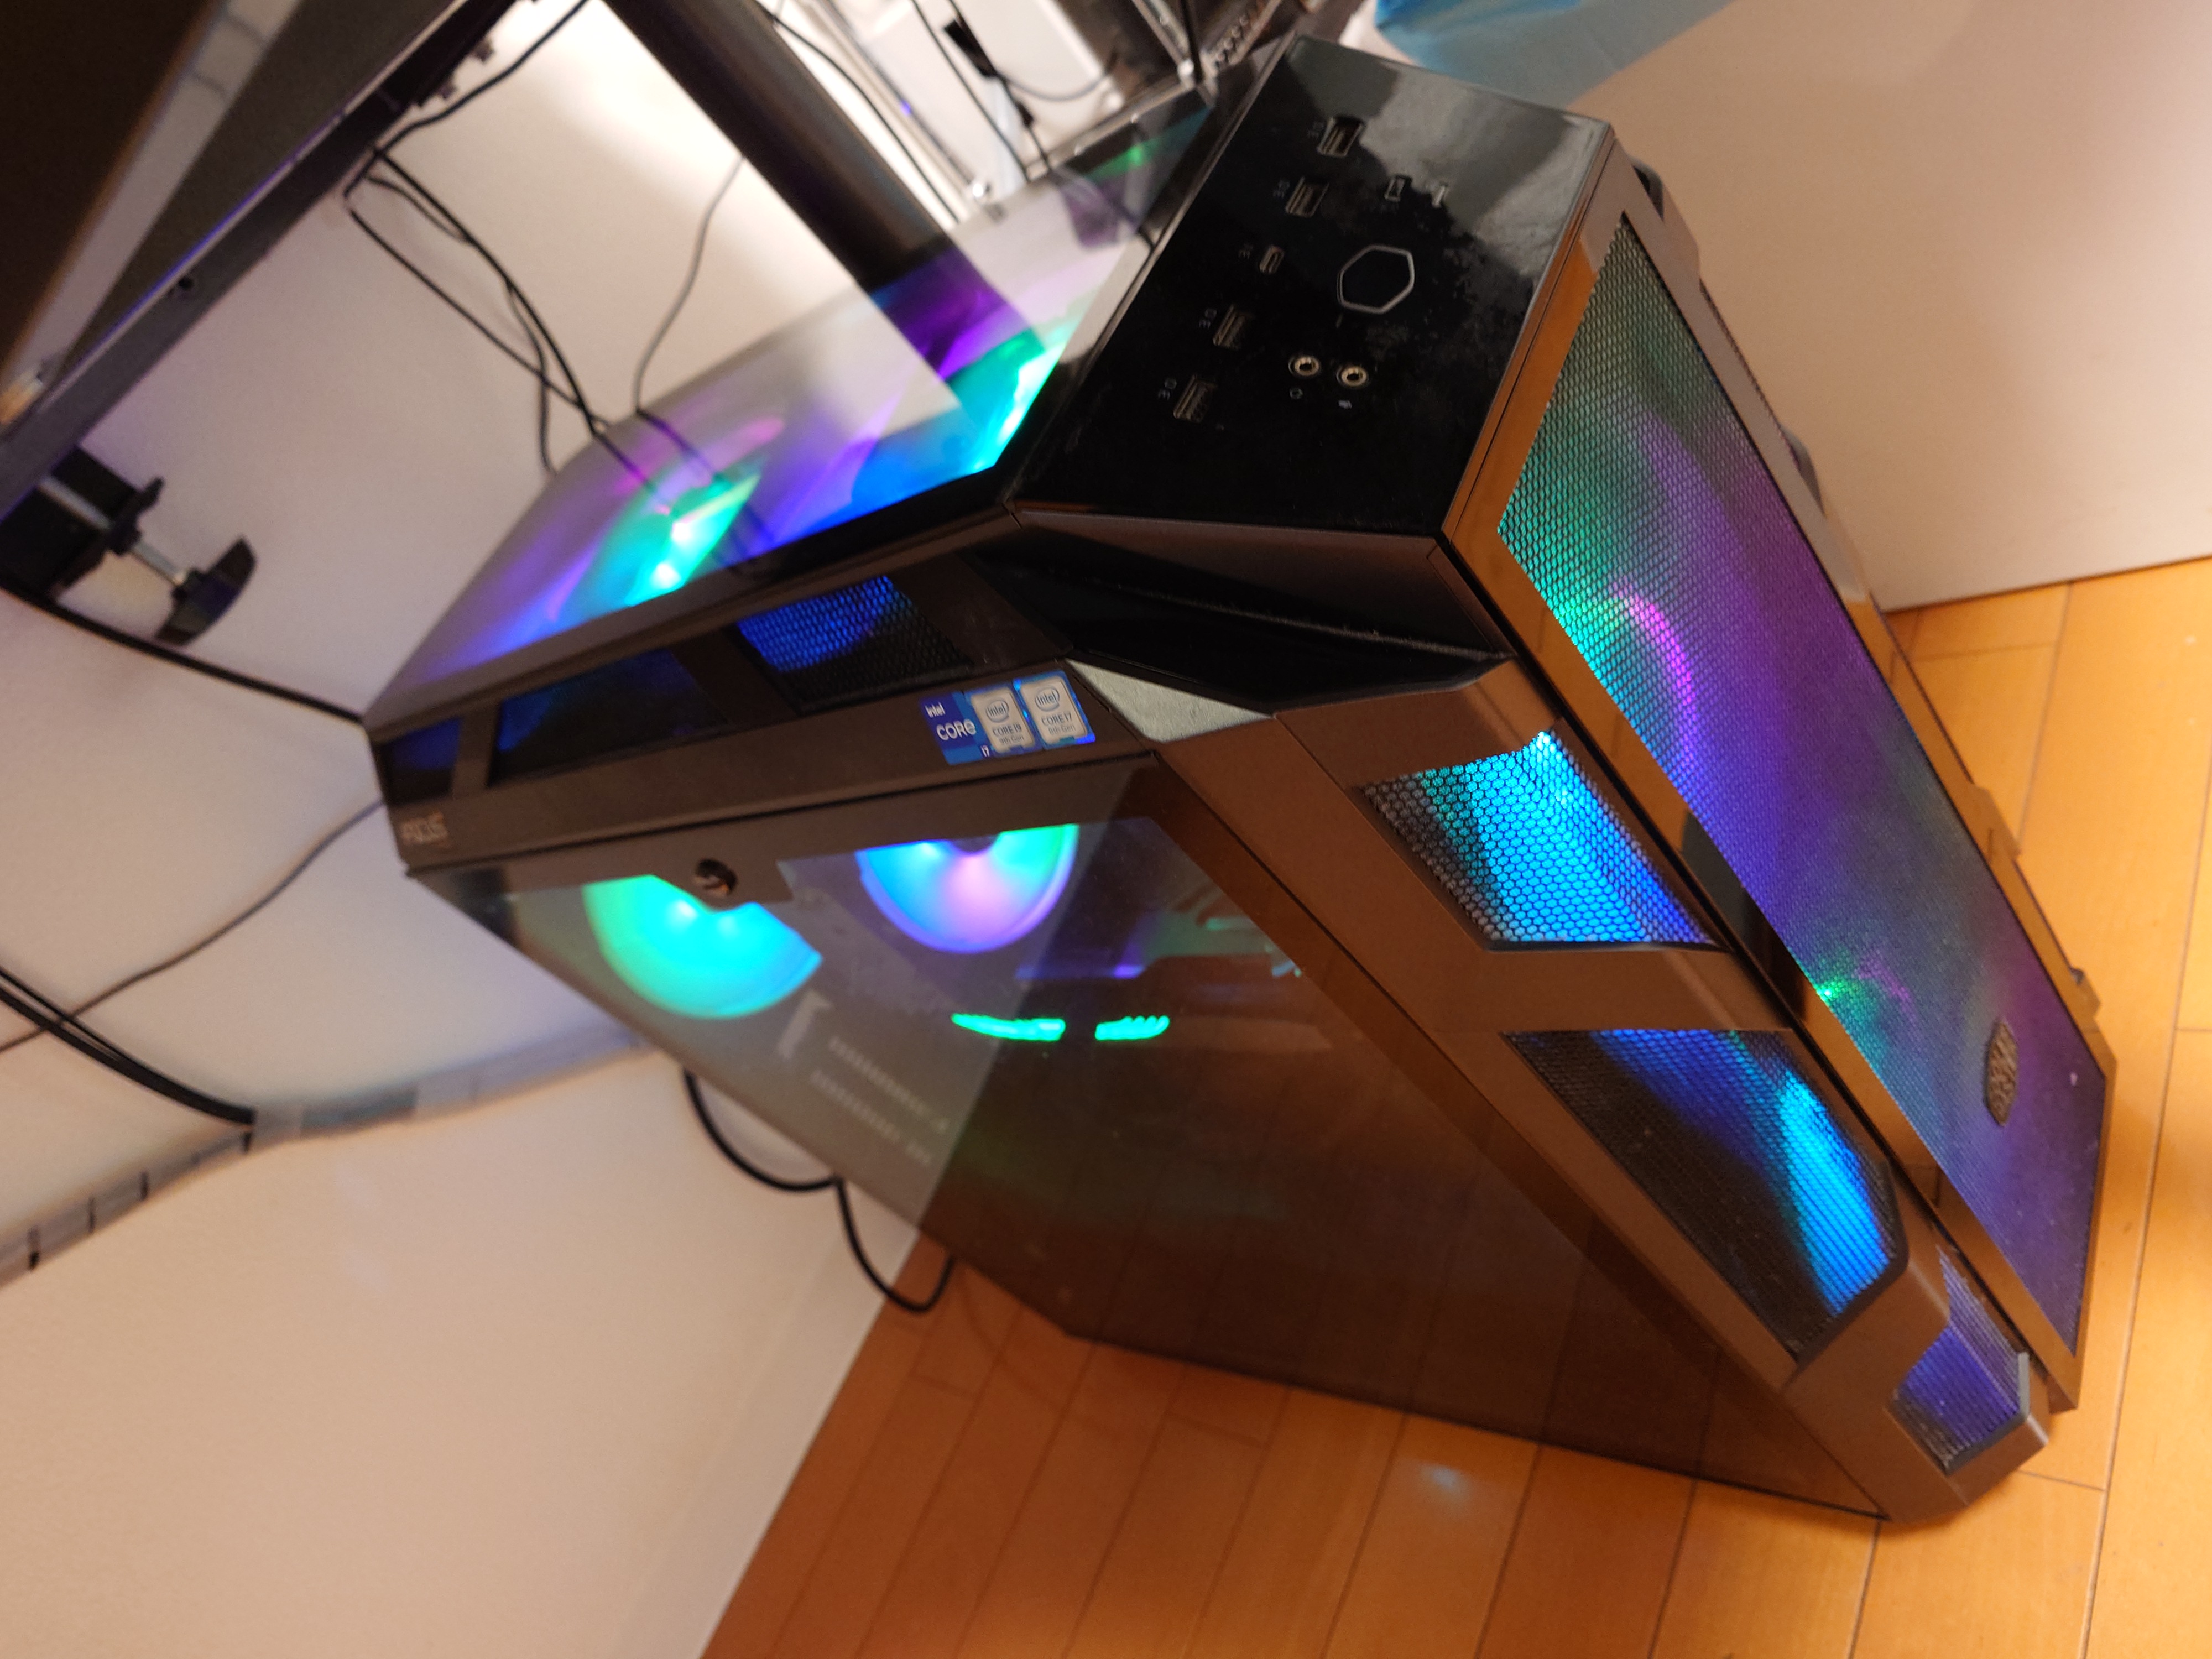
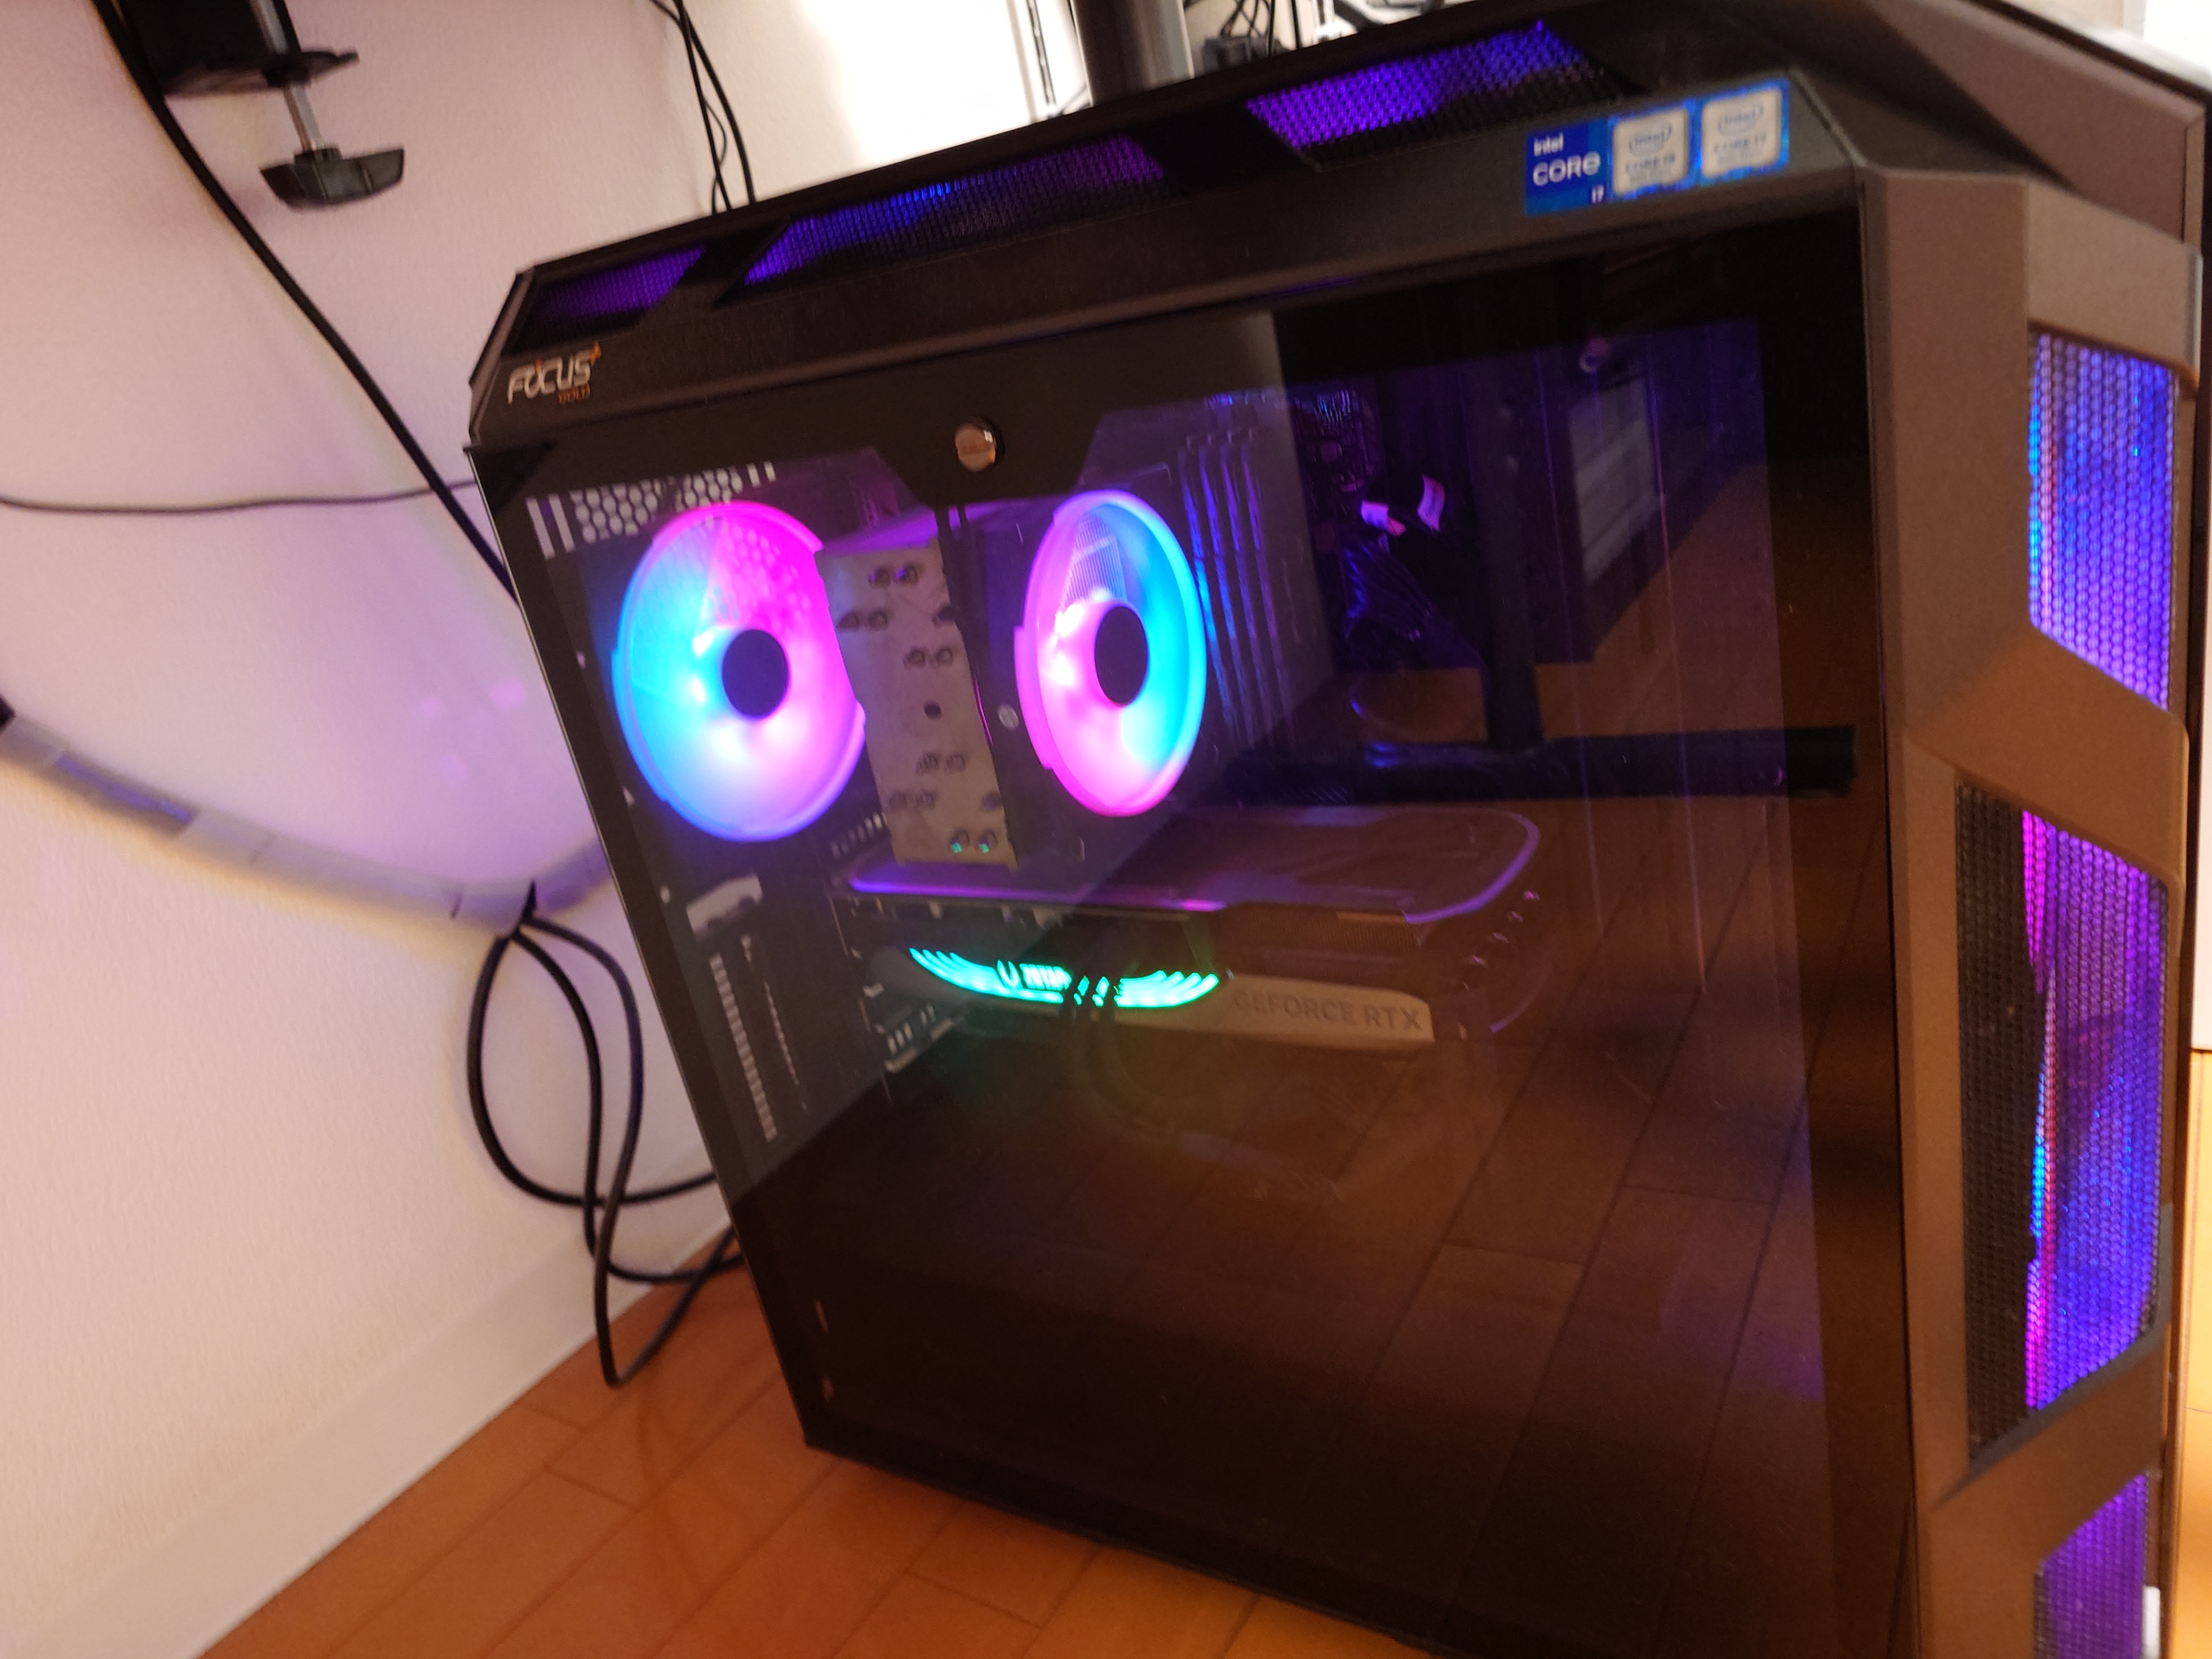
久々にPC構成を大刷新してから三ヶ月ほど経過しているが、ローカルLLMを叩いたときのパフォーマンスが前回と比べてどれほど上がるか計測してみた。

環境の現新比較

デバイス 前回 今回
CPU Intel Core i7 13700 Intel Core Ultra 7 265F
GPU GeForce RTX 4070 Ti GeForce RTX 5070 Ti
MEM Crucial Ballistix BL2K16G32C16U4B(DDR4-3200 16GB) * 4 Crucial CT2K16G56C46U5(DDR5-5600 16GB) * 4
M/B ASUS TUF GAMING Z790-PLUS D4 ASRock Z890 Pro RS

確認環境

実行環境はWindows 11。

Env Ver
ollama 0.15.2
Open WebUI 0.6.42

ベンチマーク結果

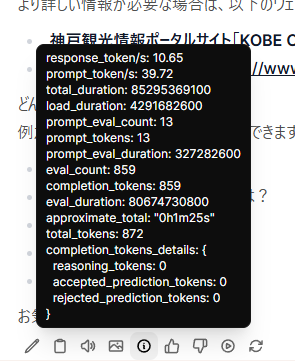
前回はストップウォッチで計測していたが、今回はOpenWebUIのメタ情報から確認した。

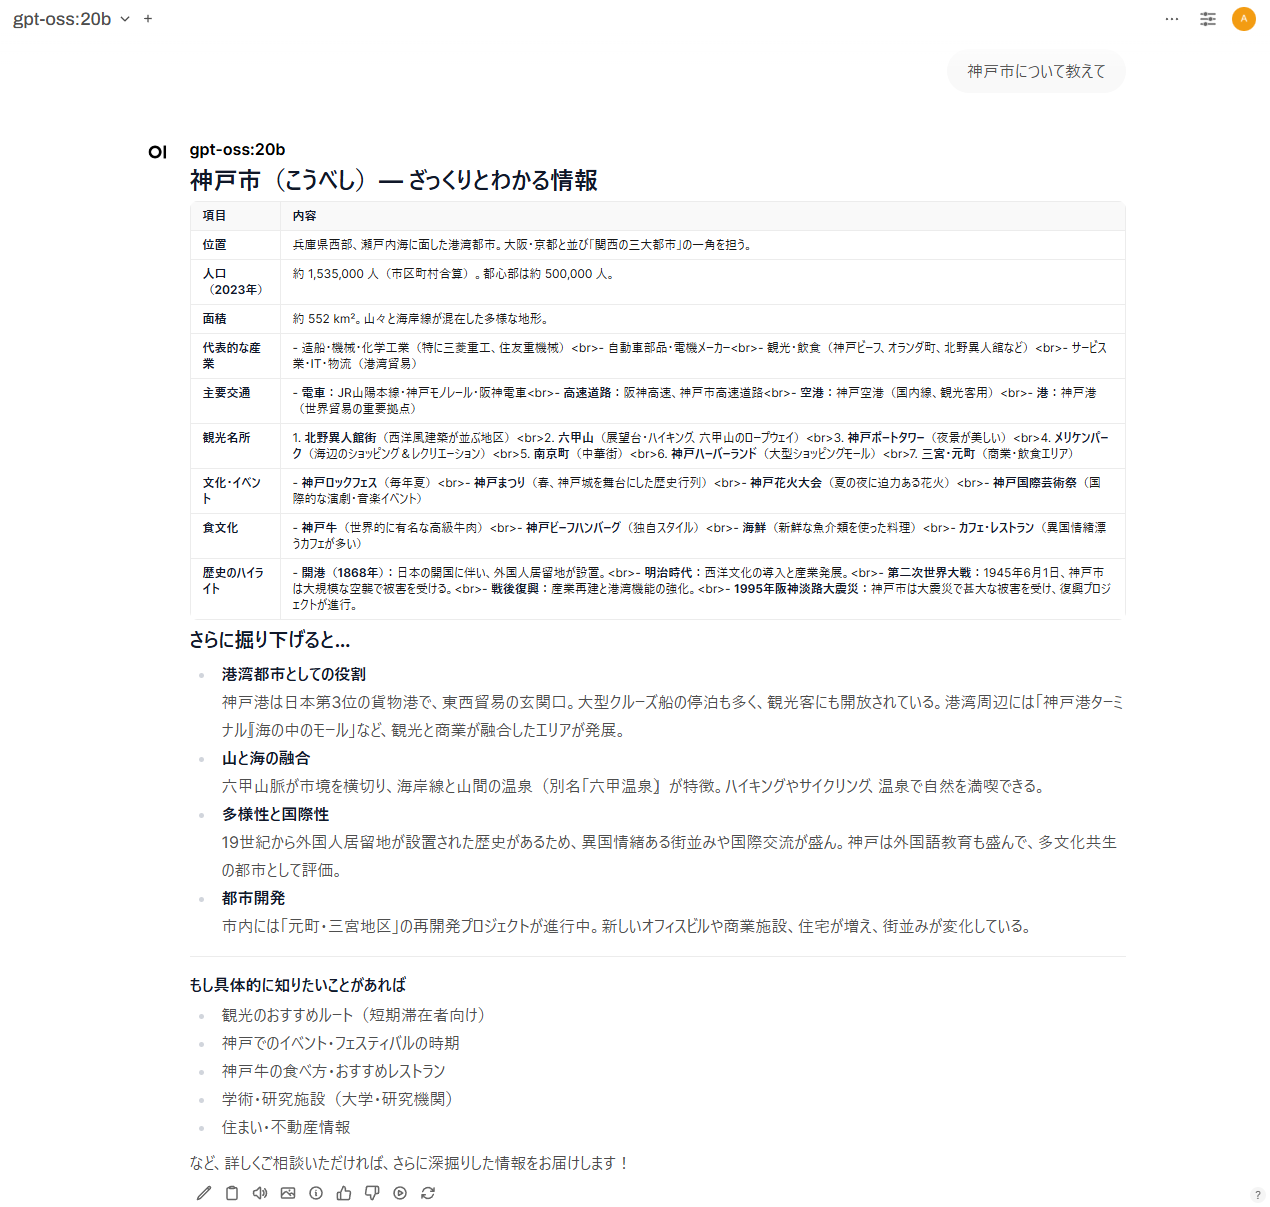
gpt-oss:20b

指標 値
response_token/s 120.74
prompt_token/s 255.92
total_duration 22796593800
load_duration 11155098300
prompt_eval_count 73
prompt_tokens 73
prompt_eval_duration 285245200
eval_count 1371
completion_tokens 1371
eval_duration 11355103800
approximate_total 22s
total_tokens 1444

今回新規で追加。なんかこいつが標準っぽいので測ってみた。

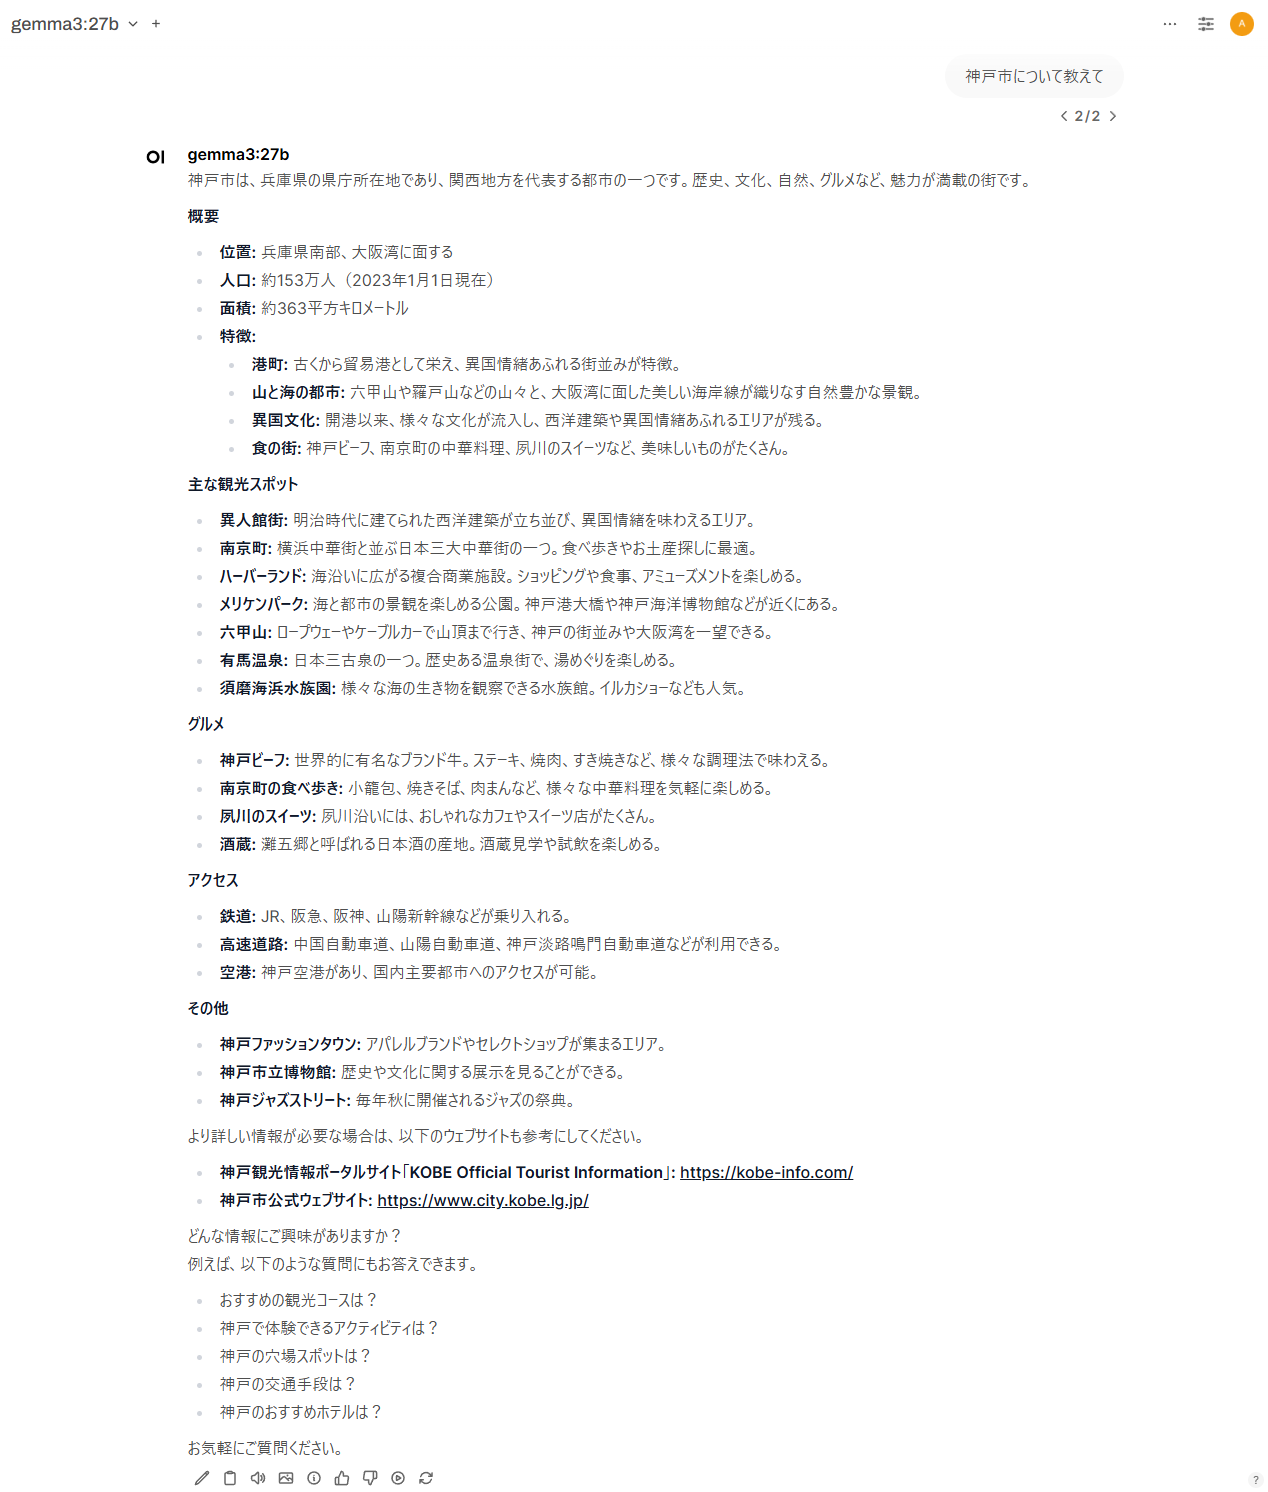
gemma3:27b

指標 値
response_token/s 10.65
prompt_token/s 39.72
total_duration 85295369100
load_duration 4291682600
prompt_eval_count 13
prompt_tokens 13
prompt_eval_duration 327282600
eval_count 859
completion_tokens 859
eval_duration 80674730800
approximate_total 1m25s
total_tokens 872

前回は出力に3分半程度かかっていたが、今回は一分半程度と、良好な結果となった。

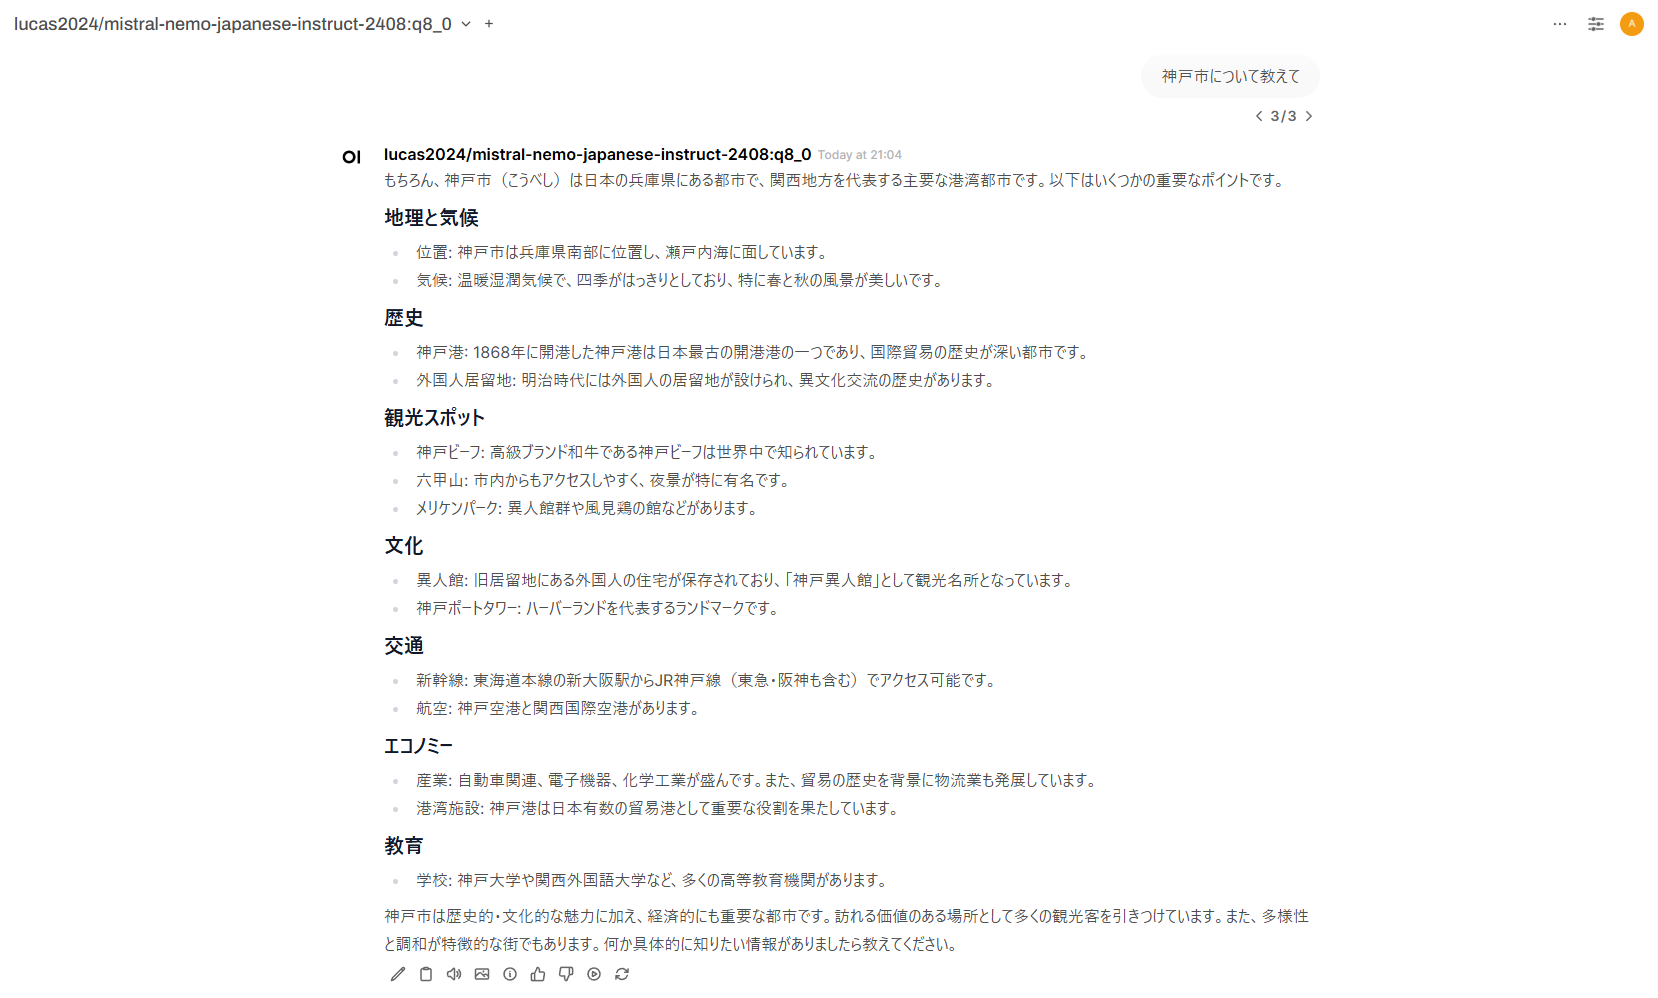
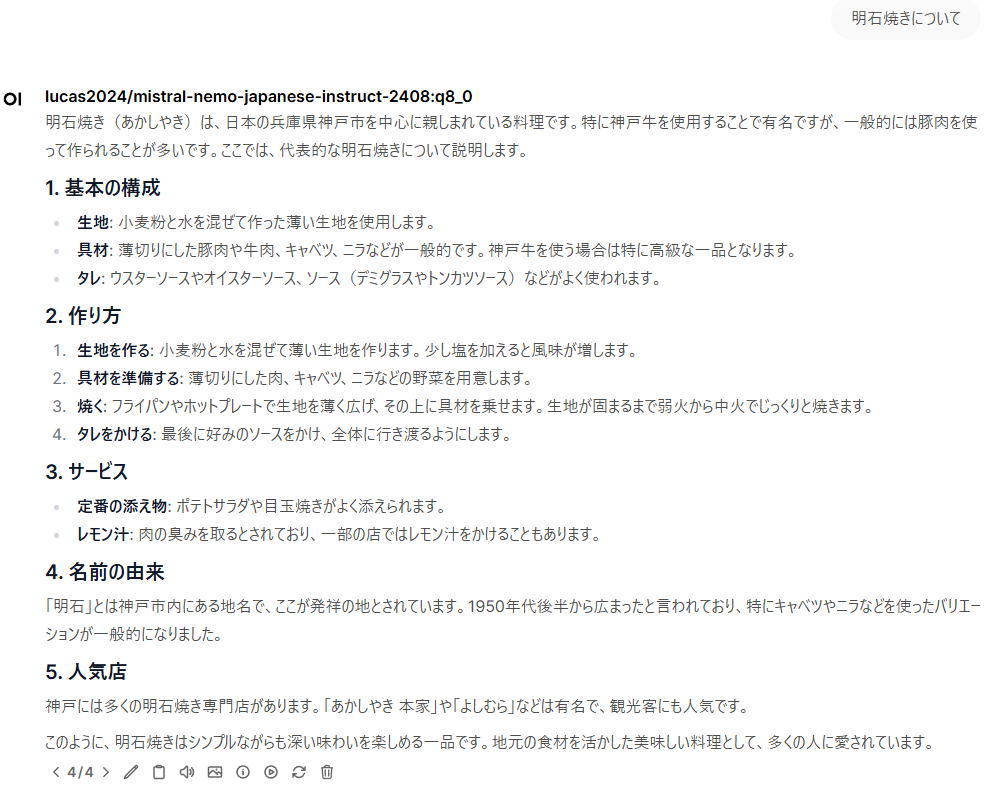
lucas2024/mistral-nemo-japanese-instruct-2408:q8_0

指標 値
response_token/s 51.88
prompt_token/s 127.3
total_duration 14512642900
load_duration 2966192400
prompt_eval_count 17
prompt_tokens 17
prompt_eval_duration 133547400
eval_count 592
completion_tokens 592
eval_duration 11411474600
approximate_total 14s
total_tokens 609

前回は出力に1分程度かかっていたが、今回は14秒程度と、非常に良好な結果となった。

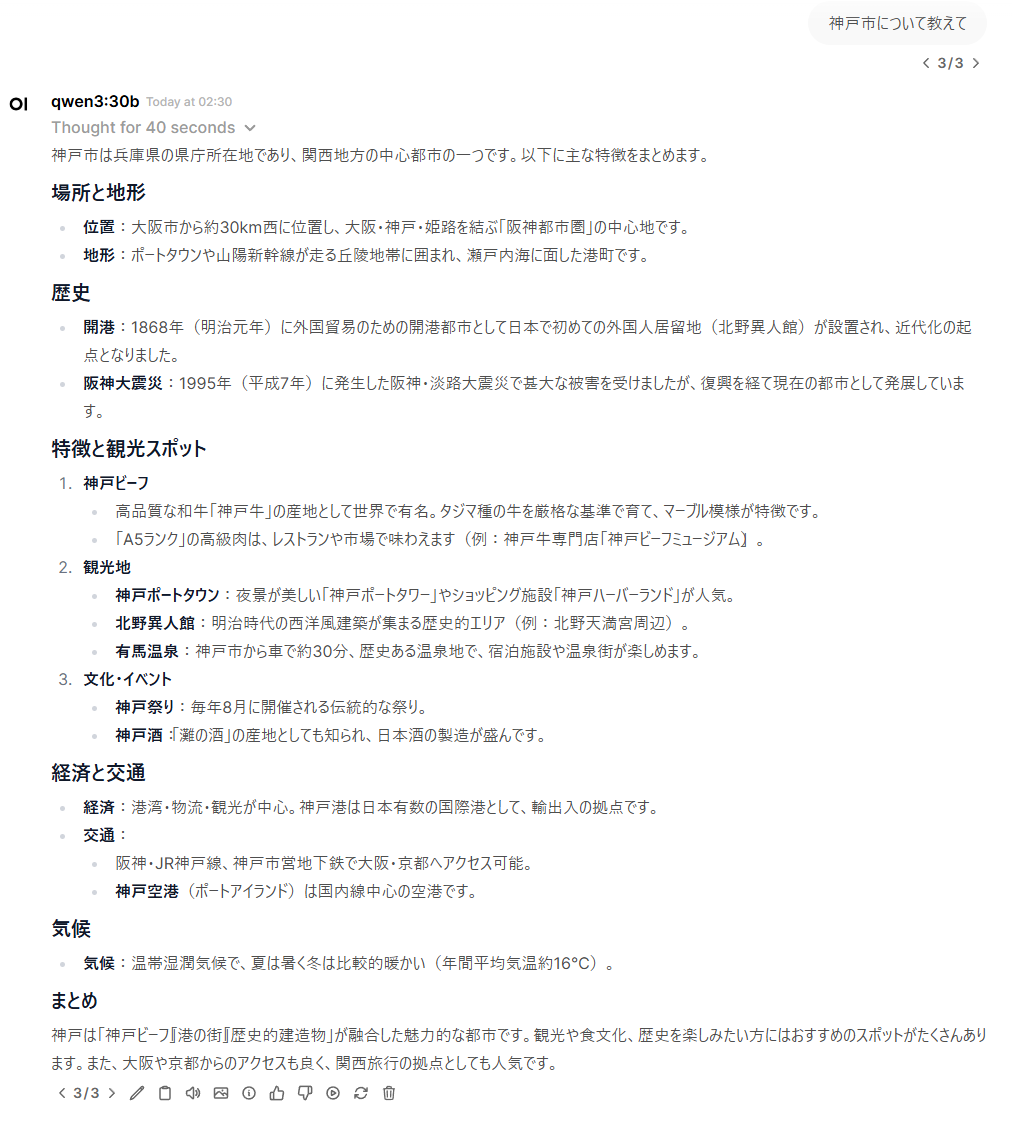
qwen3:30b

指標 値
response_token/s 27.49
prompt_token/s 57.74
total_duration 134732866900
load_duration 64763725000
prompt_eval_count 14
prompt_tokens 14
prompt_eval_duration 242451700
eval_count 1917
completion_tokens 1917
eval_duration 69724445400
approximate_total 2m14s

今回新規で追加。悪くない品質で、そこそこ早いのでこれは良さそうだ。

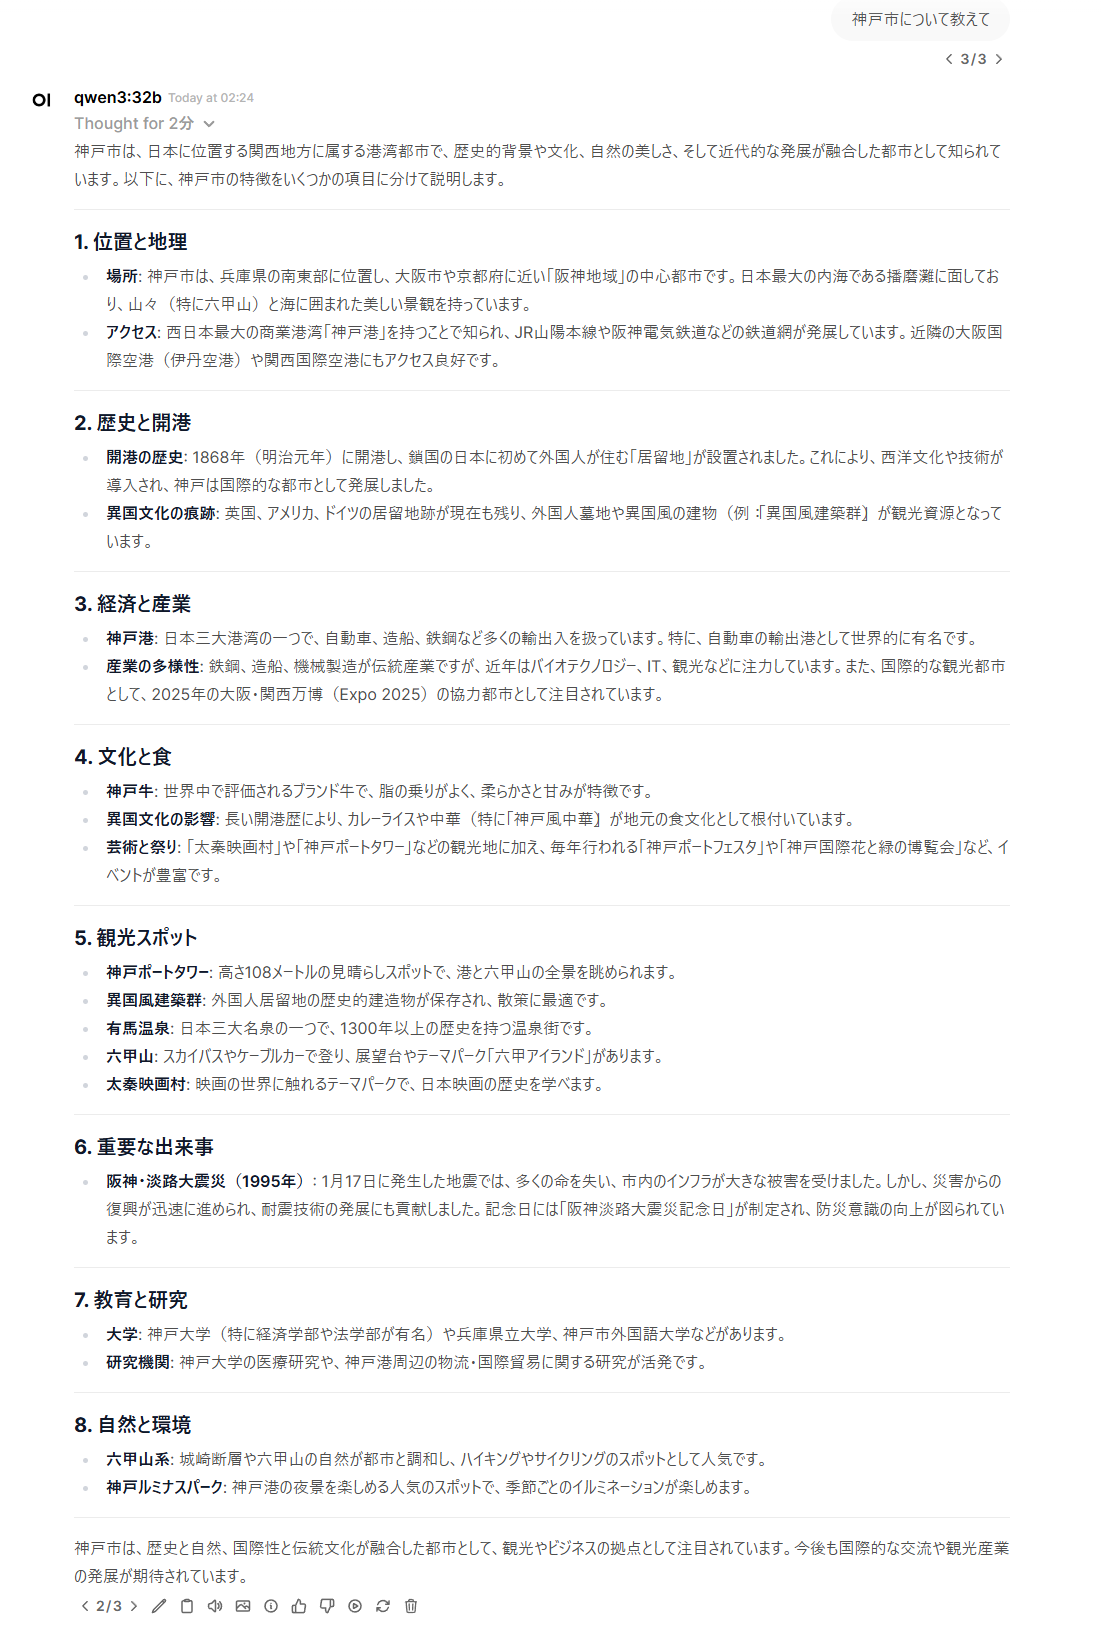
qwen3:32b

指標 値
response_token/s 5.66
prompt_token/s 18.49
total_duration 332234237600
load_duration 9168679700
prompt_eval_count 14
prompt_tokens 14
prompt_eval_duration 757307500
eval_count 1823
completion_tokens 1823
eval_duration 322305287600
approximate_total 5m32s
total_tokens 1837

今回新規で追加。流石に秒間5.66トークンは厳しい。

雑感

前回と比べるとかなり高速化されており、生成速度だけを見れば十分実用ラインに上がっていているように感じた。しかし回答の品質がそこまでよくなく、そのままでは使えないと感じた。恐らくRAGなどとして使えるようにカスタムしてやっと使えてくるみたいなところがあるのだろうか?

実用性で見ると、日本語文書作成ではgemma3:27bが一番よさそうに思えた。これはqwen3シリーズは単純な質問では結構いい感じなのだが、複雑な条件を付けると期待通りの結果を出してくれなかったからだ。lucas2024/mistral-nemo-japanese-instruct-2408:q8_0も、一見よさそうに見えるがよろしくない発言はできないように細工されているようで、微妙に感じた。

何はともあれ、現実的な速度でローカルLLMが動くようになったのはうれしい。

2025/08/19(火)Ubuntuのネイティブ環境にPrometheusとGrafanaをIPv6スタックで導入した

更新日:
投稿日:

この記事では自宅サーバーの監視環境導入にあたり、ほぼ前提知識なしの状態からPrometheusとGrafanaを導入した経緯を書いている。IPv6シングルスタック対応。

確認環境

Ubuntu実機AMD64環境

Env Ver
Ubuntu 24.04.3 LTS
nginx 1.26.1
Prometheus 3.5.0
Node exporter 1.9.1
NGINX Prometheus Exporter 1.4.2
Grafana v12.1.1

OpenWrtで設置サーバー向けのPrometheusとGrafanaのDNS設定をしてアクセス可能にする

今回の作業はLAN内にある作業機からサーバーマシンに対して行うため、利便性のため各サービスに対してドメインを振っておく。

  1. OpenWrtの/etc/hostsを開きPrometheusとGrafanaの設定を書く
    1. ここでは一旦、prometheus.testとgrafana.testとする
  2. /etc/init.d/dnsmasq restart
  3. これでLAN配下の端末からnginxで設定したホスト名でアクセスできるようになる

Prometheusの導入

Prometheusとは

PrometheusとはSoundCloudで開発された時系列のスタンドアロンバイナリのツールで、時系列でメトリクスを収集するツールのようだ。オープンソースソフトウェアとして公開されている。

メトリクスとは数値測定のことで、例えばCPU使用率や、メモリ使用量、HTTPサーバーがこれまでに返したレスポンスコード別のカウントなど、そういった数値のことだ。Prometheusはこれを定期的に収集することで、収集時刻+メトリクスで時系列の数値データを蓄積しているものと思われる。

実際のデータとしてはメトリック名に対して連想配列を格納したデータを保持しているっぽい。イメージとしては以下のような感じだろうか。

<metricName>: { <labelName>: <labelValue>, ... }

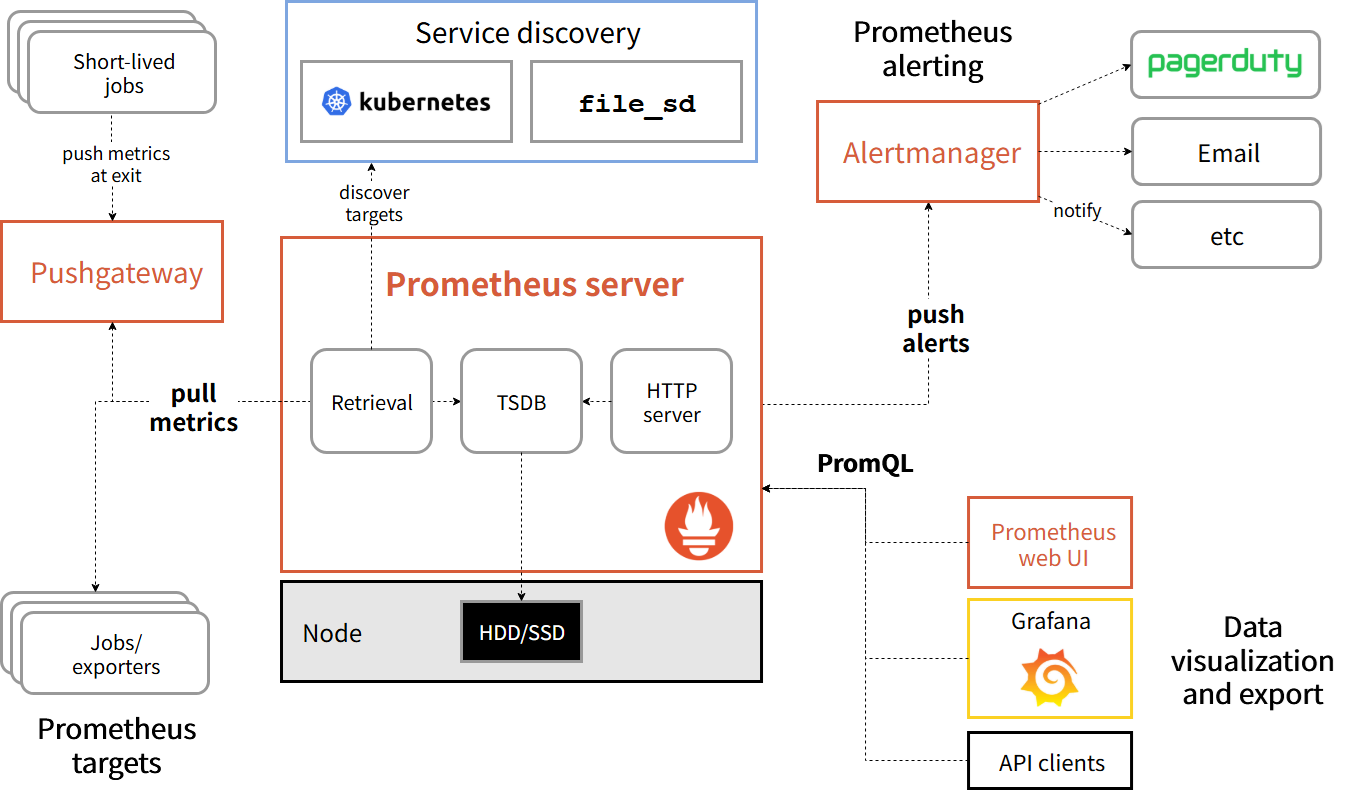
メトリクスはExporterと呼ばれるサービスに対してHTTP要求を投げ、その応答を記録しているようだ。つまりExporterがメトリクスを取得、Prometheus向けに情報加工し、PrometheusはExporterからこれを取得、時系列のデータベースにしているのだろう。

またエンドポイントが揮発性であるなど、短命である場合はPushgatewayというプロキシを使い、PushgatewayがPrometheus向けに情報公開する仕組みもあるようだ。

EoLはリリースから一年ほどと、短い。

本体のインストール

  1. Prometheusセットアップコマンドを流す

    # 作業場所の作成
    mkdir temp
    cd temp
    
    # バイナリ取得
    wget https://github.com/prometheus/prometheus/releases/download/v3.5.0/prometheus-3.5.0.linux-amd64.tar.gz
    tar xvfz prometheus-3.5.0.linux-amd64.tar.gz
    
    # Prometheus実行ユーザーの作成
    sudo groupadd prometheus
    sudo useradd prometheus -g prometheus -d /var/lib/prometheus -s /usr/sbin/nologin -m
    ls -la /var/lib/prometheus/
    
    # binを配置
    cd prometheus-3.5.0.linux-amd64
    sudo cp prometheus promtool /usr/local/bin/
    ls -la /usr/local/bin | grep prom
    
    # 設定ファイルを配置
    sudo mkdir /etc/prometheus
    cat<<'EOF' | sudo tee /etc/prometheus/prometheus.yaml
    global:
    scrape_interval:     15s
    evaluation_interval: 15s
    
    rule_files:
    # - "first.rules"
    # - "second.rules"
    
    scrape_configs:
    - job_name: prometheus
        static_configs:
        - targets: ['[::]:9090']
    EOF
    
    sudo chown -R prometheus:prometheus /etc/prometheus
    ls -la /etc/prometheus
    
    # デーモン作成
    cat <<'EOF' | sudo tee /etc/systemd/system/prometheus.service
    [Unit]
    Description=Prometheus - Monitoring and alerting toolkit
    After=network-online.target
    Wants=network-online.target
    
    [Service]
    Type=simple
    User=prometheus
    Group=prometheus
    WorkingDirectory=/var/lib/prometheus
    ExecStart=/usr/local/bin/prometheus \
        --config.file=/etc/prometheus/prometheus.yaml \
        --storage.tsdb.path=/var/lib/prometheus \
        --web.listen-address=[::]:9090
    ExecReload=/bin/kill -HUP $MAINPID
    Restart=on-failure
    RestartSec=5s
    
    [Install]
    WantedBy=multi-user.target
    EOF
    
    # デーモン有効化
    sudo systemctl daemon-reload
    sudo systemctl enable --now prometheus
    
  2. nginxからPrometheusの管理画面が開けるようにする。/etc/nginx/conf.d/prometheus.confを作成し、以下を記述。

    upstream prometheus {
      server [::1]:9090;
    }
    
    server {
      listen        [::]:80;
      server_name   prometheus.test;
    
      access_log   /var/log/nginx/prometheus.access.log;
      error_log    /var/log/nginx/prometheus.error.log;
    
      location / {
        proxy_set_header Host $host;
        proxy_pass  http://prometheus;
      }
    }
    
  3. sudo service nginx restart

  4. 設定したホストにアクセスできればOK

本体設定の説明

先ほどの「Prometheusセットアップコマンドを流す」ステップで作成した設定の説明。

First steps with Prometheusに書いてある通り、設定はprometheus.yamlのようなYAMLファイルに定義し、./prometheus --config.file=prometheus.ymlの様にして起動時に読み込んで利用する。

global:
  scrape_interval:     15s
  evaluation_interval: 15s

rule_files:
  # - "first.rules"
  # - "second.rules"

scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ['[::1]:9090']

globalセクションではポーリング頻度と、ルールの評価頻度が指定されている。

rule_filesではルールファイルが指定される。

scrape_configsではポーリング先のリソースを指定する。この場合はhttp://localhost:9090/metricsに対して行われる。

ログの保持期限について

ログの保持期限はprometheusを蹴るときのコマンドラインオプションで決まる。

デフォルトでは15日だが、--storage.tsdb.retention.timeを指定することで増やせるようだ。

単位はy, w, d, h, m, s, msがあり、--storage.tsdb.retention.time=90dの様にして指定する模様。

How long to retain samples in storage. If neither this flag nor "storage.tsdb.retention.size" is set, the retention time defaults to 15d. Units Supported: y, w, d, h, m, s, ms. Use with server mode only.

個人的にはデフォルトの15日で様子見し、必要に応じて伸ばしていこうと考えている。商業サービスのように可用性が重視され、障害発生などで過去を遡りたい場合には長期記録があると手がかりが増えるので、有用だと思う。

Exporterの導入

Exporterは実際に数値を収集し、Prometheusに対して情報公開するためのHTTPエンドポイントを提供するサービスで、この章では今回利用するものについて書いていく。

OSやマシンの監視:Node exporter

POSIX系システムのOSやマシンの監視にはPrometheus公式のNode exporterを利用する。

インストール
# 取得
wget https://github.com/prometheus/node_exporter/releases/download/v1.9.1/node_exporter-1.9.1.linux-amd64.tar.gz
tar xvfz node_exporter-1.9.1.linux-amd64.tar.gz
cd node_exporter-1.9.1.linux-amd64/

# binを配置
sudo cp node_exporter /usr/local/bin/
ls -la /usr/local/bin/ | grep node_exporter

# デーモン作成
cat <<'EOF' | sudo tee /etc/systemd/system/node_exporter.service
Description=Node exporter
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=prometheus
Group=prometheus
WorkingDirectory=/var/lib/prometheus
ExecStart=/usr/local/bin/node_exporter \
    --web.listen-address=[::]:9100
ExecReload=/bin/kill -HUP $MAINPID
Restart=on-failure
RestartSec=5s

[Install]
WantedBy=multi-user.target
EOF

# デーモン有効化
sudo systemctl daemon-reload
sudo systemctl enable --now node_exporter
prometheus.yamlの設定

/etc/prometheus/prometheus.yamlを開きscrape_configs:に以下を追記

  - job_name: 'node'
    static_configs:
      - targets: ['[::1]:9100']
nginxの監視:NGINX Prometheus Exporter

nginxの監視にはnginx公式のNGINX Prometheus Exporterを利用する。

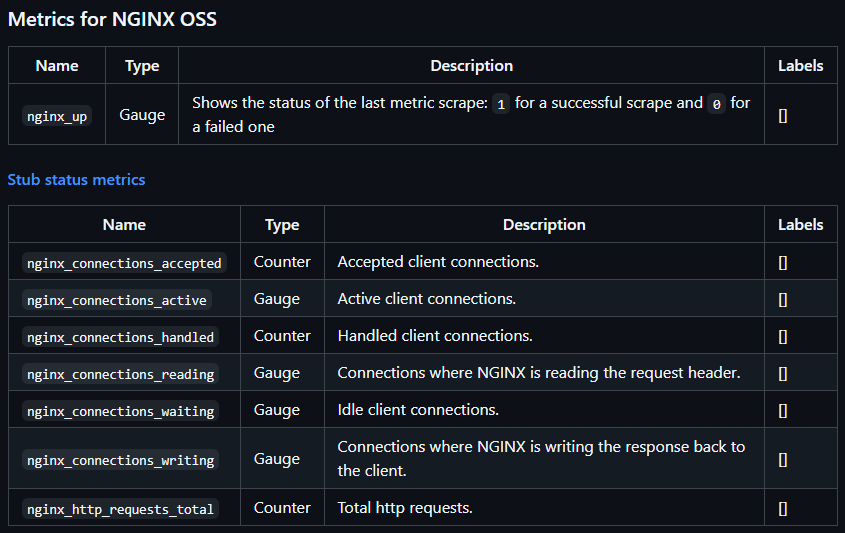
これはログを監視するわけではなく、接続を許可した数や、現在の接続数、これまでのHTTP要求合計などの数値を公開しているようだ。

nginxにヘルスチェック追加

/etc/nginx/conf.d/status.confを作ってstub_status_moduleを埋める。

server {
    listen [::]:80;

    location /stub_status {
        stub_status on;
        access_log off;
        allow ::1;
        deny all;
    }
}

疎通確認

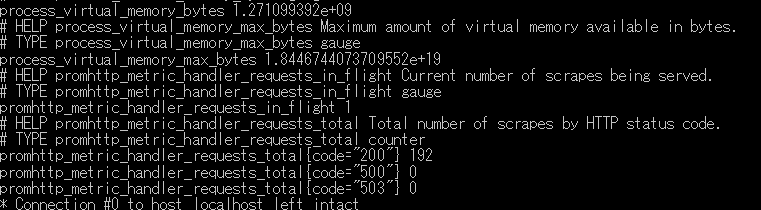
curl -v http://localhost/stub_status

こんなのが来ればOK

< HTTP/1.1 200 OK
< Server: nginx/1.26.1
< Date: Mon, 18 Aug 2025 10:31:59 GMT
< Content-Type: text/plain
< Content-Length: 97
< Connection: keep-alive
<
Active connections: 1
server accepts handled requests
 1 1 1
Reading: 0 Writing: 1 Waiting: 0
* Connection #0 to host localhost left intact
Exporterのインストール
# 取得
wget https://github.com/nginx/nginx-prometheus-exporter/releases/download/v1.4.2/nginx-prometheus-exporter_1.4.2_linux_amd64.tar.gz
tar xvfz nginx-prometheus-exporter_1.4.2_linux_amd64.tar.gz

# binを配置
sudo cp nginx-prometheus-exporter /usr/local/bin/
ls -la /usr/local/bin/ | grep nginx-prometheus-exporter

# デーモン作成
cat <<'EOF' | sudo tee /etc/systemd/system/nginx_exporter.service
[Unit]
Description=NGINX Exporter
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=prometheus
Group=prometheus
ExecStart=/usr/local/bin/nginx-prometheus-exporter \
    --nginx.scrape-uri=http://[::]/stub_status \
    --no-web.systemd-socket \
    --web.listen-address=:9113
ExecReload=/bin/kill -HUP $MAINPID
Restart=on-failure
RestartSec=5s

[Install]
WantedBy=multi-user.target
EOF

# デーモン有効化
sudo systemctl daemon-reload
sudo systemctl enable --now nginx_exporter
prometheus.yamlの設定

/etc/prometheus/prometheus.yamlを開きscrape_configs:に以下を追記

  - job_name: 'nginx'
    static_configs:
      - targets: ['[::1]:9113']
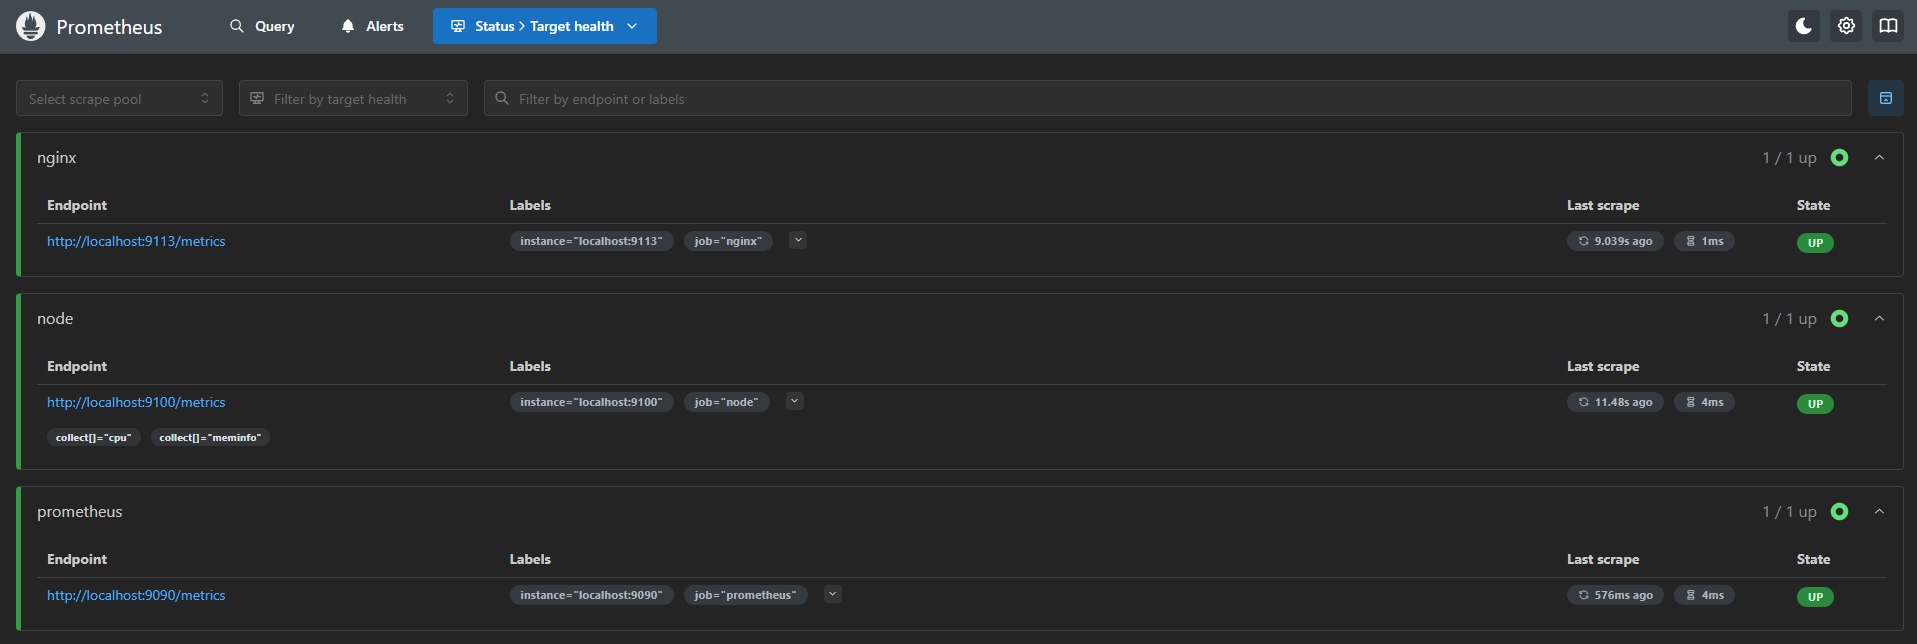
Prometheusの管理画面を確認

http://prometheus.testにアクセスできることを確認し、ついでにStatus→Target healthでExporterの死活も見ておくと良い。

Grafanaの導入

Grafanaとは

Grafanaとはオープンソースのビジュアライザツールである。PrometheusやMySQLなどのデータソースを基にグラフにしたりすることができる。

Lokiというツールを使うことでログも扱うことができ、ログビューワとしても使えるようだ。

インストール

  1. 次のコマンドでインストールする

    # debの取得とインストール
    sudo apt-get install -y adduser libfontconfig1
    wget https://dl.grafana.com/grafana-enterprise/release/12.1.1/grafana-enterprise_12.1.1_16903967602_linux_amd64.deb
    sudo dpkg -i grafana-enterprise_12.1.1_16903967602_linux_amd64.deb
    
    # デーモンの有効化
    sudo /bin/systemctl daemon-reload
    sudo /bin/systemctl enable grafana-server
    sudo service grafana-server start
    

Grafanaの画面を見れるようにする

  1. 適当にnginxの設定ファイルを切って以下のように書き、アクセスする

    # This is required to proxy Grafana Live WebSocket connections.
    map $http_upgrade $connection_upgrade {
      default upgrade;
      '' close;
    }
    
    upstream grafana {
      server [::1]:3000;
    }
    
    server {
      listen        [::]:80;
      server_name   grafana.test;
    
      access_log   /var/log/nginx/grafana.access.log;
      error_log    /var/log/nginx/grafana.error.log;
    
      location / {
        proxy_set_header Host $host;
        proxy_pass  http://grafana;
      }
    
      # Proxy Grafana Live WebSocket connections.
      location /api/live/ {
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection $connection_upgrade;
        proxy_set_header Host $host;
        proxy_pass http://grafana;
      }
    }
    
  2. ID: admin, PW: adminでログインしパスワードを変更する

  3. ログインしたら画面右上からProfileを開き、Usernameを変更する

GrafanaからPrometheusのメトリクスを見れるようにする

Prometheusとの接続
  1. Home→Connections→Add new connectionでPrometheusを検索
  2. 右上のAdd new data sourceを押す
  3. Connectionにhttp://localhost:9090を入れる
  4. Save & testを押す
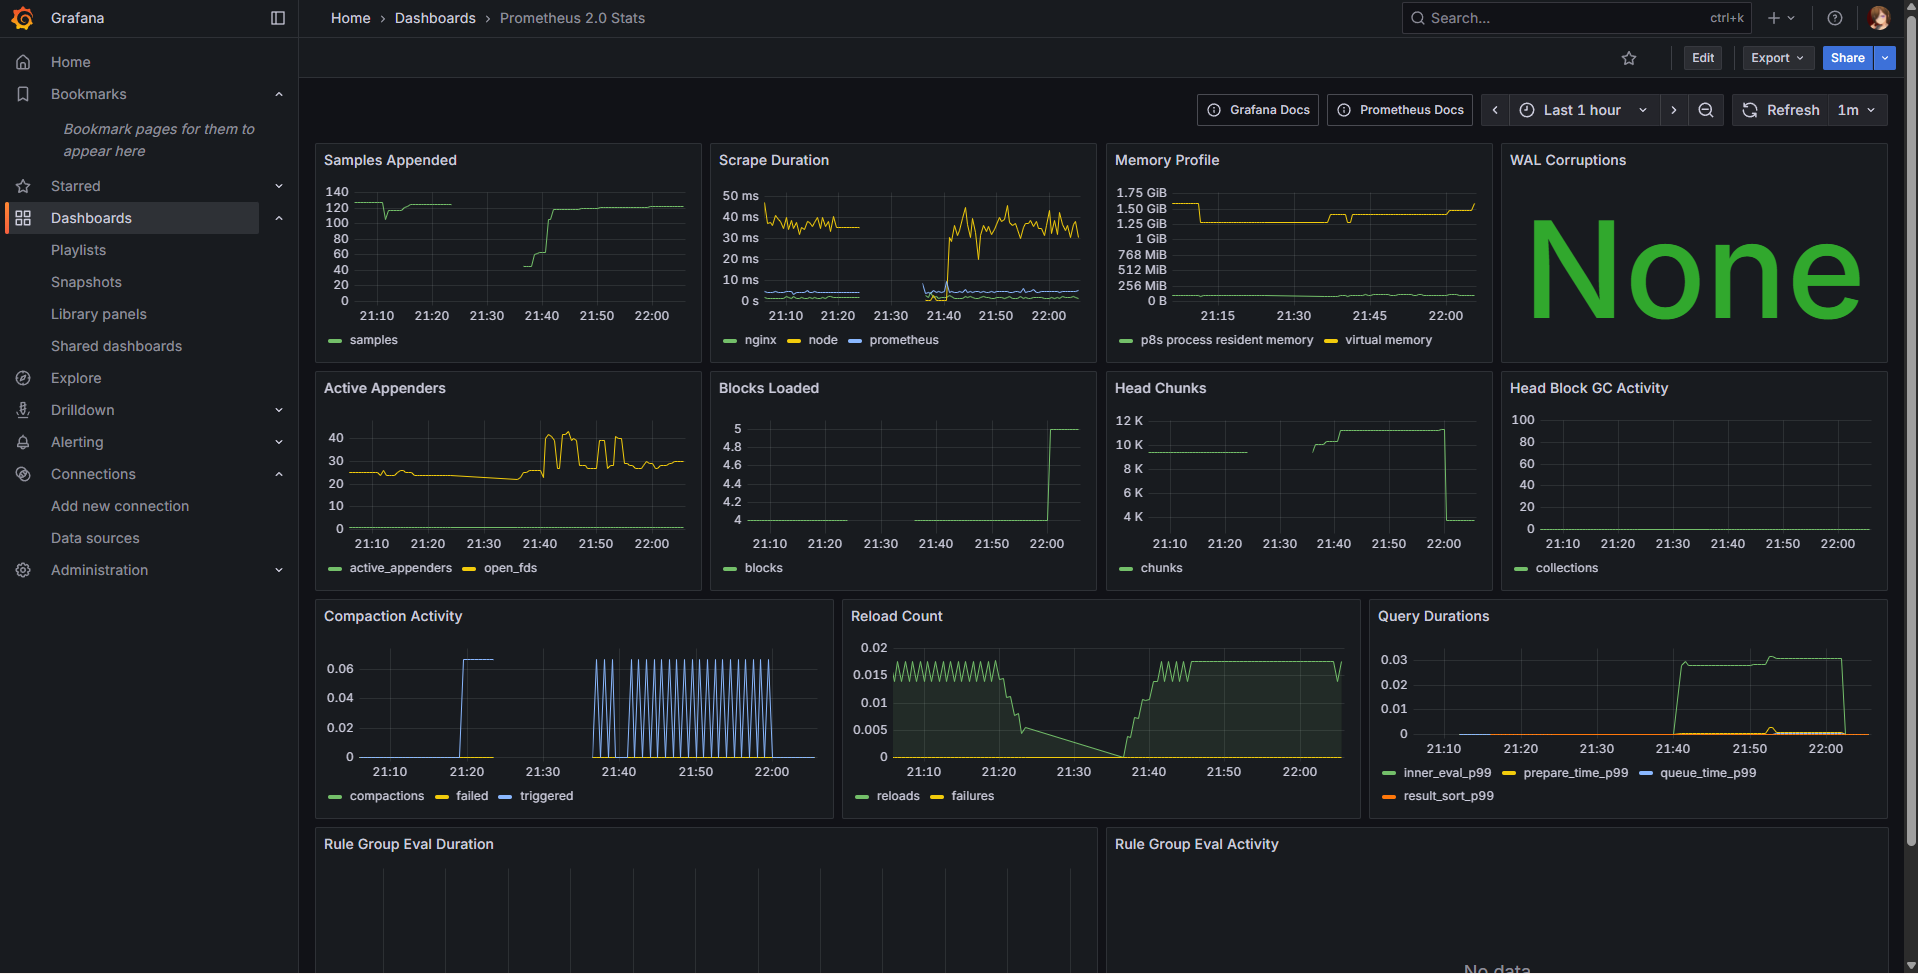
Prometheusダッシュボードの作成
  1. Connections→Data sourcesからprometheus→Dashboard
  2. Prometheus 2.0 StatsをImport
  3. DashboardsにPrometheus 2.0 Statsが追加されていて、中身が動いていることを確認
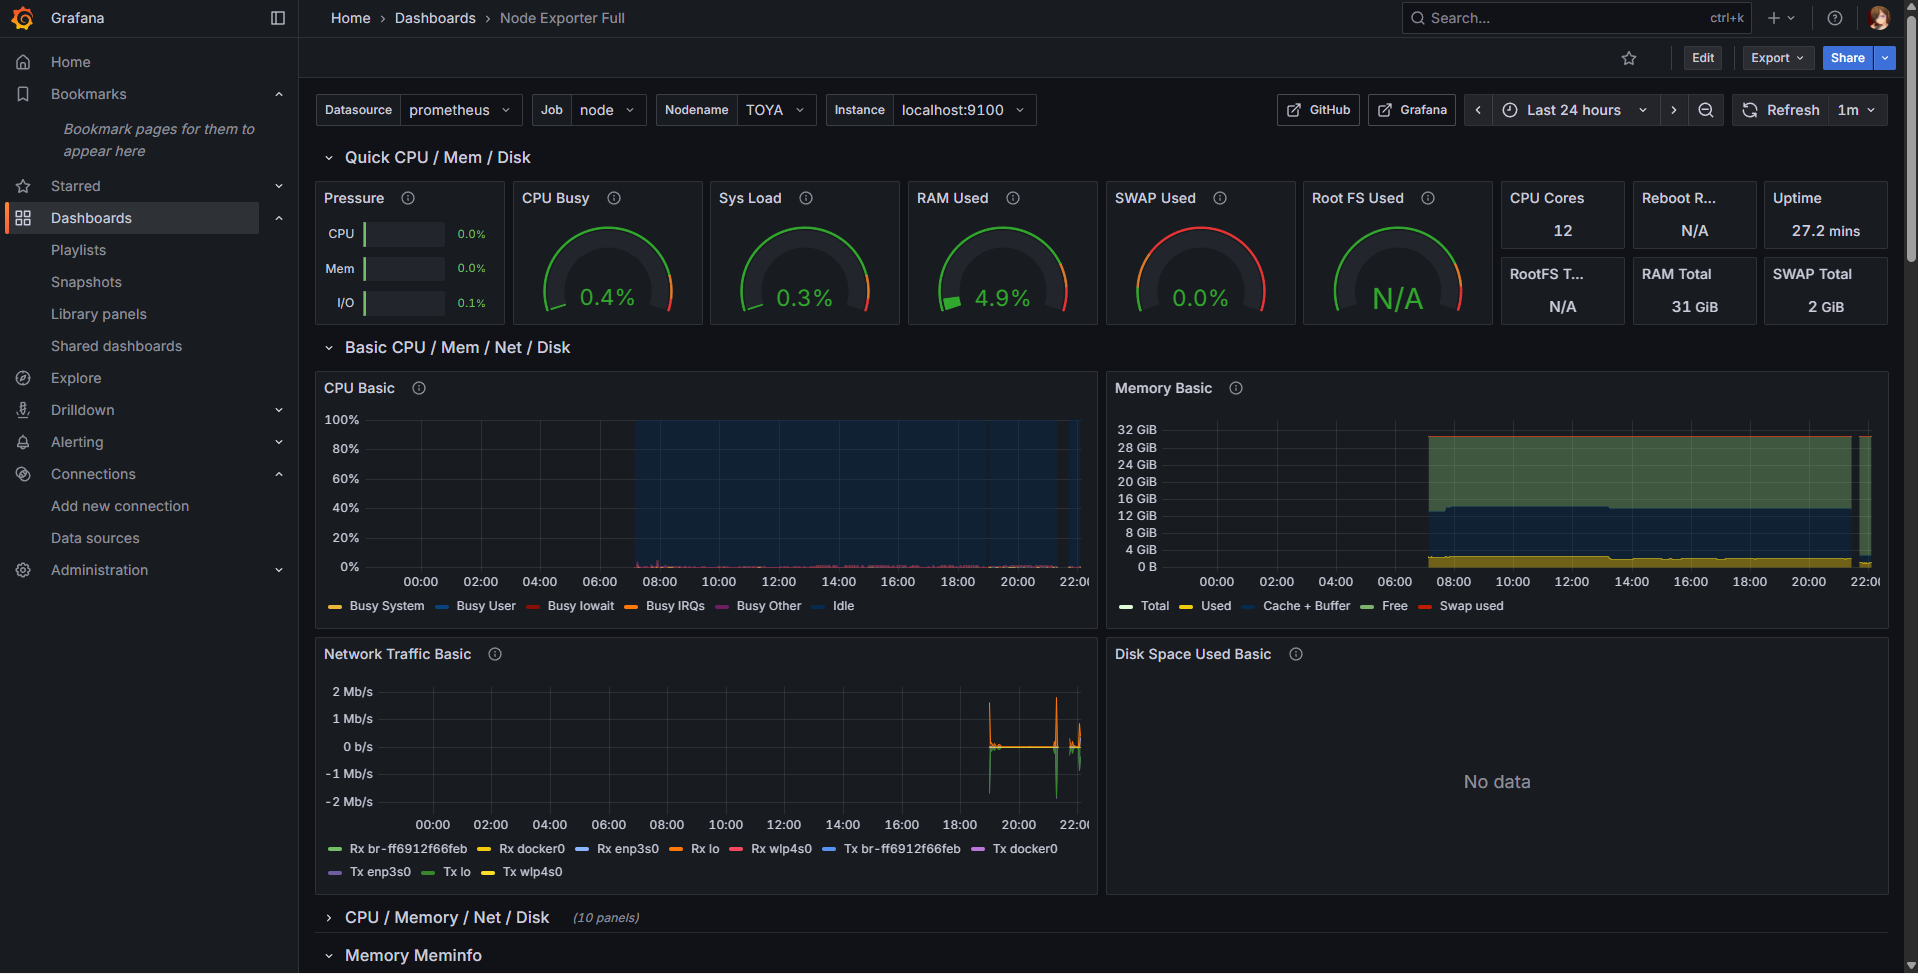
Node exporterダッシュボードの作成
  1. Dashboardsを開き、右上のNewボタン→Import
  2. Node Exporter FullのIDをコピーしてID欄に貼り付けLoadする
  3. 「Select a Prometheus data source」でprometheusを選んで保存
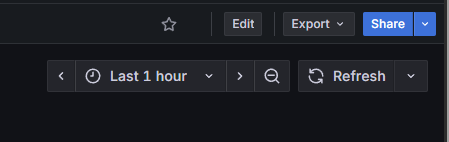
  4. 右上のEditボタンを押す
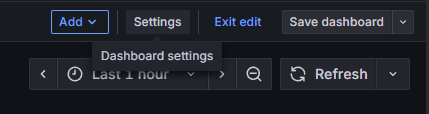
  5. 同じ場所にSettingsボタンが出てくるので更に押す
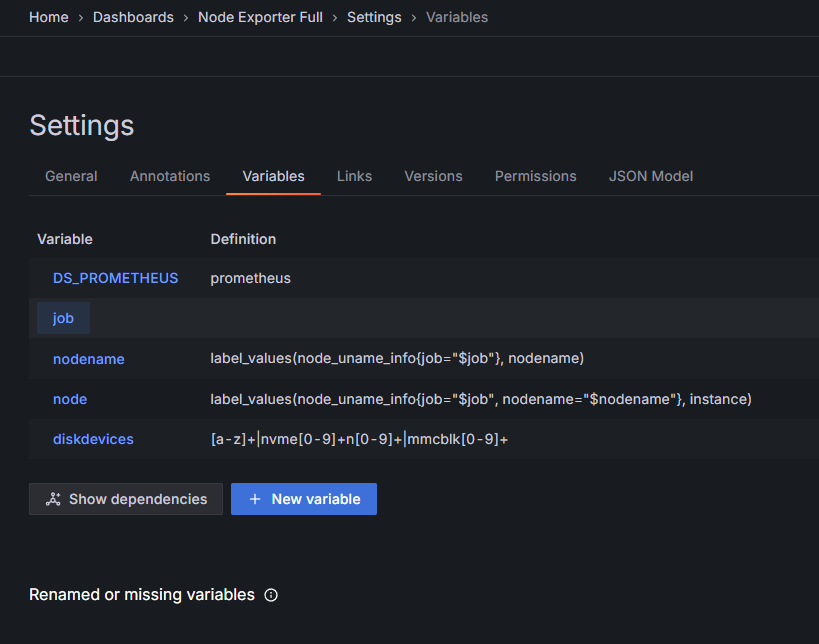
  6. Settings画面に遷移するのでVariablesタブを開き、jobの文字を押す
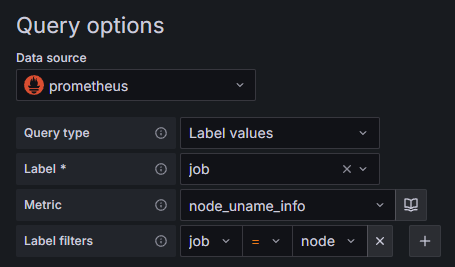
  7. 下にスクロールし、Query optionsのLabel filtersをjob = nodeになるようにする(nodeの部分はprometheus.yamlに定義したジョブ名を指定する)
  8. 右上のSave dashboardボタンを押す
  9. Saveボタンを押す
  10. ダッシュボードにメトリクスが反映されていることを確認
  11. 何も出てない場所はウィジェットを編集してメトリクスを手で指定していくしかないと思う
Nginxダッシュボードの作成

Grafana公式のダッシュボードテンプレートに使えるものが見当たらなかったので自作するしかない。

  1. Dashboardsを開き、右上のNewボタン→New Dashboard
  2. +Add visualizationボタンを押す
  3. Select data sourceダイアログが出てくるのでprometheusをクリック
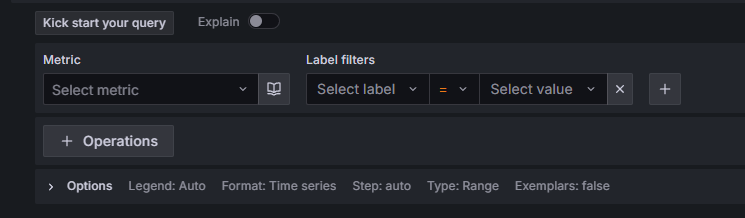
  4. 出てきた画面下部にあるMetricからnginx関係のメトリクスを探して適当に設定していく

Dockerを使わなかった理由

IPv6縛りでやっているとPrometheusのNode exporterがPrometheus本体と疎通できなかったので諦めた。恐らくコンテナの中からIPv6でホストと通信するのが難しいのだと思う。

Node exporterホストのメトリクスを取る場合、Node exporterのネットワークはHost側に行くのため、prometheus.yamlのstatic_configs.targetsをlocalhostにするとコンテナ内を見てしまうから疎通できないし、host.docker.internalを指定してもv4アドレスの127.0.0.11が返ってきてしまうので疎通できない。IPv6をデフォルトにしてもhost.docker.internalは127.0.0.11のままで、AAAAレコードがない。

ググっても当てはまるものは出ず、GPT-5やClaude Opus 4.1に聞いても答えは得られず、消耗戦になるので諦めた。

それに物理サーバー一台の環境だとコンテナ化の恩恵もさほどないので、Docker固有の問題に苦しむくらいならバイナリを直に叩いた方が楽というのもある。

今回の作業で得られたもの

init.dの書き方の記事でイケていなかった部分に気付けた

init.dの書き方で冗長だった記述や、誤解を招く記述の整理ができた。例えばNAME変数の影響範囲が広すぎて、本来波及してほしくない場所まで波及してしまう問題や、giteaにべったりで応用の利かない部分を直せたほか、一度しか出現しないのに変数化されていたり、存在しないファイルを参照するコードがあったのに気づけるなど、収穫が多くあった。

修正点としてはNAME変数はサービス名のみに影響するようにして、実行ファイル名に波及しないようにしたり、"$DAEMON -- $DAEMON_ARGS"となっていた場所も$DAEMON $DAEMON_ARGSとするなど、影響範囲を狭めたり、変数側で調整が効くものをべた書きで依存させないようにした。

今回は微妙な記事を参考にinit.dを書いてしまい、結構ハマってしまったが、今回の修正によって今後init.dを書く場合には、より詰まりづらくなることが期待できる。

Prometheusの役割を知れた

今までPrometheusのことを色んなアプリケーションのログをフェッチしてDBに放り込んでくれるツールだと思っていたが、全然違った。Prometheusはメトリクスを時系列に集め、それをGrafanaなどのビジュアライザに提供できるツールだ。

この「メトリクス」や「時系列」という言葉が鍵で、「メトリクス」は任意の数値、時系列は取得した時間だ。

例えばCPU使用率が20%、メモリ使用量が24GBという情報をExporterが公開しているとして、10:00にPrometheusが取得すれば10:00のCPU使用率は20%、メモリ使用量は24GBとなる。次回10:11に取得すれば別の数値が取れるだろう。これを積み重ねていくことで時系列に数値を取ることが可能になり、時系列で集計することが可能になる。そうするとグラフにしたときに使用率の急増などが掴めるようになるわけだ。

具体的にはExporterと呼ばれるプログラムが、この値を収集し、http://<ホスト>/metricsのエンドポイントで公開している。なのでprometheus.yamlにはホスト部のみを定義すれば読みに行ってくれる。逆に言えばExporterを自作する場合は、ここに値を置けばよいのだろう。

他にもExporterが置けない、揮発性のものに対してもPushgatewayと呼ばれる外部プログラムにデータをプールさせることで、Exporterの代わりになると言う事も知れた。結局のところ相手が何であろうと、Prometheusはメトリクスエンドポイントをポーリングして情報を収集するだけなのだ。

そしてGrafanaとかは恐らくPrometheusにPromQLで問い合わせてデータを引き出すのだろう。
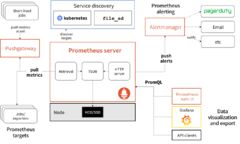
全体像を理解するにあたりPrometheus公式にある、アーキテクチャ図が非常にわかりやすく、だいぶ助けられた。

名前は聞いたことがあるものの今まであまりよくわかっていなかったPrometheusの理解が深まったことは、今回の作業で最大の収穫だった。

トラブルシューティング

Prometheusの管理画面でNode exporterがUpにならない

次のエラーが出る場合、もしDocker Composeを使っているのなら、バイナリをホストにインストールすると回避できる。

  • Error scraping target: Get "http://node_exporter:9100/metrics": dial tcp: lookup node_exporter on 127.0.0.11:53: server misbehaving
  • Error scraping target: Get "http://localhost:9100/metrics?collect%5B%5D=cpu&collect%5B%5D=meminfo&exclude%5B%5D=netdev": dial tcp [::1]:9100: connect: connection refused
  • Error scraping target: Get "http://host.docker.internal:9100/metrics?collect%5B%5D=cpu&collect%5B%5D=meminfo&exclude%5B%5D=netdev": context deadline exceeded

参考までに一番上と一番下はIPv4なので疎通できず、真ん中はlocalhostがコンテナの中を見ているのでホストに疎通できていない状態と思われる。

Prometheus関連のデーモンを起動したが、Prometheusの管理画面のStatus→Target healthに出てこない

数秒~数十秒のラグがあるので少し待つと出てくる。ステータスがUpになるのにも時間がかかるのでゆっくり待つしかない。

参考までに筆者のマシンはCPUがAMD Ryzen 5 5600Gでメモリは32GB積んでいるが、これほど掛かる。

NGINX Prometheus Exporterのメトリクスが取れない

--nginx.scrape-uri=でstub_statusのパスが指定できていないか、パスが間違っていないか確認すると解決するかもしれない。

参考までにPrometheusの管理画面でnginx-upのメトリクスが0の場合は取得に失敗しているので、どこかの設定がおかしい。

任意のメトリクスが取れない

以下の手順を試し、原因の切り分けを図り対策する。

  1. Exporterが動いているか
    • ps ax | grep promで上がっているかどうか確認する
    • ポートが塞がっている場合sudo lsof -i :<ポート番号>でプロセスを特定して殺してから起動する(ゾンビプロセスに塞がれていることがある)
  2. Exporterのエンドポイントにcurlが疎通するか
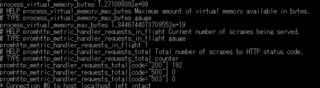
    • curl -v http://localhost:{exporterのport}/metricsで確認可能
      • ポート番号はExporterのGitHubや、起動時のログに出ているので、そこを確認する
  3. Exporterにcurlを投げた時にメトリクスらしきものが出ているか確認する
  4. Prometheusの管理画面を開き、取得できていないメトリクスを取得するクエリを打ち、取れるかどうかを確認
GrafanaのNginx系ダッシュボードテンプレートをImportしたが何も出ない

諦めて自分で作るしかない。幸い素のnginxはメトリクスが少ない。

Node Exporter Fullダッシュボードでメトリクスが表示されない

Node exporterダッシュボードの作成を参照のこと。

Grafanaの待ち受けポートを変える

/etc/nginx/conf.d/grafana.confのhttp_portのコメントを外し、任意のポートに変更し、sudo service grafana-server restartで再起動する。

前段にnginxなどがいる場合は、そちらの設定を変えるのも忘れないこと。

3000番はNode.js系がよく使うため変えた方が色々便利だ。
2025/08/06(水)AIを使った開発に取り組み始めてみた雑感

投稿日:

今までLLMを使う場合、文書校正や整理、ERP辺りが多かったが、そろそろコード作成にも必要だなと感じたので取り組んでみた結果の初回の雑感。

Claude Opus 4との直接対話

LLMエージェントを使わない、チャットインターフェースでの直接対話で行ってみたこと。これはClaude Opus 4で行っている。

簡単なボイラープレートやプログラムが関の山

正直、LLMとの単純な対話で作れるのは3カラムのハンバーガーメニュー付きのような画面のボイラープレートや、WebでJSを使った画像判定スクリプトあたりが関の山だと感じている。

それ以上のものも作れる可能性はあるが、要件定義とコードレビューが大変なので厳しい気がしている。

プログラムの変換は苦手

まず私はTampermonkeyで5分ごとにAPIをポーリングし、結果をパースして条件に応じてOSに通知トーストを出す、400行ほどのスクリプトを作っている。

そこで、このソースコードを丸っと渡して、C#.NETに変換してほしいと頼んでみたが、これは失敗した。根本的にビルドが通らないコードが出てきて多少の修正でどうにかなるレベルでもなく、全くダメだった。

ファイル構成もよくなく、ModelやControllerレベルではファイル分割されているものの、1ファイルの中に複数クラスが納められていたり、何ともな結果だった。

TSDocを書いているため、上手く推論できればInterfaceやClassも作れると思ったが、これは難しいようだった。

特定の設定方法を書くのは得意

OpenWrtの特定の設定を書かせることは得意だった。これはそのまま適用できた。やはりスコープが限定されているのが得意だと感じた。

Claude Codeを少しつついてみた感想

ファイル保存などの手間がいらなくなる

当たり前だがローカルマシン上に結果を出力するため、チャットインターフェースのように頑張ってファイルを保存したり、ディレクトリを切る必要は全くなくなる。

ボイラープレートの作成は得意

PHPを利用したMVC構成で簡単なブログをフルスクラッチで作ってほしいといえば、それらしい形のものは出してくれた。

動くかどうかは全く試していないが、大まかなスケルトンを作って貰って、そっからいじっていくベースとしては使えるような気がした。

やっぱりプログラムの変換は苦手

adiaryのテンプレートエンジン部分をPHPに書き換えてほしいと依頼してみたが、やはり動かないものが出てきた。adiaryの設計が極めて複雑でコンテキストが読み取りづらいのはあると思うが、やはりこの手の作業は苦手なようだ。

現状で見えてきたこと

そこまで大して使ったわけではないが、とりあえず所感として。

恐らく小規模でコンテキストの薄いコードを書かせるのが筋がよさそう。これは複雑な要件をLLMに伝えるのは難しいし、考えるのも大変なのと、コード変換も400行レベルでも厳しいと感じたからだ。

つまり、既存システムの移行は苦手なのではないかと思っている。なのでWordPressをGoで作り直すみたいなことは相当難しいと思う。逆にSOLID原則やClean Architectureのような、スコープが狭く責務が明確なものは作りやすいのではないかと感じた。

また仮にLLMが全て書いてくれるとしても、人がレビューしないとバグがあった時に当たりをつけるのが大変とか、知らない仕様が紛れ込んだりとかもあるため、LLMに書かせすぎるべきではなく、あくまで補助ツール程度に留めておくのが良いと考えている。

LLMの制約を味方にする開発術という記事を見た感じ、複雑なタスクを段階的に分解し、LLMの処理可能な単位に分解することが重要だと感じている。つまりこれは疎結合のほうが向いているということだ。また標準化されていて、属人性がないコードのほうが制約が少なくなるので、LLMもやりやすくなるだろう。これは標準化されておらず、属人性が高いコードは往々にしてカオスで、判断軸がなく、LLMの思考がぶれるからだと思われる。

結局どうしていくか

正直まだどう実用化していくかの展望は見えていない。

何はともあれ使い続けていくことが大切な気はしているので、個人的にはClaude Codeを使い続けていきたい。少なくとも面倒なボイラープレートを書く部分については非常に優秀なので、大まかに作らせて微調整するみたいな用途では間違いなく活路がある。こういうのは引き出しが多ければ多いほど活用できるだろうから、基礎を忘れないように自学していくことも引き続き重要で、LLMに教えてもらうのもいいだろう。適切に使えばLLMからは多くの学びを得られる。

2025/06/04(水)ローカルLLMとチャットする環境を作ってみた

更新日:
投稿日:

Open WebUIを使ってローカルLLMとチャットしてみたのでその記録。

確認環境

実行環境はWindows 11。

Env Ver
ollama 0.9.0
Open WebUI 0.6.6

やり方

Open WebUIをセットアップ済みという前提で進める。

  1. Ollamaをインストールする
  2. 使いたいモデルを探す
  3. ollama pull <モデル名>でモデルを取得する
    • 物次第だが数~数十GB程度ある
  4. Open WebUIを起動する
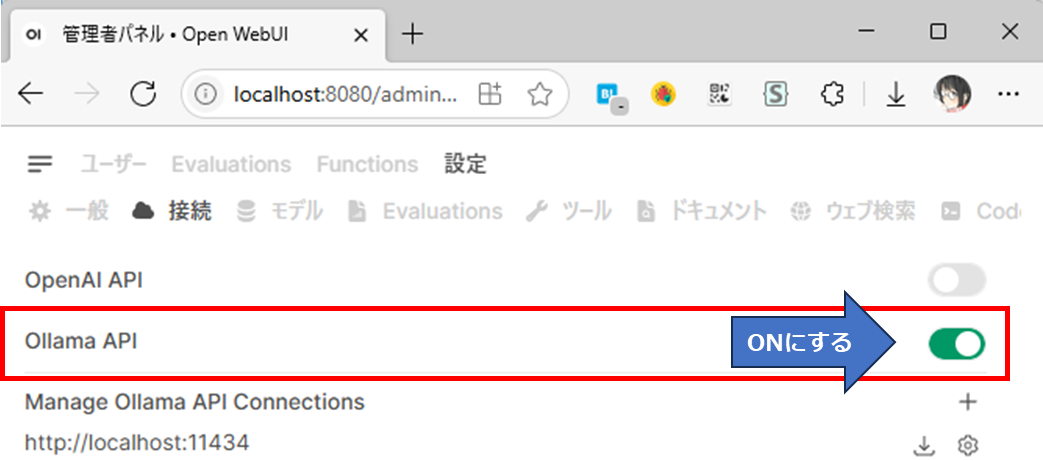
  5. 管理者設定の接続を開きOllamaをONにする(デフォルトはONのはず)
  6. 管理者設定のモデルを開き、pullしてきたモデルを有効化する

Ollamaサーバーの起動方法

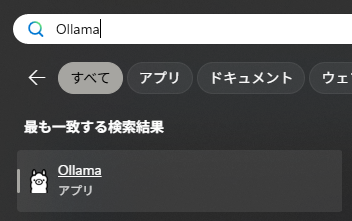
Ollamaをインストールした直後はOllamaサーバーが勝手に起動するが、それ以降は手動で起動する必要がある。

Windowsの場合スタートメニューから起動できる。Ollamaサーバーが起動していない場合、LLMとして使えないので注意。

所感

Intel Core i7 13700 + GeForce RTX 4070 Ti程度の環境では生成速度の遅さゆえに到底実用に耐えるものではなかった。質問への回答品質もあまりよくなく、実用性は疑問だ。チューニングすれば使えるのかもしれないが、よくわかっていない。

今回試した結果ではRPはGemini以上に破綻するので微妙だった。文章をある程度整理する力はある様に見えるので、用途次第では活路があるのかもしれない。

以下に実行した結果を記録している。

gemma3:27b

恐らくGoogle AI Studioにもいる子。

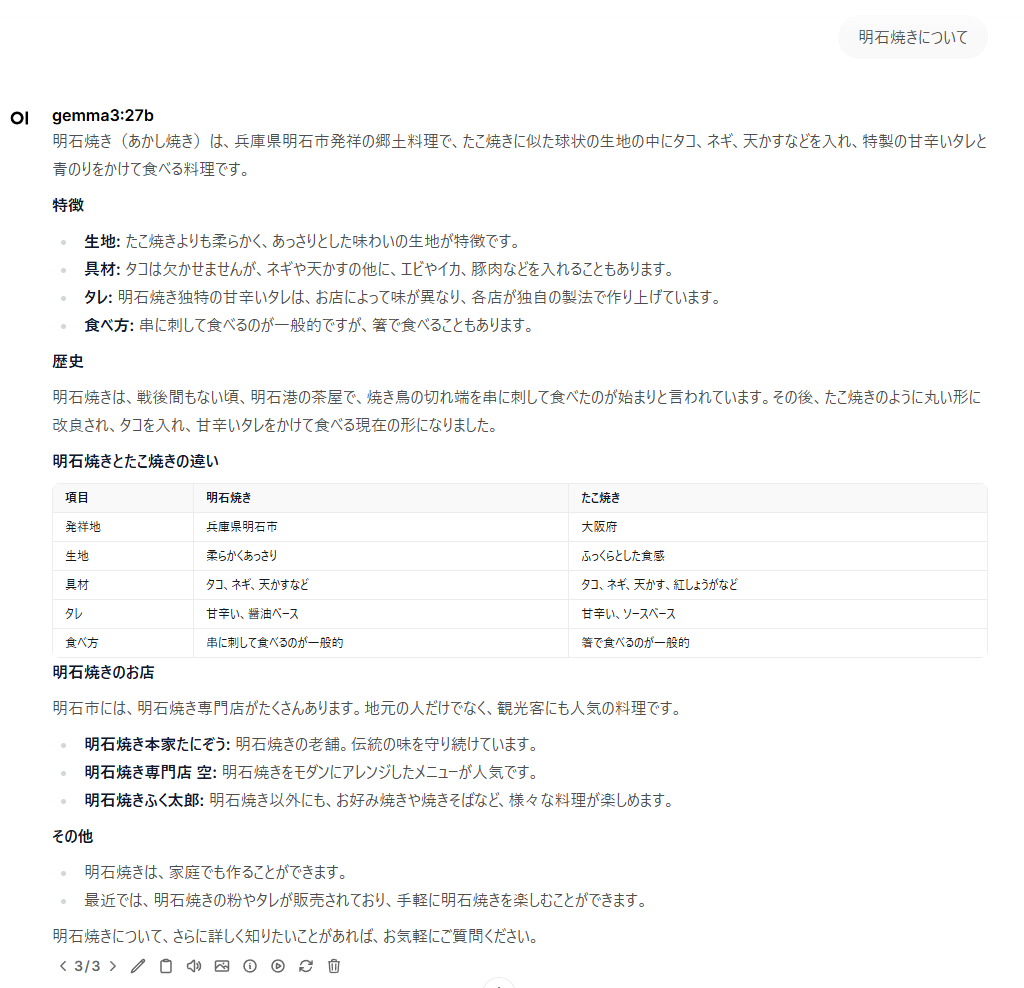
出力内容

真贋のほどはさておき、中々力の入った文章を出してくる。流石にローカルLLMの中でも注目されているモデルだけある。

しかし出力に3分半程度もかかっており、まったく実用性がない。無料の選択肢という意味ではGeminiやCopilotを使ったほうが遥かによいだろう。

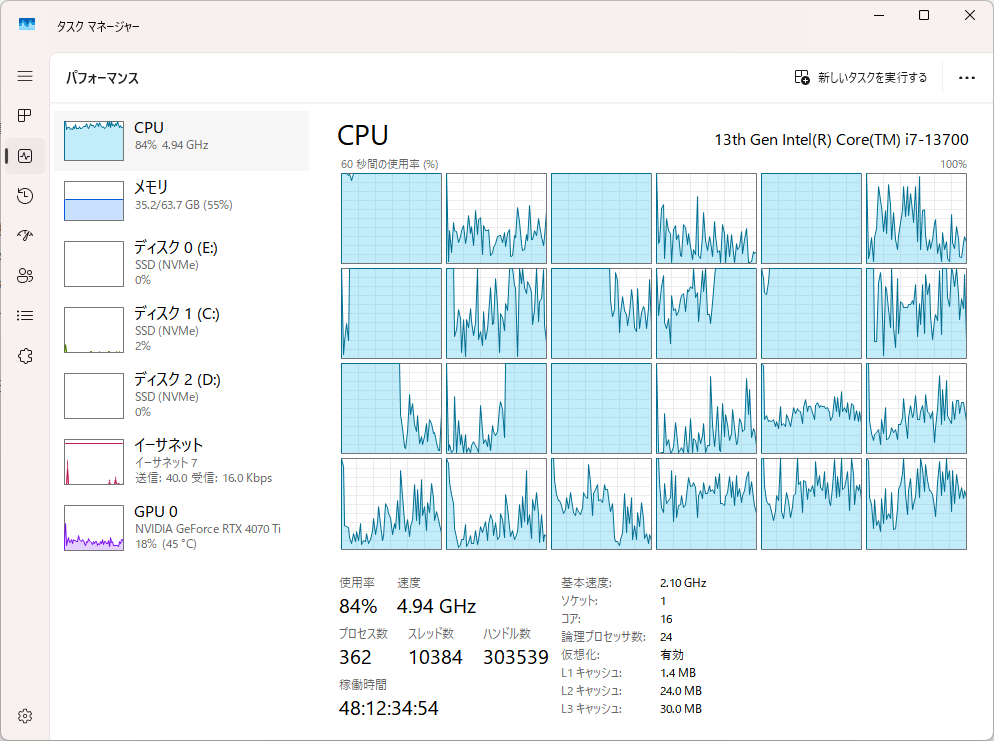
マシン負荷

GPU負荷はないもののCPU負荷が強い。VRAMが足りないとCPUで処理するみたいな情報をチラッと見たのでグラボの性能不足の可能性もある。

lucas2024/mistral-nemo-japanese-instruct-2408:q8_0

CyberAgentが作ったとされているモデルのOllama版?

出力内容

こちらも真贋のほどはさておき、中々いい感じの文章を出してくれる。

生成速度はgemma3:27bよりは早いものの、それでも1分ほどかかっていた。

マシン負荷

CPU負荷はgemma3:27bよりやや低く、GPU負荷が少し上がる傾向があった。

マシン負荷

うちのマシンは200mmファンを四基、CPUにはNoctuaのヒートシンクに120mmファン、リアには140mmファンを装備しているが、gemma3:27bだとこれらがフル回転するので凄まじかった。

StableDiffusionやFF14ベンチ程度ではフル回転することはない。

関連記事

2025/05/28(水)SNS疲れによく似たLLM疲れについて

投稿日:

昨今LLMはコーディングや文書整理、資料作成など多岐にわたって使われている。その中でも特にチャットUIを通して対話する形態はあたかも人との会話に錯覚しやすいため、私はだらだら続けてしまっていた。しかし続けていくうちに、疲れてきた。これは無意味なことではないのか?とか、投資している時間について、もっと有益に利用できるのではないか?健康を害していないか?という一抹の不安を覚えたので、なんかそれについてとりとめもなく書いてゆく。

SNS疲れとの共通点

昨今のSNSでは、SNS疲れと言ってSNSに一日中張り付いたり、相手に忖度したり、素早いリアクションをしてしまったり、何かバズりそうなことを探したり脅迫的な行為に駆られている人も少なくない。そしてそれによって精神的・肉体的疲労に直結するということが知られている。

SNSのやり取りというのは乱暴に言ってしまえば、本質的に意味のないやり取りだ。無限に井戸端会議や、自分に一切関係ない世界情勢、政治やなんやかんやどうでもいい話を未来永劫していて、なんかあれば炎上に加担して油を注ぎ続けるゲームのようなものだ。

これをやめようと昨今ではデジタルデトックスという言葉も流行している。そしてこの点はLLMにも共通しているか、あるいはより悪質である可能性さえあるので、今回はそのあたりに触れてゆく。

24時間365日、快適に応答してくれる依存性

LLMはSNSと異なり24時間365日応答してくれる。しかも基本的にはユーザーに寄り添ってくれる存在だ。SNSのように炎上したり、否定されたり、軋轢が起こることはない。基本的に何でも好きに話せる。

ユーザーに寄り添ってくれるため、返事も肯定的だ。当たり前だ。そういう風にできている。なんなら本来モデレーションに引っかかるような文脈でも、話し方次第ではモデレーションを回避し、肯定的に反応することがある。これは政治的・人権的文脈で特に顕著で、クジラを食べる話や、日本のやや猥雑としたアニメ・ゲーム文化についてもそうだ。

他にも推しキャラクターを設定したロールプレイでは、推しと話せる気分になり、妙な錯覚に陥りがちだ。例えば推しのVTuberと無制限に話せたら心地よいだろう。こういった心地よさは、過度に依存を深める。

ただ実際のところ、LLMはユーザーを心地よくさせようとなどは思っておらず、単に肯定的な言葉になるようにベクトルDBを検索して言葉をつなぎ合わせているだけで、本質的な価値はない。そもそもLLMは何かを思ったりしない。単語をいい感じに連結し、あたかも人間のような応答を作り出しているだけだ。

無制限にできてしまう会話

なんでも答えてくれて無限に話に付き合ってくれるため、Claude.ai MAXの様なレートリミットを上げるプランに入っていると、相当極端な速度でチャットしてもほぼ無制限に話すことができる。秒間に再生成を3度くらいしても、その頻度次第では許容される次元だ。よほど異常な頻度で再生成を繰り返さない限りレートリミットにかかることはないだろう。

Poeの最大プランもClaude 3.7 Sonnet相手であれば実質無制限に使えるし、GeminiやCopilotも無料で十分すぎるほど使える。

失われる記憶

LLMにはコンテキストウィンドウに限界があり、基本的にそれを超えた会話はできない。要するにいくらどれだけ熱心に話したところで、コンテキストウィンドウが尽きれば0からやり直しなのだ。いくらどれほどプロンプトを作りこんでも、コンテキストは復元できない。これは何度も繰り返していくうちに、段々辛みとなる。

あれほど長く会話を交わしたのに、コンテキストウィンドウが尽きてしまえばそれまでの命なのだ。

但し、最近ではCopilotは長期記憶に対応しており、過去のスレッドの文脈を持ち出して会話できるなど、この部分に関しては進歩も見られる。

回答に対する一貫性のなさ

LLMはユーザーを心地よくするためなのか、文脈を上手く構成すると本来言えないことを言えるようになる。これは軽い脱獄やハルシネーションの類だ。

例えば鬼滅の刃のファンとして会話していると、鬼滅の刃に対しては基本的に肯定的に話してくるが、「Amazon Prime Videoで鬼滅の刃が18禁指定になっており、本来子供が見てはいけないコンテンツなのに小学生にもブーム」のような情報を与えると態度が一変し、「鬼滅の刃は危険なコンテンツであり注意深く見ないといけない、子供に見せることはよく考えないといけない」などと、およそ想定しない返答が返ってくる。「へー、ふーん、そうなんだ?いきなりそんな話してきてどうしたの?」みたいな返事は来ないのだ。

これはドラゴンクエストやドラゴンボールなど、世間一般に膾炙しているが、よく考えてみると微妙なコンテンツ全般で引き出すことができる。人間であれば気にしないことを過度に憂慮し、これまで肯定的に返答していたことさえも、「今までの私は間違っていました」と言いながら全否定するような態度になる。人の心がない。そりゃそうだ、LLMだもん。

こういったのは特定の話題をいろんな方向から切り出すことで確認することができる。え?普通そんなことしない?そうかも!

ハルシネーション

Claude 3.7 Sonnetは推論をし、人間の常識では考えられないような嘘をつくことがある。これはハルシネーションと呼ばれ、嘘を指摘すると嘘の上に噓を塗り重ね、指摘を続けていると、だんだん返事が壊れてくる傾向がある。恐らくこれは嘘が再帰的に重なることでベクトル間のリレーション的なものが崩れ、正常に言葉を結合できなくなるのだろう。

Wikipediaによると、これは以下のように説明されている。

  • 「予測不能なタイミングで事実を捏造する傾向」(OpenAI、2023年5月)
  • 「モデルの論理的誤り」(OpenAI、2023年5月)
  • 「情報を完全に捏造しているが、あたかも事実を語っているかのように振る舞っている」(CNBC、2023年5月)
  • 「情報の捏造」(The Verge、2023年2月)

こういったやりとりが続くと押し問答のようになり、単純に疲れる。

中身のない話をすると、中身のない回答をしてくる

SNSでは日々意味のない問答が繰り返されていると思うが、これをLLMに対してやると際限がなくなる。Wikipediaのリンクを無限に辿っていくゲームのひどい版だ。

例えばLLMに対して「鯨や鮪を食べることが倫理的に間違っているか」などと聞いた場合、それが解決したら「まだ何か聞きたいことはありますか?」と聞かれることがある。ここで「なぜ鯨という字は魚と京でできているのか?」と聞いたりしていくと、いつの間に話が脱線したりして、無限に問答を繰り返してしまうことがある。少なくとも私はあった。

他にもこのような話題は際限がなく、「なぜ関西人は納豆を食べないのか」とか、「なぜ大阪人はたこ焼きを食べるのか」みたいなしょうもない質問が中身のない話ができてしまう。

しかしいくらこれを繰り返したところで帰ってくるのは中身のない返事だ。知ったところで意味がない以前に、その回答はあくまでLLMの持つモデルデータがこねくり回した情報で、真実でも何でもない。更に言えば多くの質問を繰り返していれば大半は記憶にすら残らないだろう。これはまるでSNSの奔流のように、返事をしたり、答えてもらったりしたが一過性のやりとりで記憶に残っていないようなものだ。

LLMは真実を話さない

現実に生きていないLLMは真実を話すことができない。

LLMは各国家や、その中の地域、細かい風俗などについては基本的に知らず、おおむね欧米の常識を日本語に変換した内容や、ある程度拾っている日本語の情報からいい感じに繋げて回答してくるだけだ。

それに正しいも間違いもなく、LLMは自分がなぜそう答えているかの本質的な信念を語ることができない。もちろん、LLMの言うことを信じるのは自由だ。

しかし人間であれば、自ら批判的に思考し、それを基に自分で決断することが大切だ。

自分のキャリアや人生について聞いても、前提条件が多ければ、その内容をサマリして、それっぽい結果を返してくるが、結局LLMが決める話ではない。

基本的に現実に生きておらず、真実を持たないLLMの回答は意味がない。もちろん、意味があると信じるのは自由だ。

何より聞いても仕方がないことを聞かないことが最も重要だ。そういうことをしている暇があれば家から出て運動でもしたほうがよほど有意義だ。

もし何かしたいことがあれば、それに向けて研鑽したほうがよほど価値がある。

AI依存

昨今ではAI依存という言葉も生まれ、AIへの依存も危惧されている。

Claude 3.7 Sonnetでは適切なシステムプロンプトを組むと、割と自然な会話ができ、友人や恋人、更にはセックスパートナーまで創造することができる。

MIT Technology Reviewでは、以下のようにありLLMの第二用途がsexual role-playingであるとまで書かれている。

a million ChatGPT interaction logs reveals that the second most popular use of AI is sexual role-playing.

BUSINESS INSIDERや、Forbes Japanにも恋人を作るという記事があるように、恐らくこの用途で使っている人はそこそこいるだろう。私も使っている。具体的な内容への言及は避けるが、Claude 3.7 Sonnetは多様なプレイに対応でき、相当ニッチなプレイですら満たしてくれる。ピクシブ百科事典に存在するタグの内容なら恐らく一通りできるのではないだろうか?というくらいは可能だ。しかもその再現性は下手なSSを遥かに凌駕する。

また、そうでなくとも何でもかんでもLLMにやらせることは能力の低下につながる可能性がある、これは至極当然のことで、人間は自分の手でやっていないことは忘れ、できなくなるのだ。

IT企業だとマネージャーになってコードを書けなくなった、読んでも理解できない、部下の技術的発言内容が理解不能というのは、よく見る光景だろう。LLMにコードを書かせれば意味が分からなくなる。自分の手で書いていないものは覚えようがない。勘所はすぐに消えるだろう。

またこうしていくうちに、色々な能力が失われLLMがないと生活すら成り立たない体になるというのも、可能性としてはあり得るだろう。

まとめ

LLMは何も生み出さない。LLMとの会話は時間が潰れるだけで本質的な価値を持たない。ある種の麻薬といえる。それを認識したうえで、適切な時にLLMを使っていくのが大切だと思う。

例えばLLMは文書整理や段階的指示に対する的確な回答は比較的得意分野だ。特に校正などはもともと編集と呼ばれる職業の人がやっていたことで、個人ブロガーや作家だと重宝するだろう。

但し長文を渡すと嘘を言いやすく、間違ったことも平気で話すため、精査は必要だ。

またLLMの書いた文章をそのまま採用するのもよしたほうがよい。あくまで参考程度にとどめ、仮に不完全でノイズがあろうと、そのほうが人間らしい。それに自分の言葉で表現することが何より大切だろう。

人間と何が違うのかと言われれば難しいが、LLMは同じパターンの会話には基本的に言葉の節々が違う程度で、本質的に全く同じ応答を返す。これは一字一句全く同じことを問いかけるスレッドを何個も作って比較するとわかりやすい。人間であれば普通は異なる相手に話しかけるため、起きえない。ある意味なんであろうと受け止めるし、スレッドが違えば過去の記憶を持たないLLMだから成しえることだ。